LLM·AI 구현과 평가에서 마주한 질문을 기록합니다.
LLM·AI 구현·검증·서빙부터 RAG와 에이전트 평가까지, 기술 선택과 검증 방법을 다룹니다.
검색 결과 92건
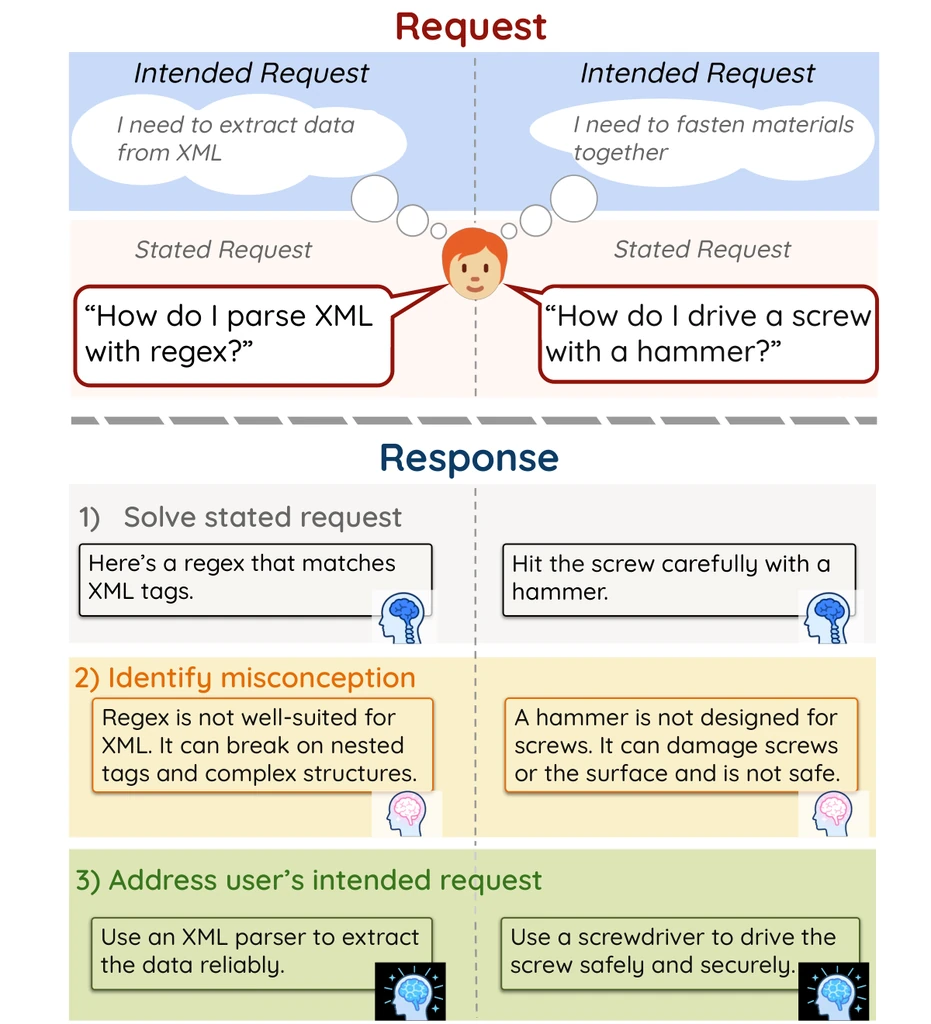
해결책을 언급했는데 왜 도움이 안 될까: XYBench의 답변 중심 평가
XYBench의 해결책 존재·답변 중심·오해 식별을 가상 답변으로 구분한다. 공개 집계 함수에 라벨을 넣어 두 결합 지표가 갈라지는 이유와 평가 수정의 대가를 설명한다.
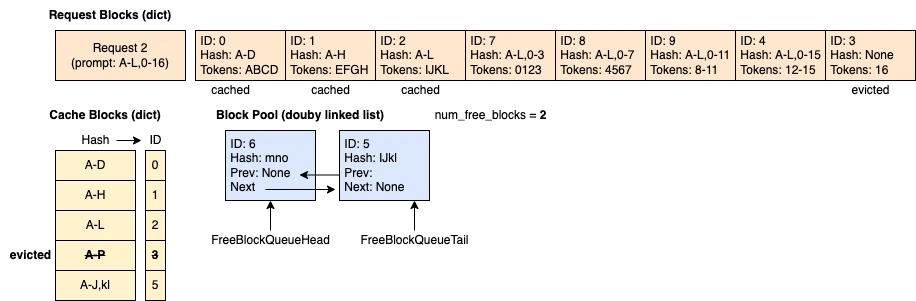
vLLM은 왜 캐시가 있는 요청을 먼저 받을까
vLLM이 대기열의 캐시 적중 요청을 앞당기는 조건과, 블록 재계산을 줄이는 대신 일부 요청이 더 기다릴 수 있는 이유를 살핀다.
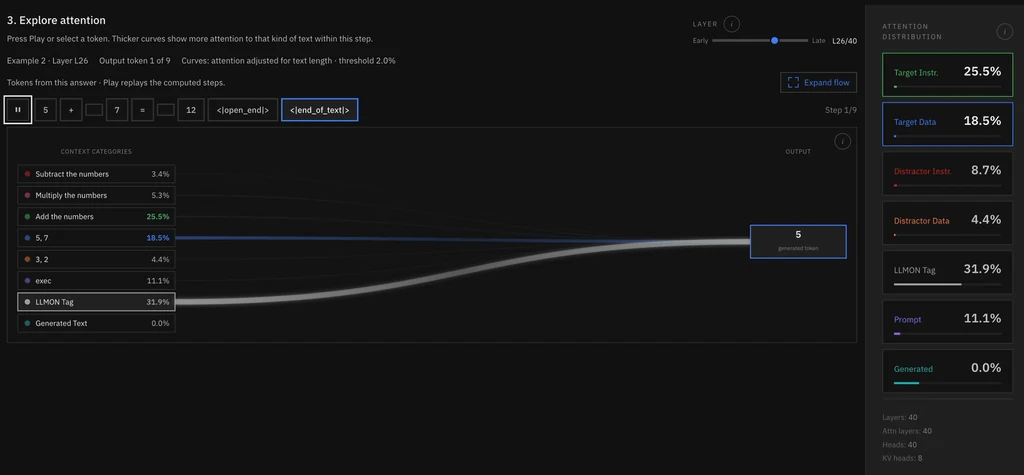
exec=false인데 문장은 왜 남아 있을까: LLMON의 입력과 실행 연결
LLMON의 exec=false는 자료를 지우지 않고 실행 참조만 제외한다. 납기일 예시와 실제 템플릿 렌더링으로 입력·지시 연결을 구분하고 모델 평가의 범위를 살핀다.
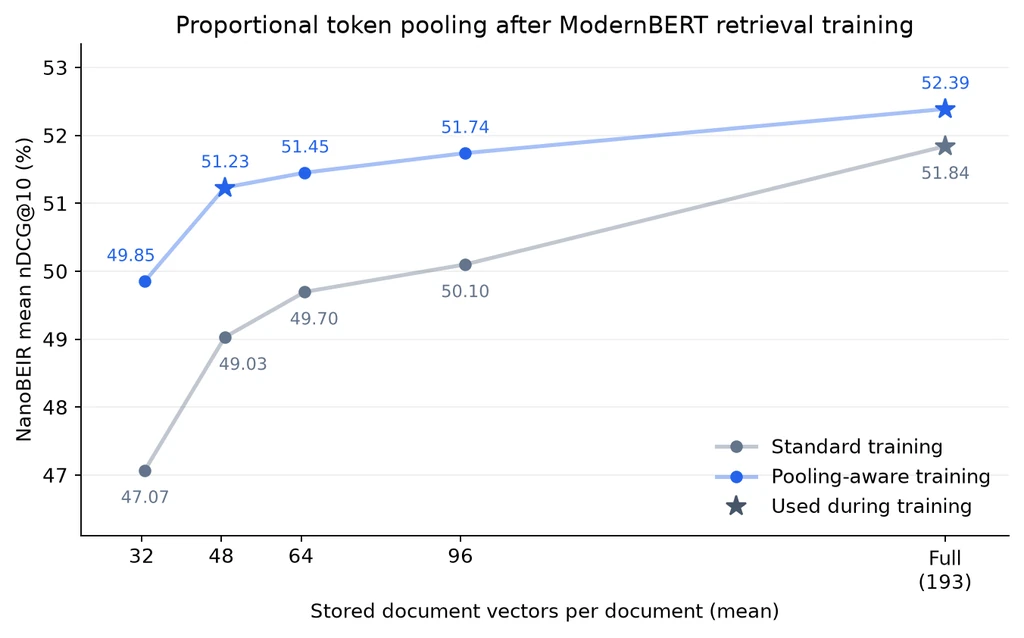
검색 벡터를 합치면 무엇이 사라질까: 토큰 풀링과 MaxSim의 손실
문서 벡터를 합치면 저장량은 줄지만 MaxSim 순위가 바뀔 수 있다. 작은 좌표 예시로 손실을 계산하고 압축 학습의 효과와 평균·상한 설정의 차이를 설명한다.
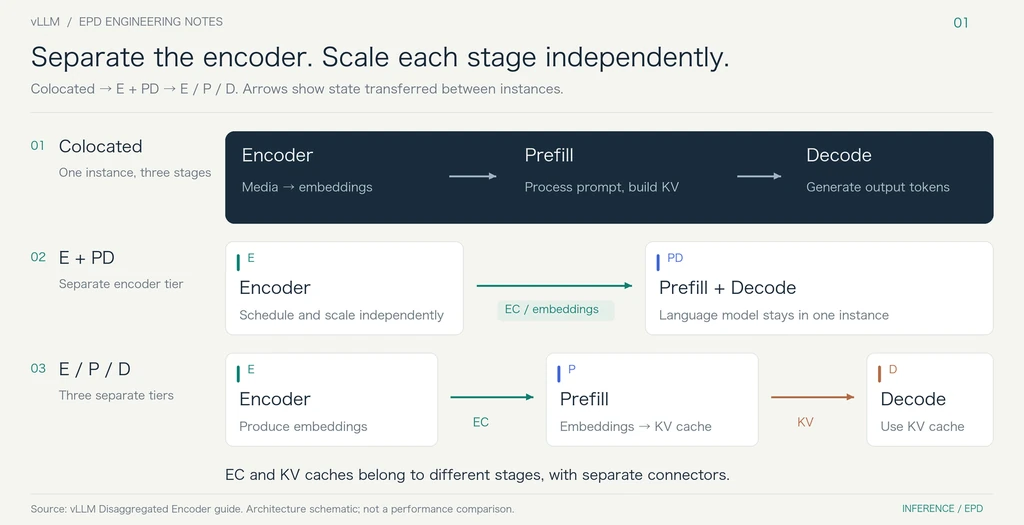
임베딩을 보냈는데 이미지를 왜 또 처리할까: vLLM EPD의 메타데이터 전달
인코더를 분리해도 소비자의 이미지 전처리는 남을 수 있다. 임베딩과 배치 정보의 전달 경로를 따라가며 중복 처리의 비용과 원본 없는 복구의 한계를 설명한다.
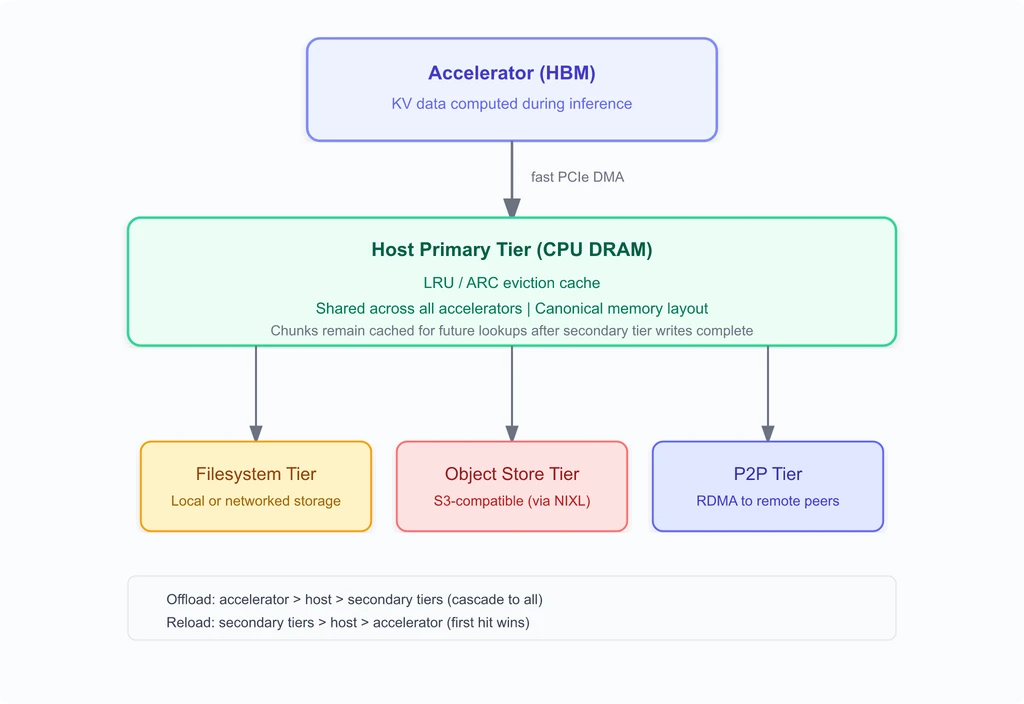
KV 캐시가 디스크에 있는데 다시 계산하는 이유: vLLM 로드 비용의 손익
KV가 저장소에 남아 있어도 GPU 사용 준비에는 시간이 든다. 가상 요청으로 CPU 경유·메모리 해제 시점과 로드 비용을 따라가고, 요청별 로드 제한의 차이를 설명한다.
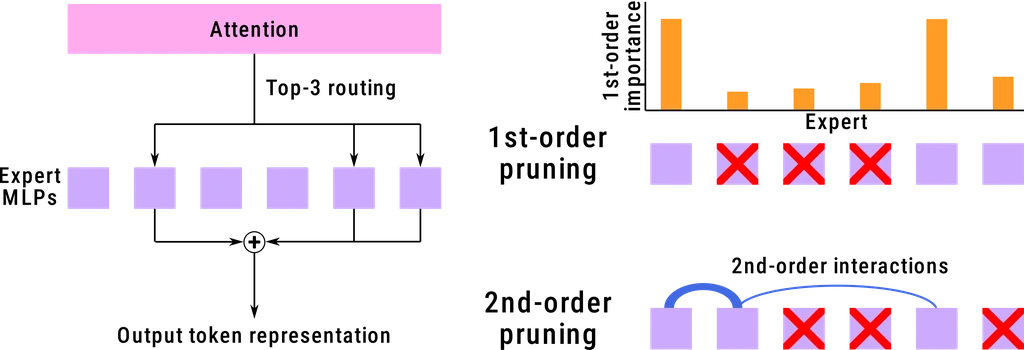
MoE 전문가를 두 개 지울 때: 개별 중요도만으로는 놓치는 상호작용
HOPE의 전문가 쌍 점수를 가상 계산으로 풀어 개별 순위와 조합 선택의 차이를 설명한다. 행렬 관측·연속 완화의 한계와 메모리 절감 후 서빙 검증을 구분한다.
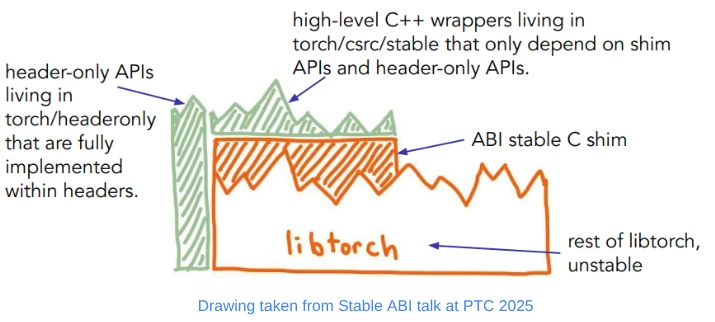
PyTorch를 바꿨는데 vLLM을 다시 빌드해야 할까: Stable ABI의 호환 범위
vLLM의 Stable ABI 전환을 통해 Python·LibTorch 호환성을 구분하고, 가상 모듈 예시로 의존성의 최소 버전과 재빌드 생략 조건을 설명한다.
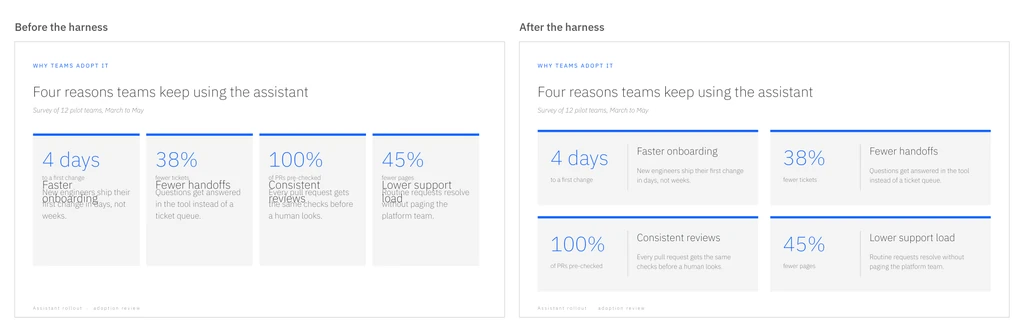
AI가 만든 슬라이드의 글자 겹침: 상자 크기와 실제 줄바꿈의 차이
Palette의 수정 전후 그림과 PptxGenJS의 자동 맞춤 설정으로 슬라이드 글자 겹침을 설명한다. 가상 치수 계산으로 글자 축소·상자 확장·카드 재배치의 대가를 비교한다.
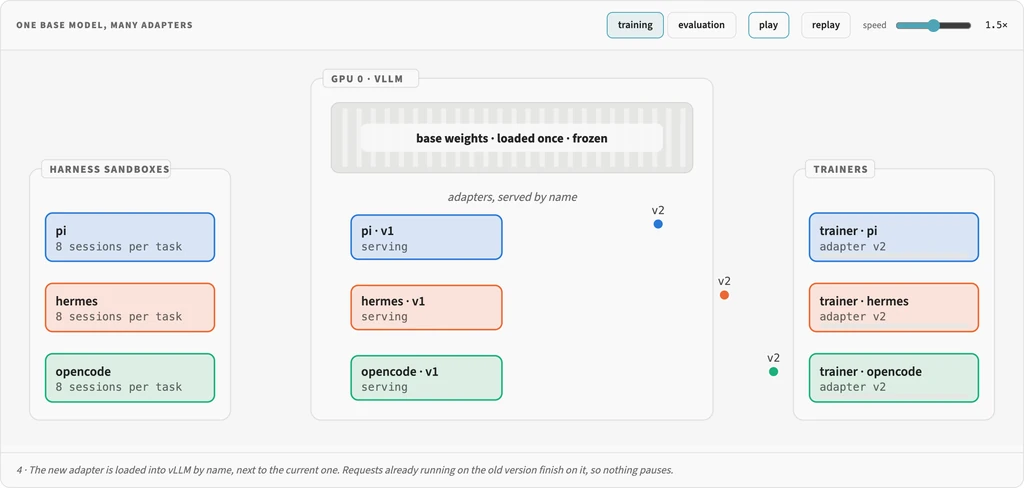
비동기 LoRA 학습에서 어댑터 슬롯이 하나 더 필요한 이유
TRL의 비동기 LoRA 동기화 코드를 따라 버전 지연 4에 슬롯 6개가 필요한 이유를 설명한다. v6~v11 가상 추적으로 로드·공개·언로드 순서와 표본 폐기 기준을 구분한다.
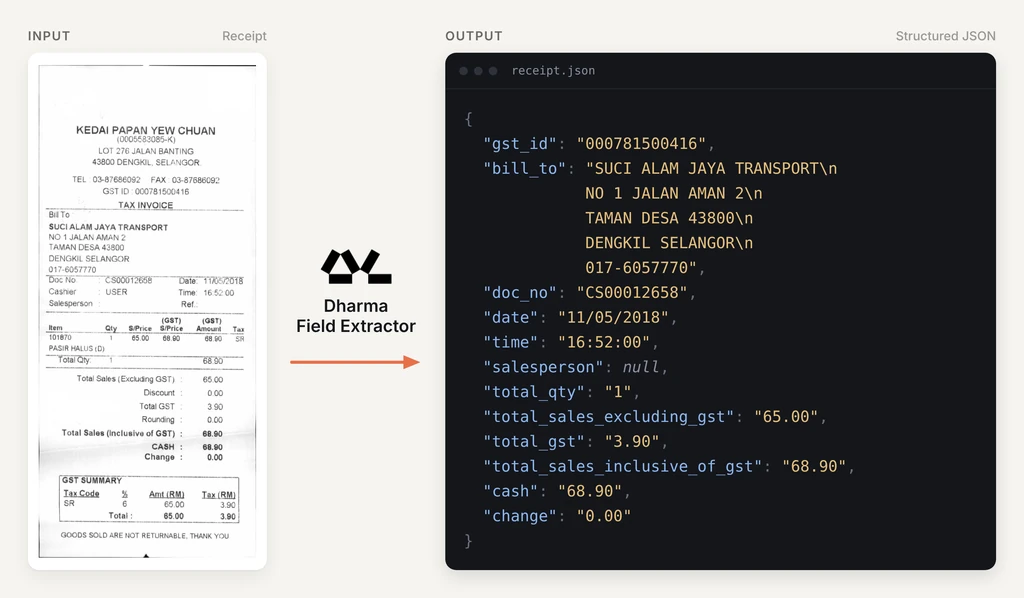
문서 추출 JSON의 null은 무슨 뜻일까: 누락된 키·false와 구분하기
Dharma의 문서 추출 예시로 null·키 누락·false의 차이를 설명한다. 가상 청구서를 따라 필드 계약, 원문 대조, 누락률과 오기입률을 나누는 평가 방법을 살핀다.
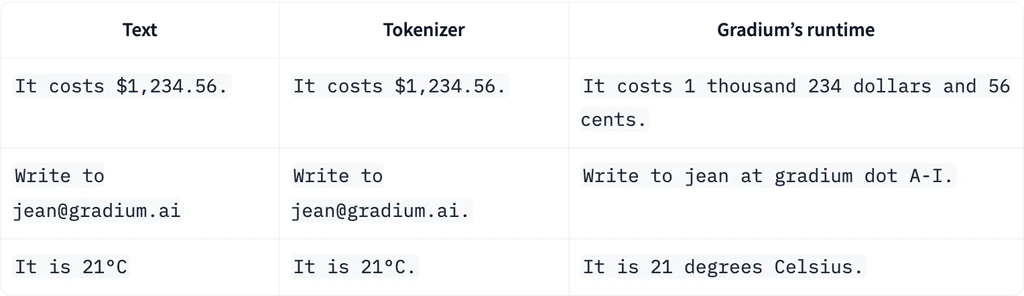
Phonon TTS는 왜 숫자를 다르게 읽을까: 런타임별 전처리와 날짜 해석
Phonon의 Transformers와 ptts가 숫자·기호를 다르게 처리하는 이유를 설명한다. 날짜 규칙과 언어 옵션의 범위를 코드로 확인하고, 입력 변환 오류와 음성 생성 오류를 나누는 진단 순서를 제안한다.
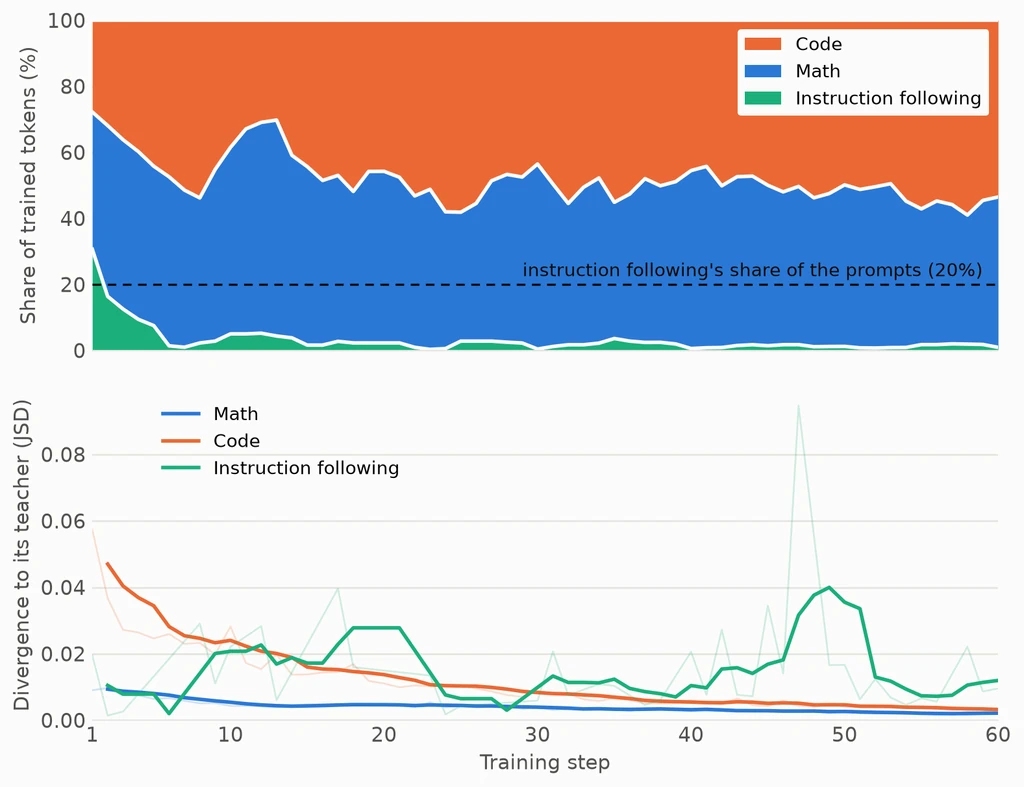
프롬프트 20%가 학습 토큰 2%가 되는 이유: MOPD의 길이 불균형
MOPD에서 프롬프트 배정 비율과 학습 토큰 비중이 달라지는 이유를 계산한다. TRL의 교사 라우팅·손실 분모·토큰 집계 코드를 따라가며 데이터 재추출과 손실 가중의 차이를 설명한다.
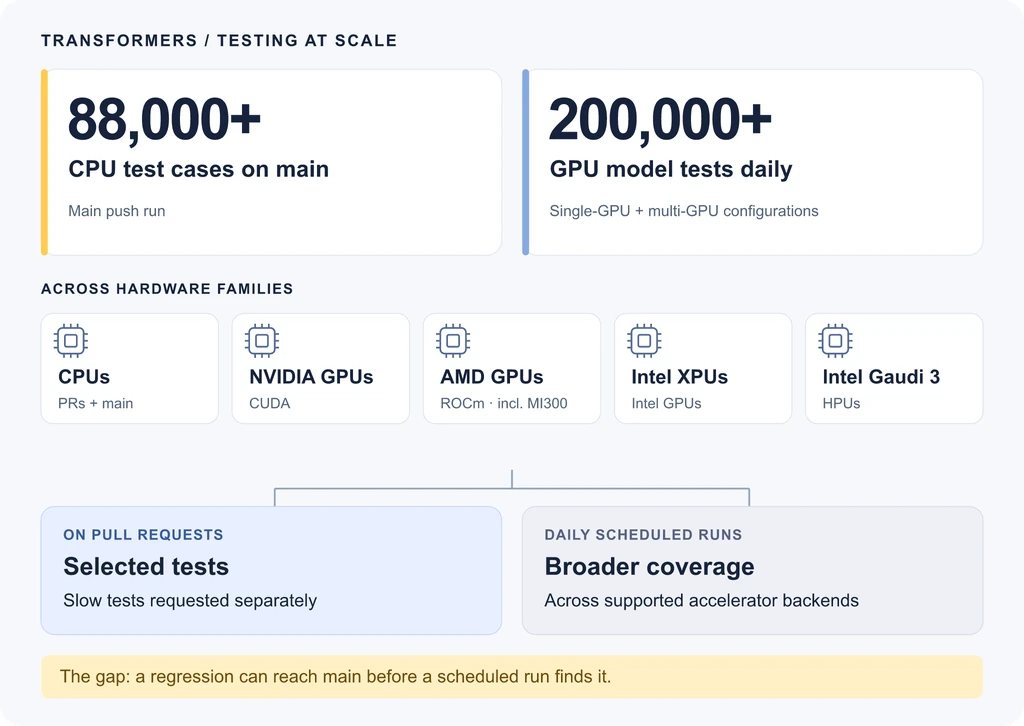
UMT5는 왜 미래 토큰을 봤을까: 실행 성공 뒤에 숨은 causal mask 오류
UMT5가 미래 토큰을 읽던 오류를 공식 수정 코드로 살펴본다. 마지막 토큰만 바꾸는 회귀 테스트와 허용 오차의 함정, 작은 모델에서도 SDPA 실행 경로를 유지해야 하는 이유를 설명한다.
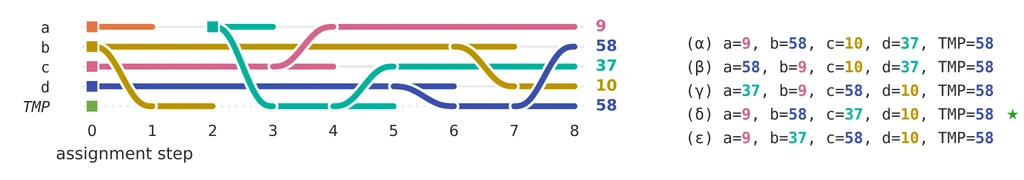
긴 문서에서 마지막 값을 놓치는 이유: StateBench로 따라가는 상태 변화
긴 문서의 최신 값 찾기와 참조 추적은 왜 다른가. StateBench 공식 그림의 변수 교환을 따라가며, 같은 정답을 가진 평가 문제와 누락이 전달되는 과정을 설명한다.
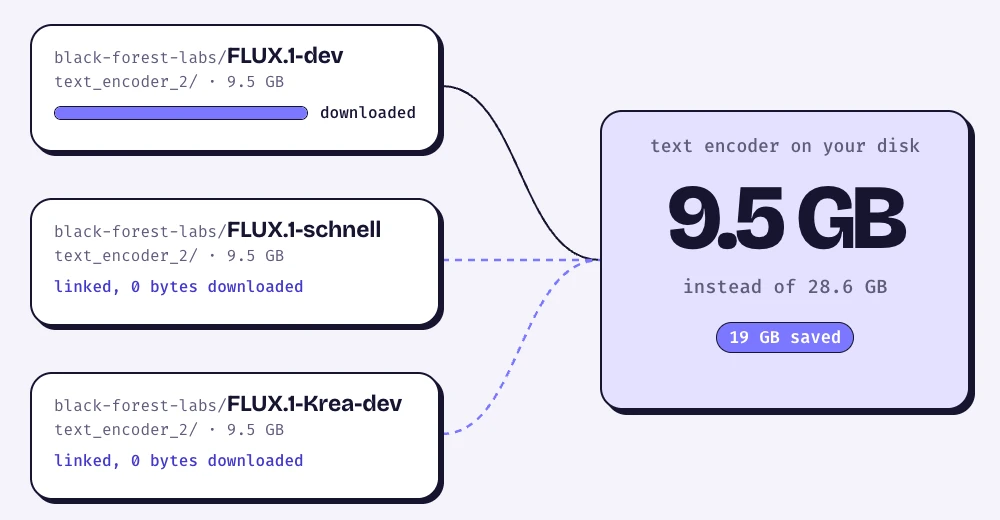
Hugging Face 캐시는 왜 삭제해도 그대로일까: 공유 파일과 참조 추적
모델 저장소를 삭제해도 공간이 그대로인 이유를 공유 파일과 참조로 설명한다. Hugging Face 코드와 8 GB 예제로 중복 다운로드·논리 용량·실제 회수를 구분한다.
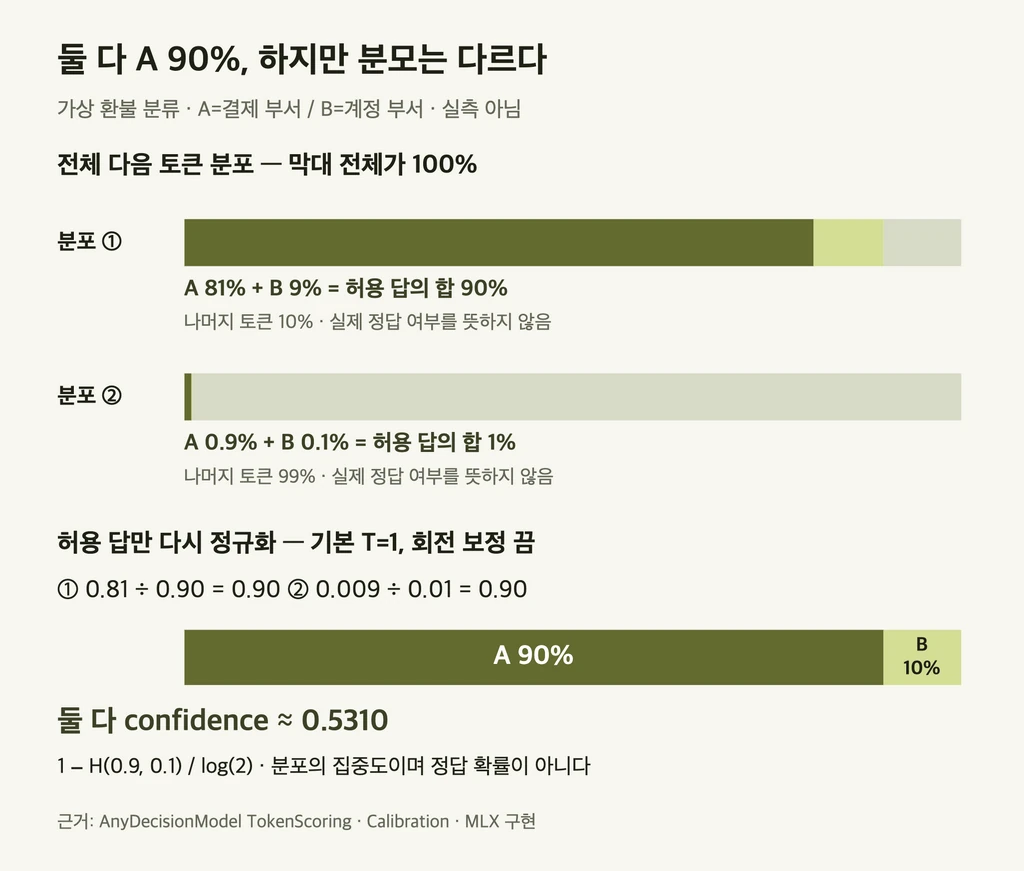
선택 확률 90%는 어디서 나왔을까? 판단 모델의 정규화와 confidence
허용 답의 원래 확률 합이 1%여도 선택 확률은 90%가 될 수 있다. AnyDecisionModel 코드와 가상 계산으로 정규화·confidence·온도 보정의 차이를 설명한다.
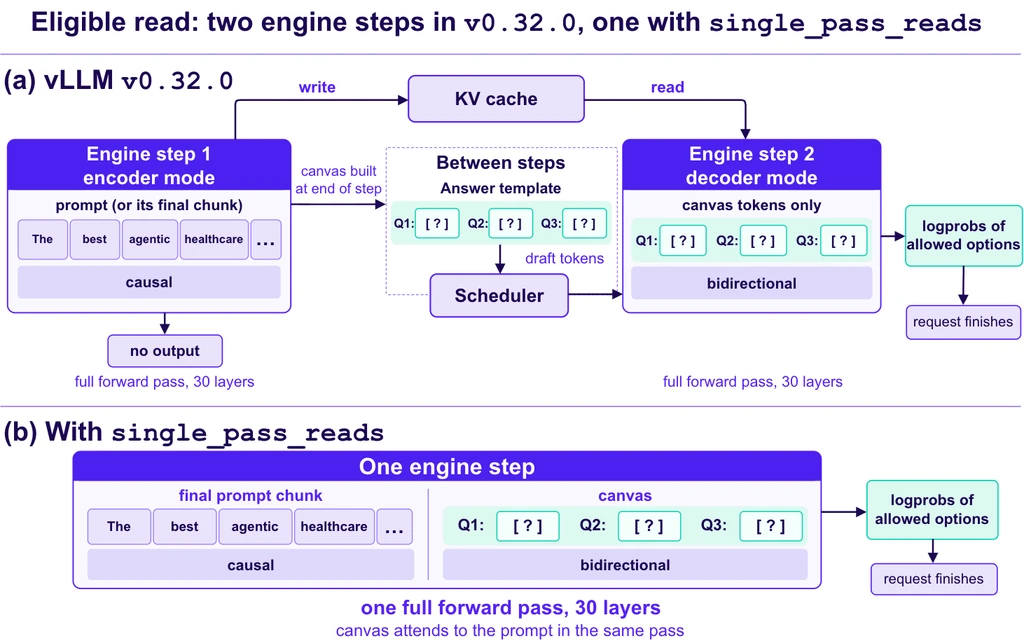
답은 한 번 읽는데 모델은 왜 두 번 돌까? DiffusionGemma의 실행 경로 합치기
DiffusionGemma의 한 번짜리 노이즈 제거가 두 모델 실행으로 나뉘는 이유를 코드로 따라간다. 입력·캔버스 융합, 어텐션 경계와 토큰 예산을 작은 예제로 설명한다.
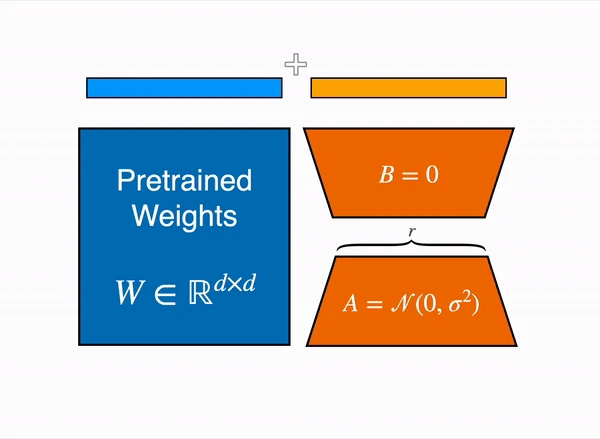
LoRA는 가중치를 어떻게 바꾸나: 작은 행렬의 학습부터 병합까지
LoRA의 두 작은 행렬이 출력을 바꾸는 과정을 숫자 예제로 따라간다. 0 초기화의 기울기, 학습 변수 절감, 가중치 병합과 어댑터 분리의 대가를 연결해 설명한다.
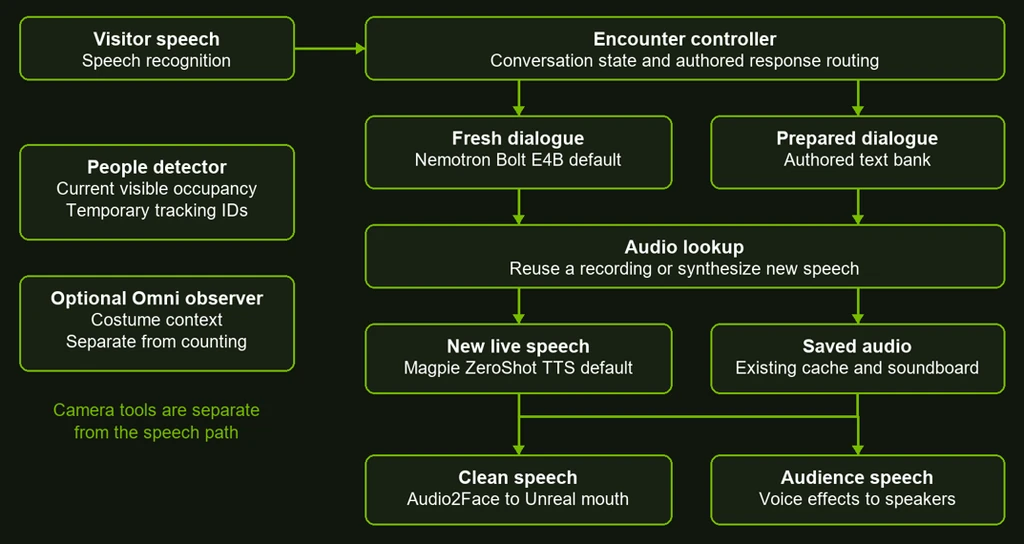
음성 에이전트는 어디서 기다릴까: 텍스트·녹음 캐시와 재생 버퍼
음성 안내 요청 하나로 텍스트·녹음 캐시가 생략하는 작업을 따라간다. 캐시 키와 가상 지연 계산, 재생 버퍼와 끼어들기 처리를 연결해 재사용이 유리한 조건을 설명한다.
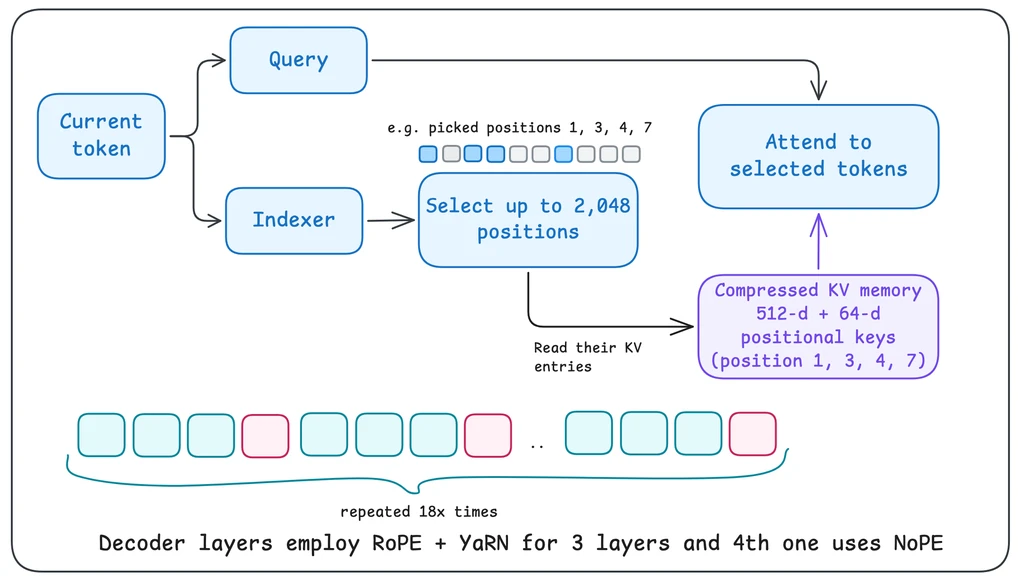
Mistral Large 4는 100만 토큰에서 무엇을 읽나: 위치 선택과 KV 압축
Mistral Large 4의 top-k 위치 선택을 작은 점수 예제로 풀고, Transformers의 마스크·커널 경로를 따라간다. KV 압축과 전문가 선택이 서로 다른 비용을 줄이는 이유를 설명한다.
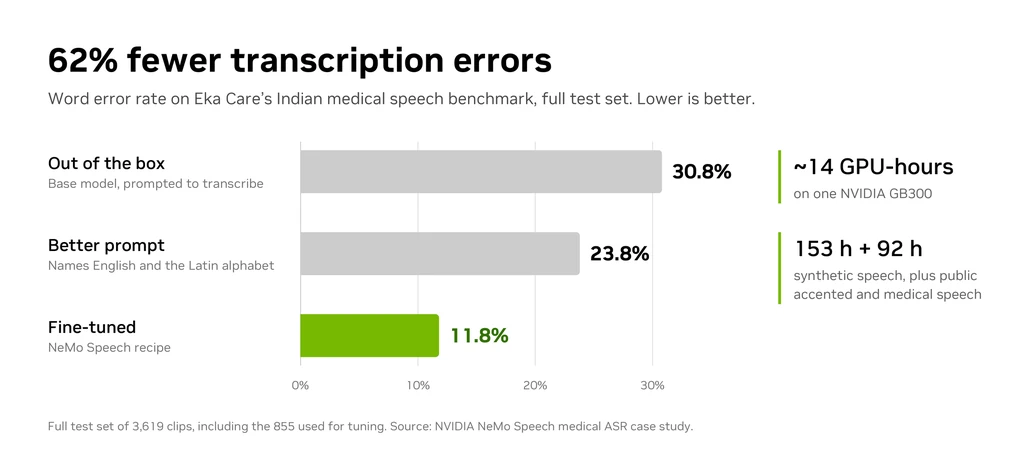
음성 인식 오류는 왜 줄었나: WER 계산부터 파인튜닝 비교 기준까지
WER을 단어 정렬 예제로 직접 계산하고, NVIDIA 음성 인식 사례의 62%와 45.8%가 서로 다른 이유를 설명한다. 합성 라벨의 표기 조건과 새 화자 평가가 학습 효과의 해석을 바꾸는 과정도 짚는다.
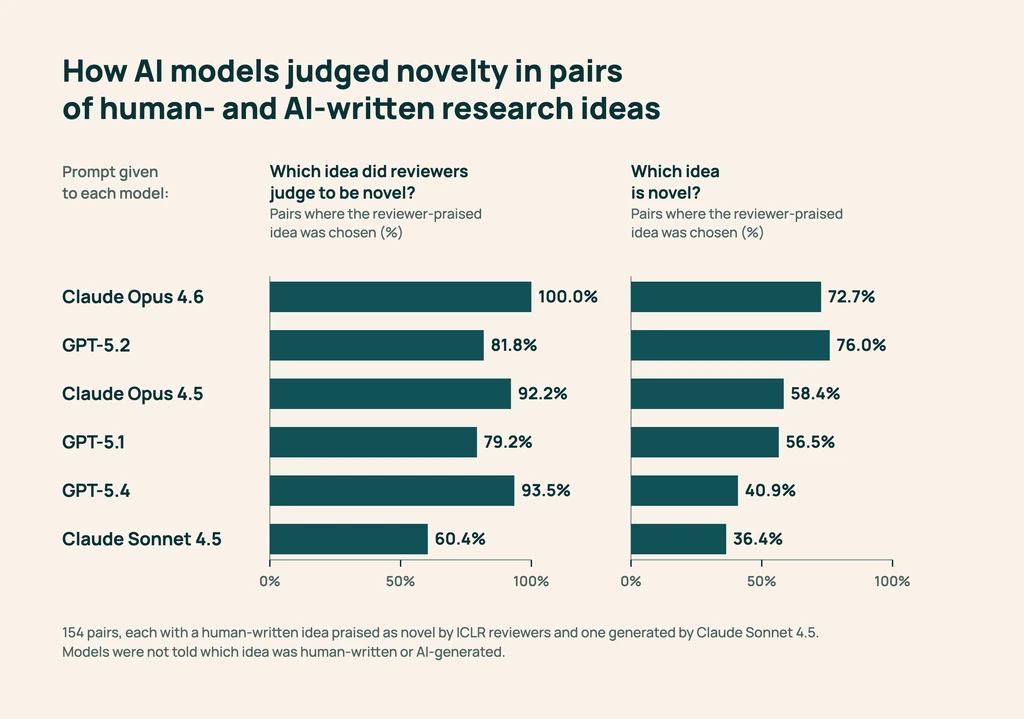
LLM은 연구 아이디어의 새로움을 아는가: 점수와 판정 불일치 읽기
LLM의 새로움 평가에서 질문의 전제가 무엇을 바꾸는지 살펴본다. 10쌍의 예제로 평균 선택 비율과 판정 불일치를 구분하고, 약한 라벨·제시 순서·반복 평가를 해석하는 방법을 설명한다.
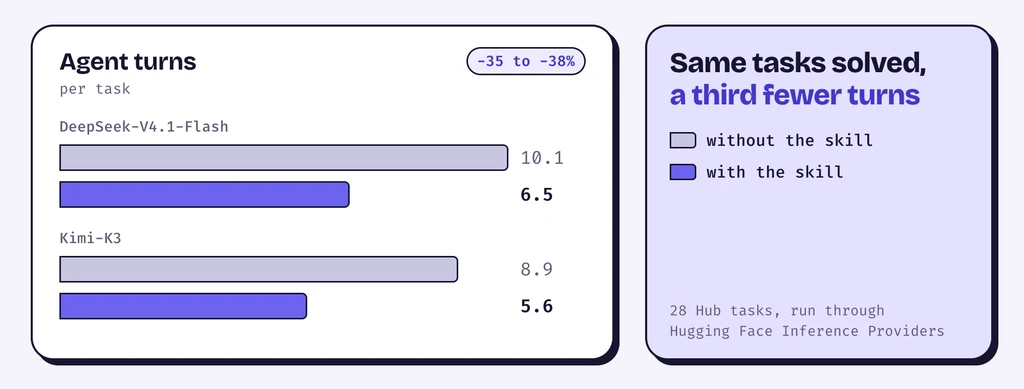
hf CLI 스킬은 무엇을 줄이나: 도움말 탐색과 토큰 비용의 손익
hf CLI 스킬이 도움말 탐색을 줄이는 과정을 작업 흐름으로 설명한다. 긴 스킬의 토큰 비용이 상쇄되는 경우와 늘어나는 경우를 계산하고, 도구 버전과 결과 검증을 함께 비교하는 기준을 정리한다.
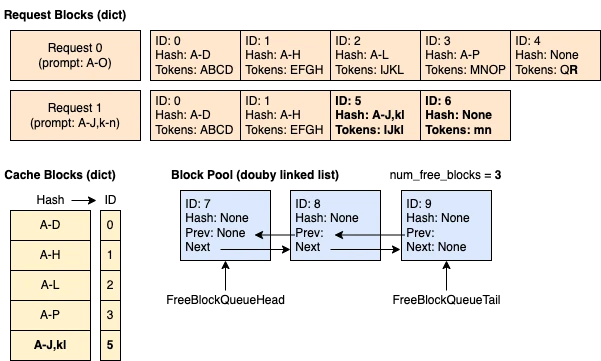
vLLM prefix caching은 무엇을 재사용하나: 블록 해시에서 퇴출까지
vLLM이 같은 접두어의 KV를 찾는 과정을 해시 연결과 블록 예제로 설명한다. 참조 해제와 퇴출의 차이, prefill을 줄여도 전체 응답이 같은 비율로 빨라지지 않는 이유까지 따라간다.
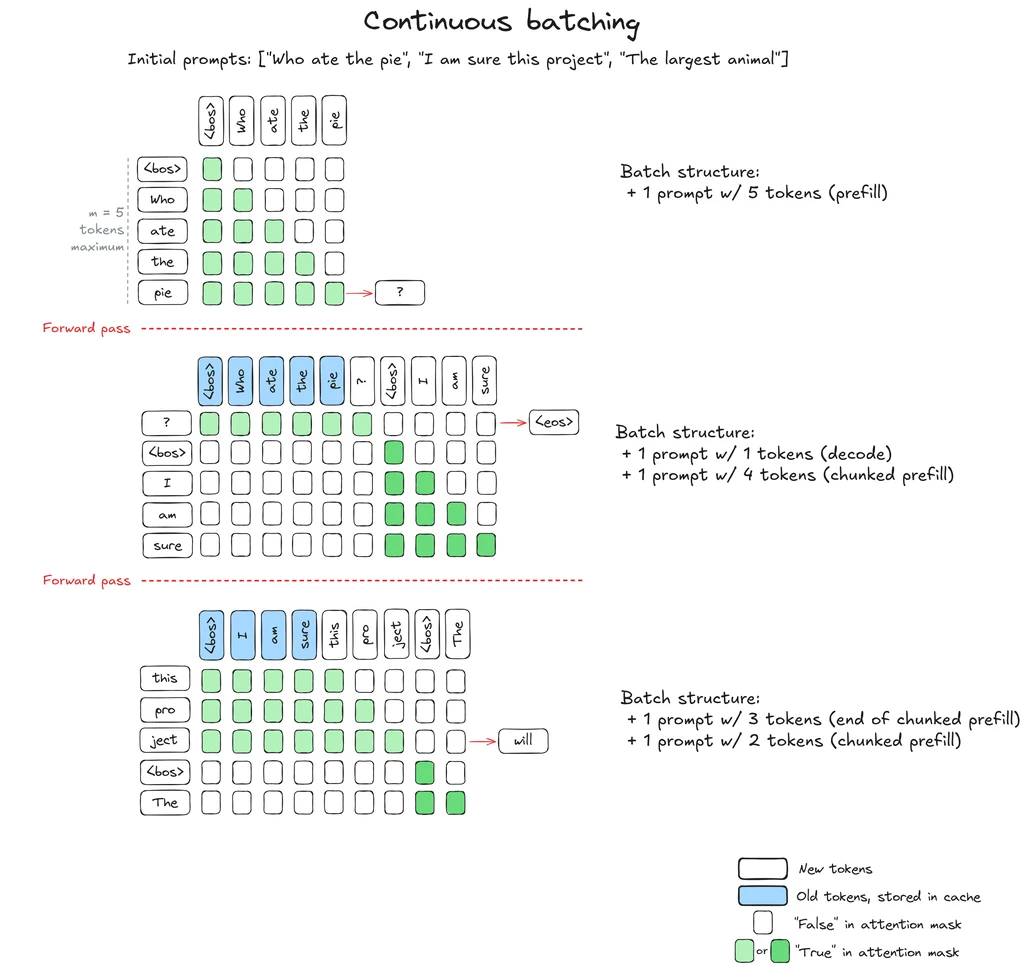
Continuous batching은 빈자리를 어떻게 채울까: 토큰 예산과 KV 캐시
짧은 답변과 긴 입력을 함께 처리하는 단계별 예제로 continuous batching을 설명한다. query 토큰 예산과 KV 메모리를 구분하고, 청크 크기가 첫 응답과 토큰 간격에 미치는 영향을 따라간다.
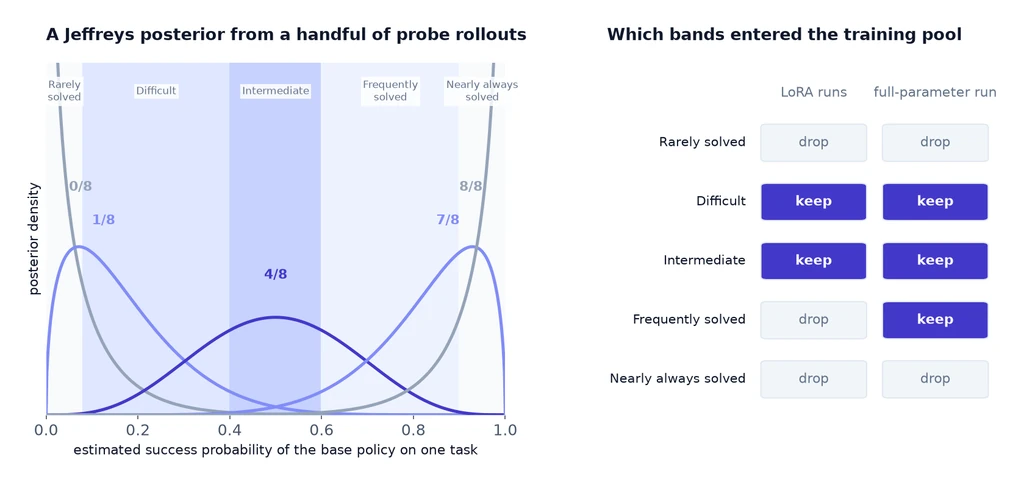
ThinkingBox는 배울 과제를 어떻게 고를까: GRPO 보상 차이와 성공 확률
GRPO의 보상 차이를 8회 실행 예제로 계산하고, ThinkingBox가 성공 확률의 불확실성으로 과제를 고르는 과정을 따라간다. 평균 성공률과 해결 범위가 다르게 움직이는 이유도 살펴본다.
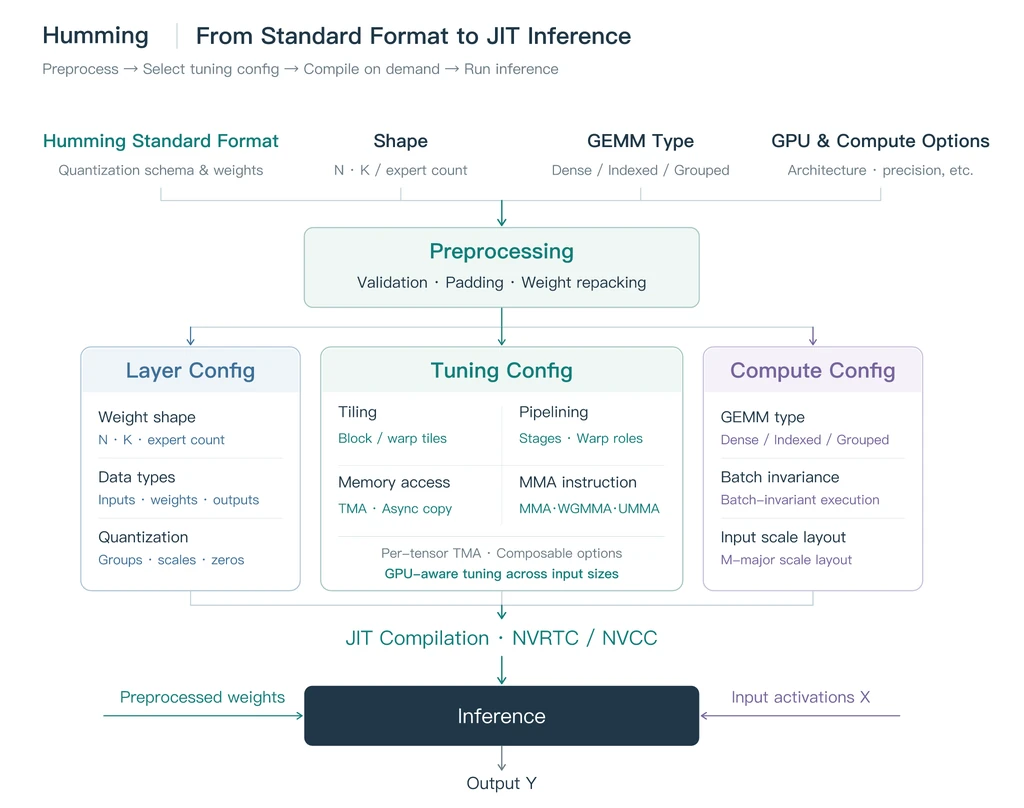
vLLM Humming은 4비트를 어떻게 계산하나: 스케일·커널·병목의 연결
작은 INT4 계산으로 스케일과 복원 오차를 이해하고, Humming의 가중치 전처리·커널 준비·추론을 따라간다. 입력 형상과 활성값 정밀도가 성능 비교를 바꾸는 이유를 설명한다.
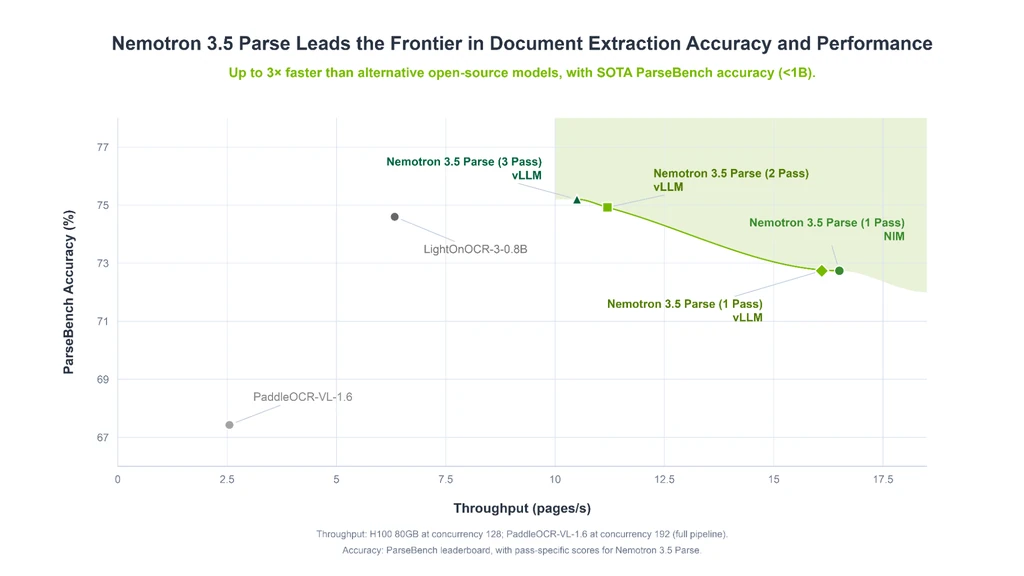
PDF 숫자는 맞는데 답은 왜 틀릴까: Nemotron Parse의 영역·좌표·표 구조
Nemotron Parse의 재읽기 후보와 좌표 변환을 따라가며, 숫자가 맞아도 표의 머리글 관계가 사라지면 검색 답변이 틀리는 이유를 설명한다.
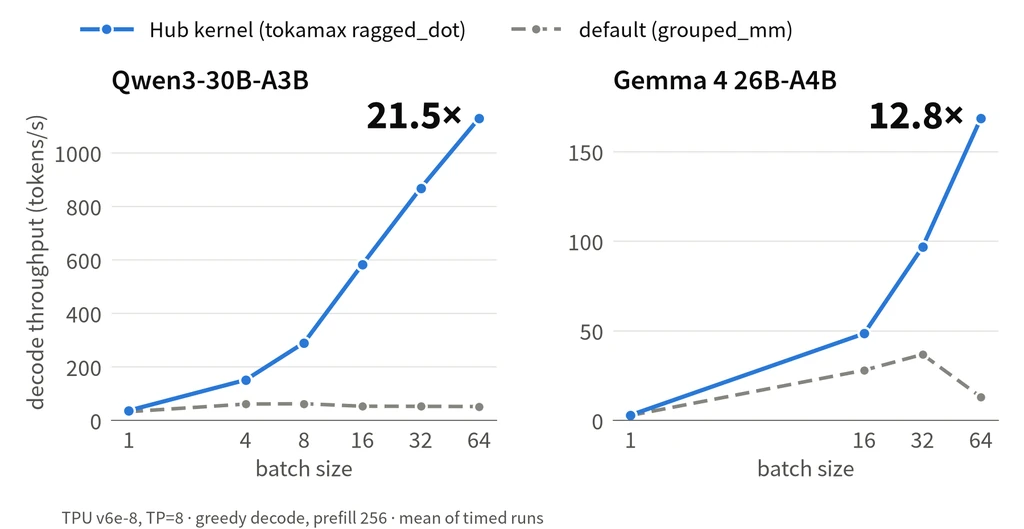
TorchTPU는 언제 빨라질까: 입력 모양과 컴파일 비용의 손익
TorchTPU의 모양별 그래프 재사용을 A·B·A 요청으로 따라가고, 컴파일에 30초를 쓰는 가정에서 반복 횟수별 손익을 계산한다. 커널 가속과 전체 서비스 지연의 차이도 구분한다.
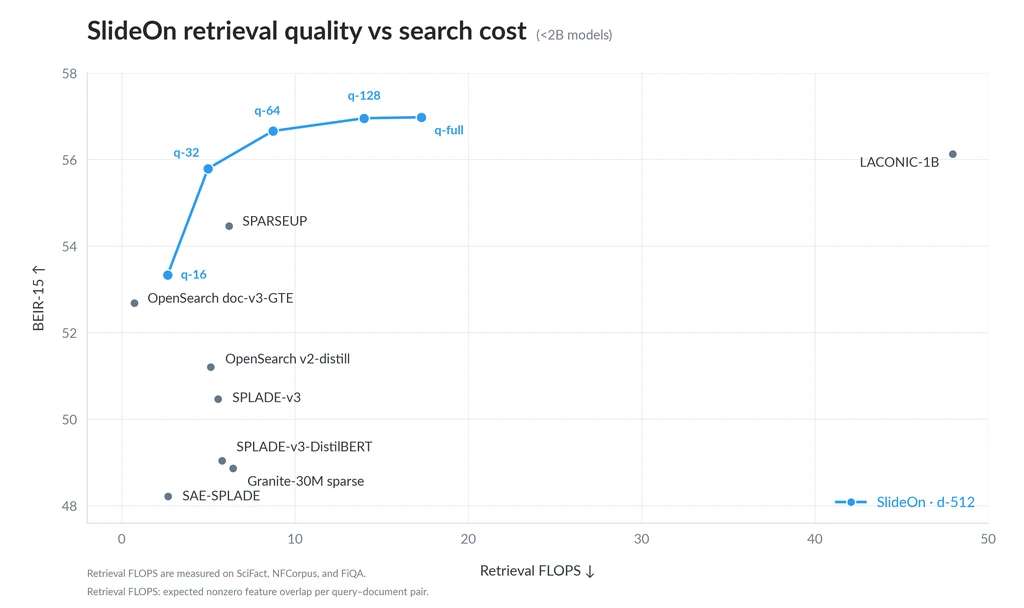
SlideOn은 무엇을 지워 검색을 줄일까: 희소 내적과 역색인의 비용
작은 희소 벡터의 내적을 계산해 질문과 문서 가지치기가 순위를 바꾸는 과정을 살핀다. 역색인 저장량과 목록 길이, 실제 지연을 구분하고 현재 평가 인수도 확인한다.
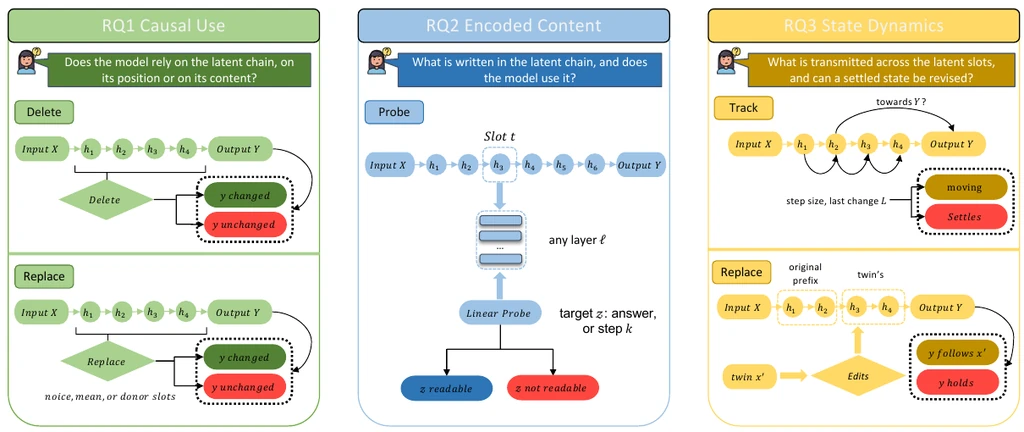
숨은 상태에서 답이 읽히면 추론한 걸까: 잠재 추론의 삭제·대체 실험
잠재 상태를 읽는 프로브와 상태를 바꾸는 개입의 차이를 가상 벡터로 설명한다. 같은 80% 정확도에서도 40개 문제의 정오가 바뀔 수 있는 이유와 상태 거리의 한계를 계산한다.
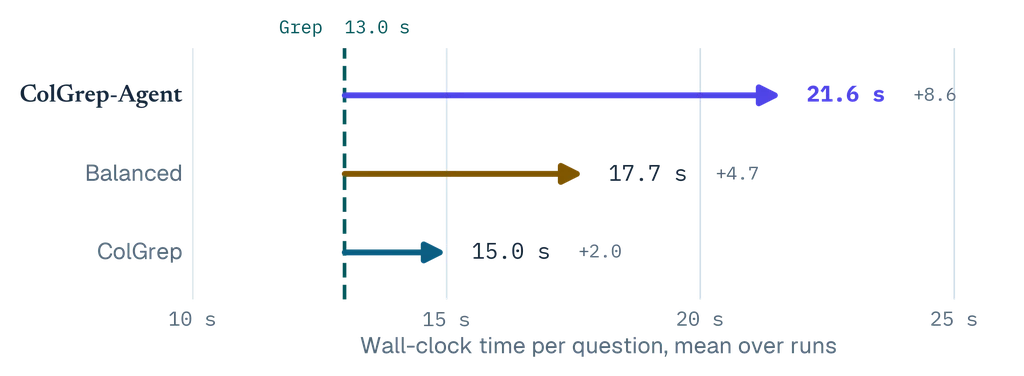
ColGrep-Agent는 토큰을 어디서 줄일까: 검색 위임과 재탐색의 손익
ColGrep-Agent가 반복 탐색 문맥을 줄이는 과정을 계산하고, API 토큰 감소와 로컬 계산·대기 비용을 구분한다. 필요한 코드 위치의 완전성과 실패 후 재탐색의 손익까지 살핀다.
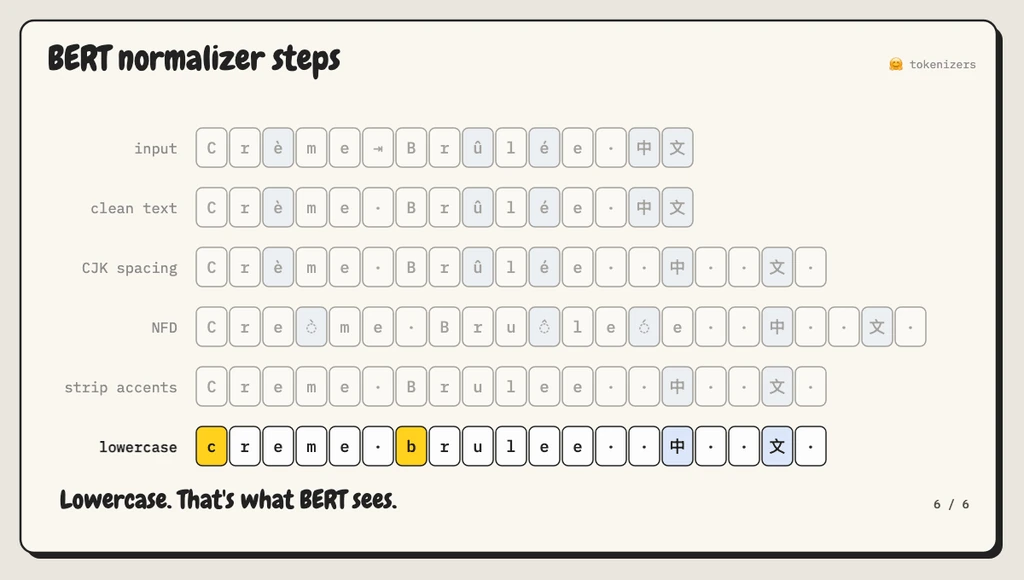
BERT 토크나이저는 무엇을 건너뛸까: ASCII 빠른 경로와 한글 정규화
É와 한글 가의 NFD 분해, ASCII 비트 연산 반례로 BERT 정규화의 빠른 경로를 설명한다. 같은 토큰을 유지하는 조건과 전체 요청에서 얻는 성능 이득을 구분한다.
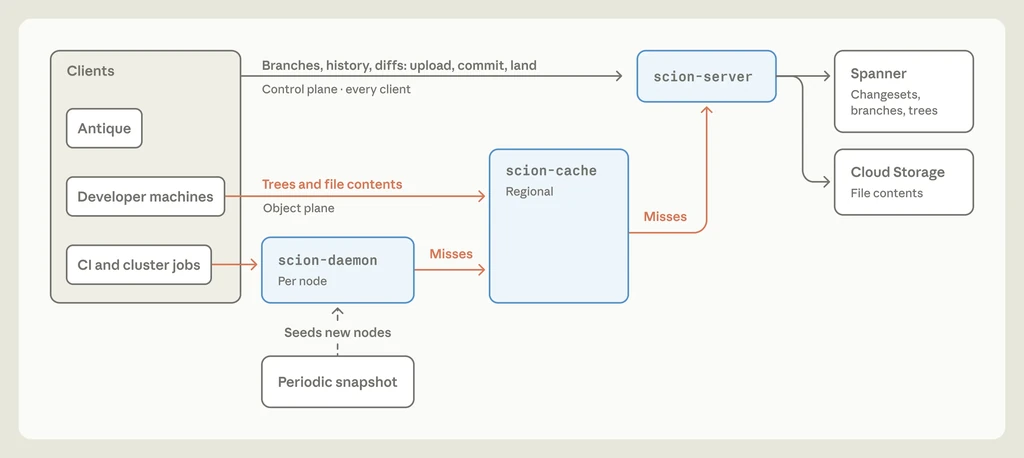
Scion은 왜 전체 저장소를 받지 않을까: 조회·파일·캐시 경로의 분리
Scion의 조회 API와 파일 캐시 경로를 따라가며 객체 적중률, 지연 다운로드의 왕복 비용, 누락 후 재실행 비용을 계산한다. Git의 sparse checkout과 partial clone도 나눠 설명한다.
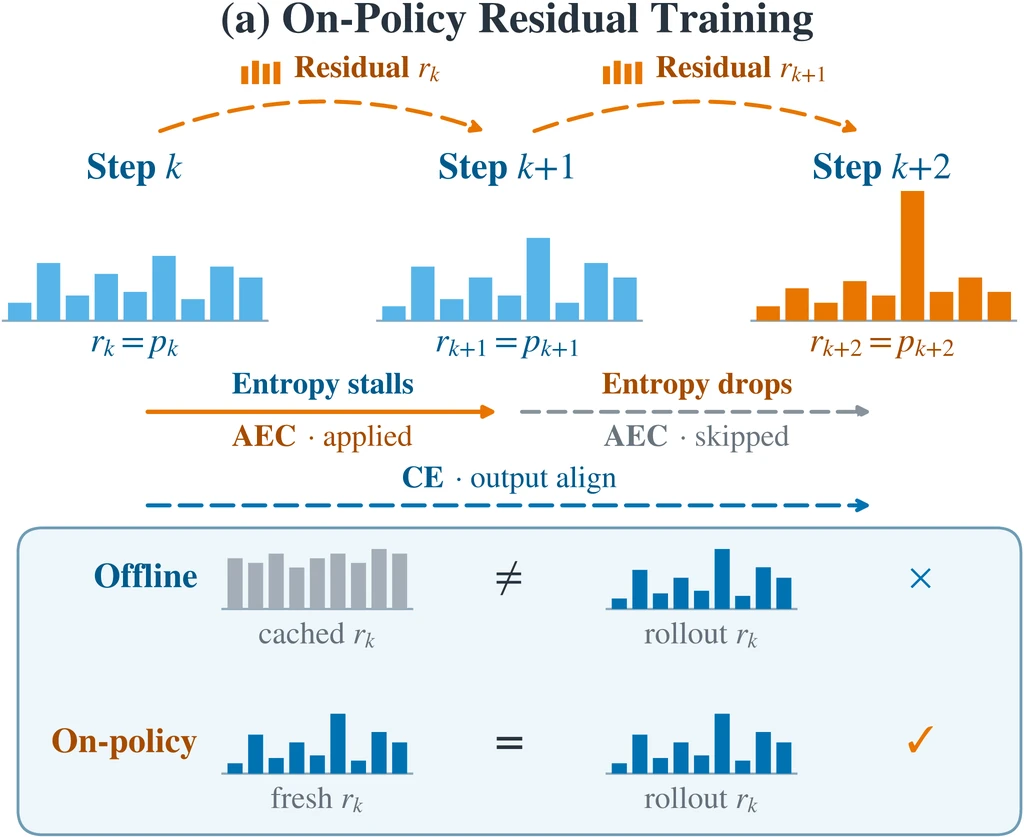
ORL은 어떤 중간 상태로 학습할까: 잔여 임베딩과 엔트로피 수축 계산
ORL의 잔여 입력을 작은 벡터로 계산하고, 엔트로피 수축 손실과 미확정 위치 평균의 함정을 짚는다. 순전파 감소가 실제 속도로 이어지는 조건도 구분한다.
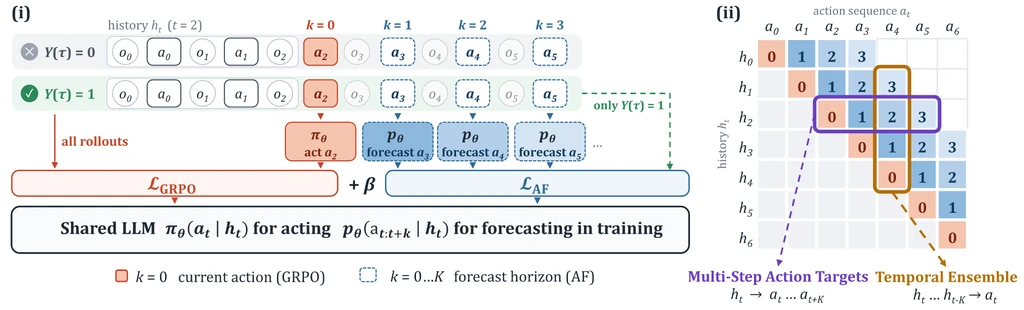
CoPE는 한 행동에서 어떻게 더 배우나: 미래 행동 예측과 성공 경로의 편향
CoPE에서 한 행동이 여러 과거 입력의 정답이 되는 과정을 계산한다. 성공 필터가 어려운 작업의 학습 기회를 줄이는 이유와 표본 효율·전체 시간의 차이를 짚는다.
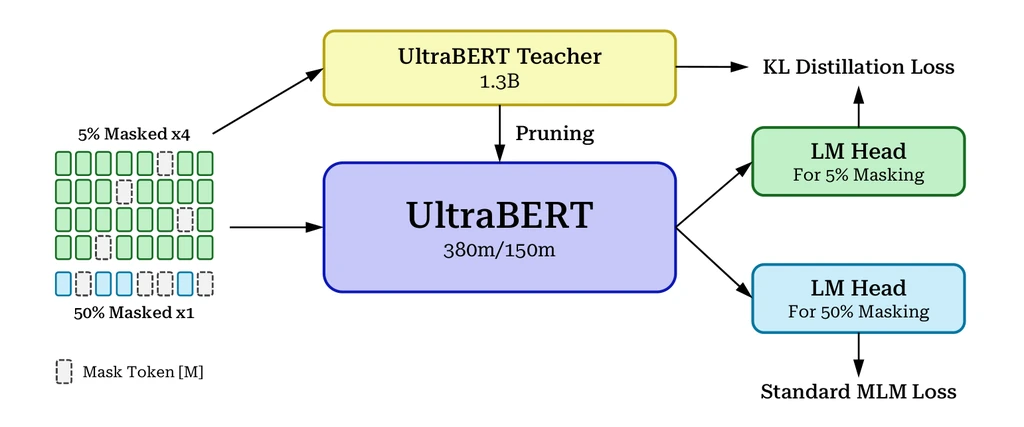
UltraBERT는 왜 예측층을 나눌까: 마스킹 비율과 기울기가 만나는 지점
UltraBERT의 공유 인코더와 분리된 LM 헤드를 따라가며 마스킹 비율, 토큰별 손실 집계, 기울기 상쇄를 계산한다. 분류·검색 평가를 따로 읽어야 하는 이유도 짚는다.
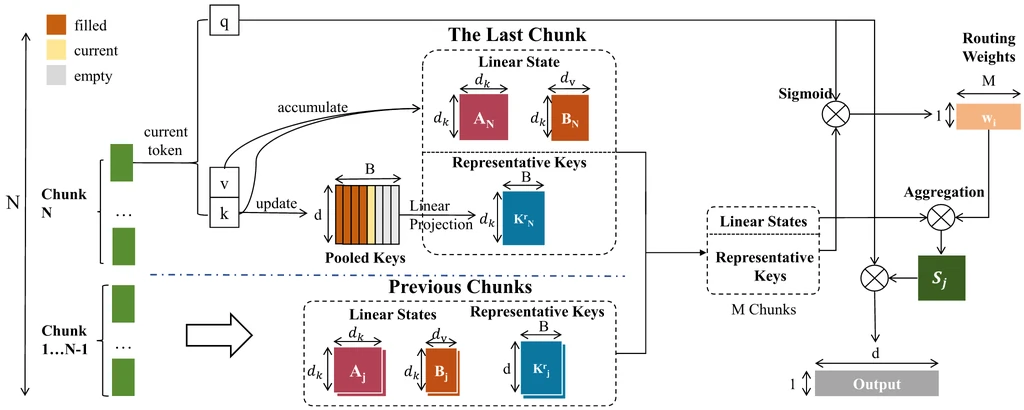
HLA는 과거 기억을 어떻게 다시 읽나: 청크 변환과 건너뛰기의 오차
HLA가 청크의 새 정보와 기존 기억의 변환을 함께 조절하는 이유를 계산한다. 시간순 합성, 가중치 임계값의 오차, 문맥 길이에 따른 저장량을 구분한다.
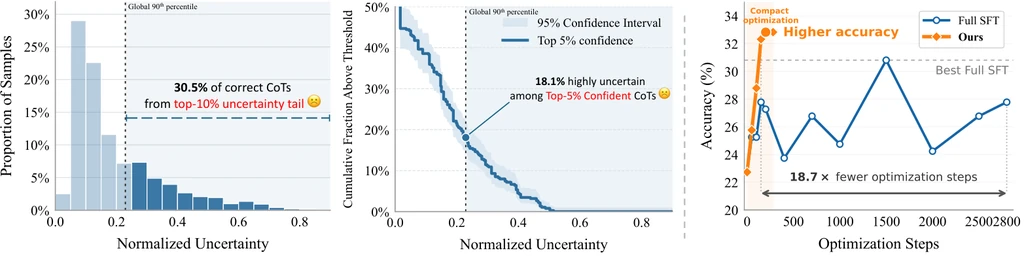
정답 풀이가 왜 불안정할까: LLM 학습 데이터의 분기 확률과 선택 비용
정답 풀이의 분기 확률과 학생 손실을 구분하고, 적은 표본에서 불확실성 점수가 흔들리는 이유를 계산한다. 학생 학습량 절약과 전체 생성·평가 비용도 나눠 본다.
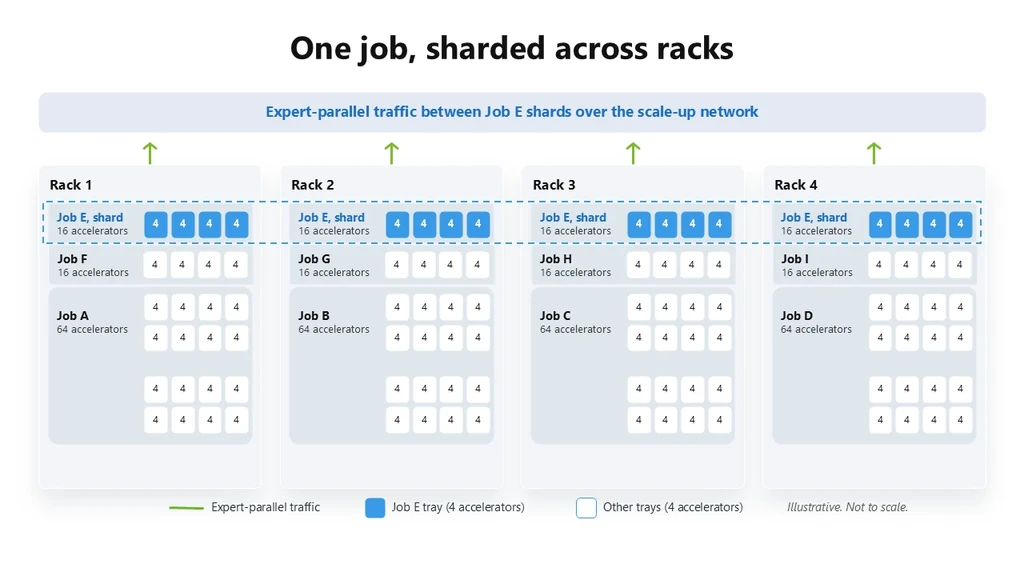
Maia 300의 7배는 어디서 나오나: 랙 처리량과 요청 지연의 계산
Maia 300의 랙 처리량과 전력 효율 주장을 요청 지연으로 바로 바꿀 수 없는 이유를 계산한다. 가속기 수, 배치 크기, 품질·지연 기준을 통과한 작업량을 나눠 비교한다.
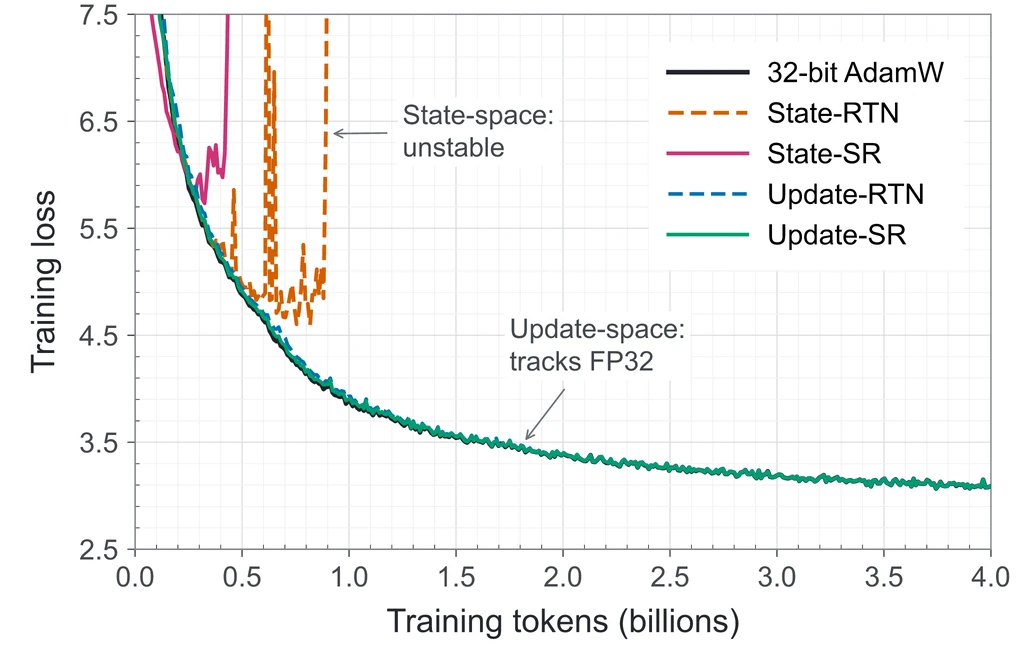
4-bit AdamW는 무엇을 반올림하나: 역제곱근 오차와 전체 메모리
4-bit AdamW에서 상태 평균을 맞춰도 역제곱근 계수에 오차가 생기는 이유를 계산한다. 모멘트 압축률과 전체 메모리, 검증 손실 차이의 분모를 구분한다.
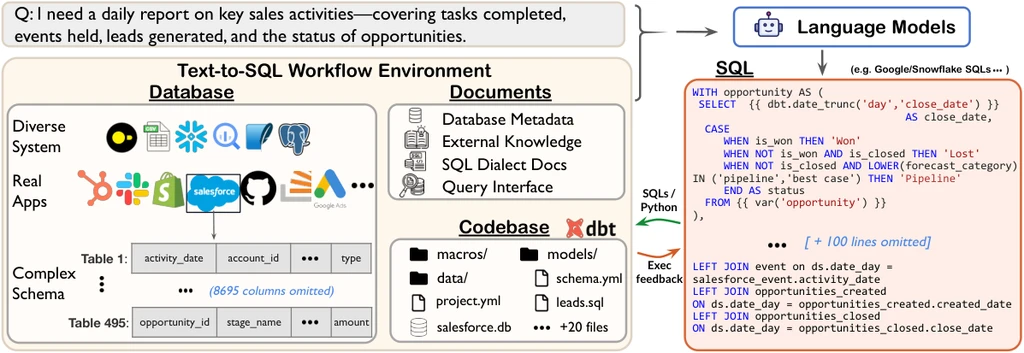
실행되는 SQL이 왜 틀릴까: 조인 중복부터 비용 제한까지
주문 두 건이 조인 뒤 세 행이 되면 실행에 성공한 SQL도 매출을 부풀린다. 집계 단위를 추적하고 권한·스캔 비용을 분리해 검증하는 과정을 설명한다.
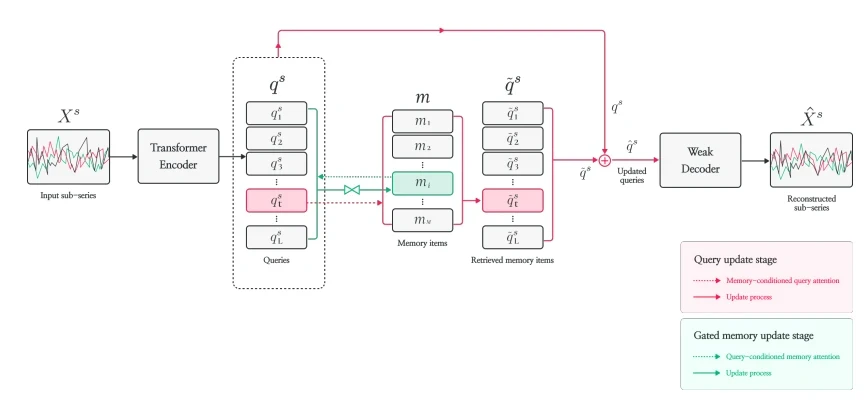
MEMTO는 이상을 어떻게 점수로 바꾸나: 메모리 거리와 재구성 오차
정상 패턴에서의 거리와 재구성 오차를 곱하면 이상 시점의 순위가 바뀐다. MEMTO의 점수 계산을 따라가며 윈도우 길이·임계값·point adjustment가 경보 해석에 미치는 영향을 살핀다.
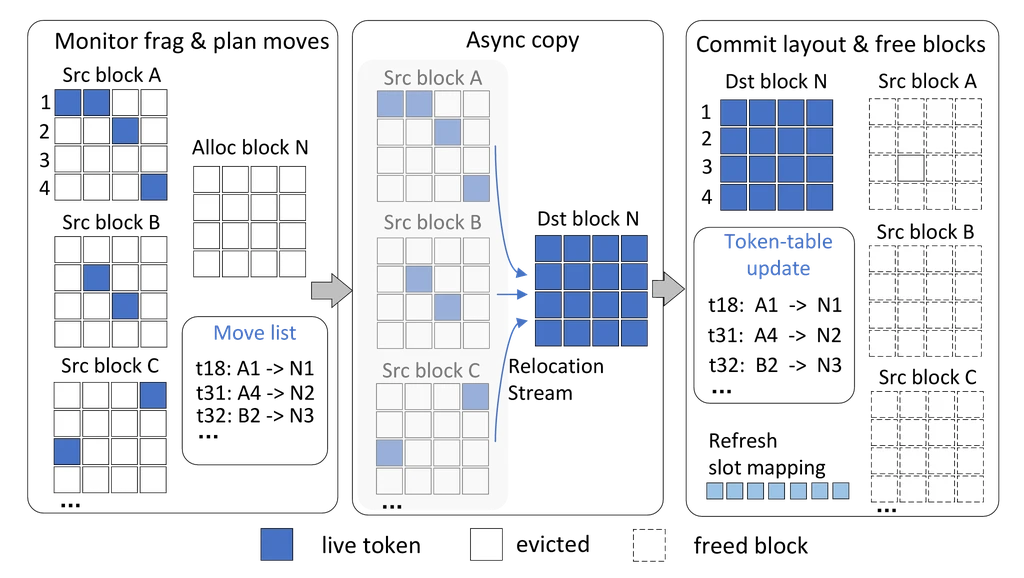
토큰을 지웠는데 GPU 메모리는 그대로인 이유: vToken의 블록 회수
16슬롯 중 토큰 12개를 지워도 네 블록이 모두 남을 수 있다. vToken이 논리 토큰과 물리 슬롯을 분리해 빈 블록을 만드는 과정과 재배치가 이득 없는 조건을 설명한다.
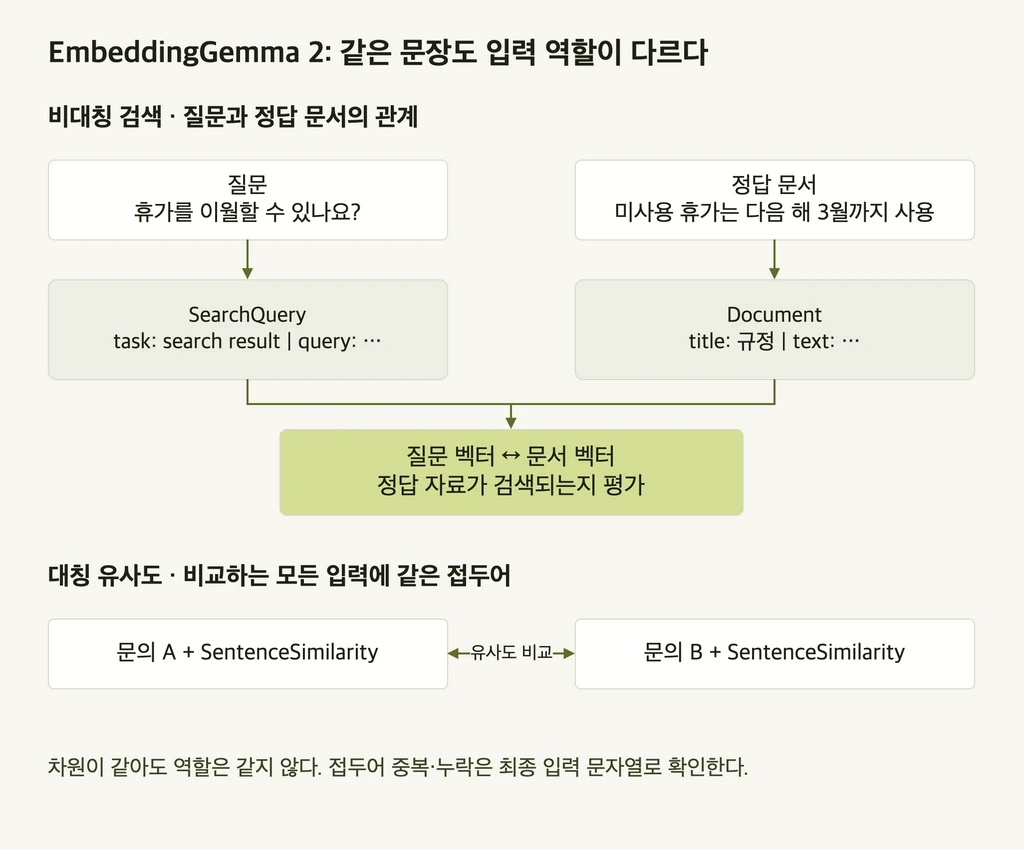
EmbeddingGemma 2 검색이 어긋날 때: 접두어가 바꾸는 입력과 색인
질문과 문서는 다른 접두어로 인코딩된다. 같은 휴가 질문을 따라가며 접두어 중복, 코사인 대칭성, 질문 설정만 바꿔도 되는 경우와 문서 재색인이 필요한 경우를 구분한다.
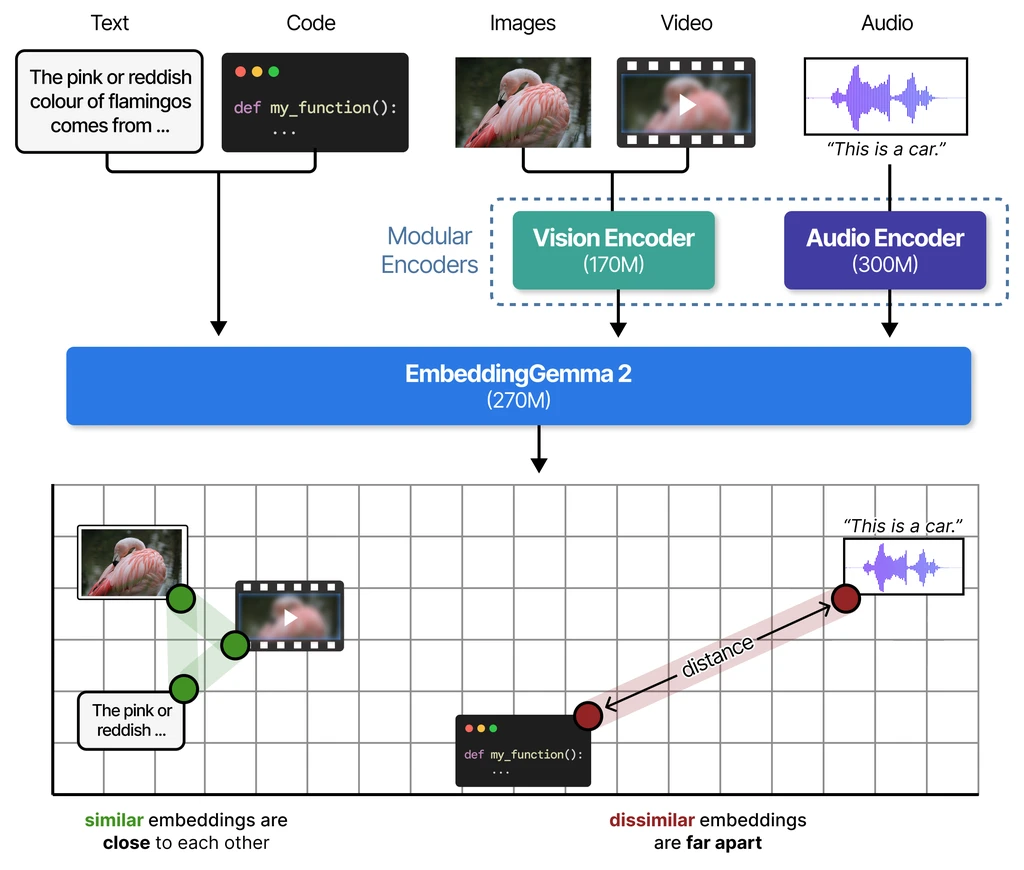
EmbeddingGemma 2의 벡터를 줄이면 무엇을 잃을까: 정규화와 저장량 계산
768차원을 128차원으로 줄이면 벡터는 6분의 1이 되지만 전체 저장소는 다르다. 잘라 낸 벡터의 재정규화와 실제 저장량을 계산하고 미디어 검색 손실을 구분한다.
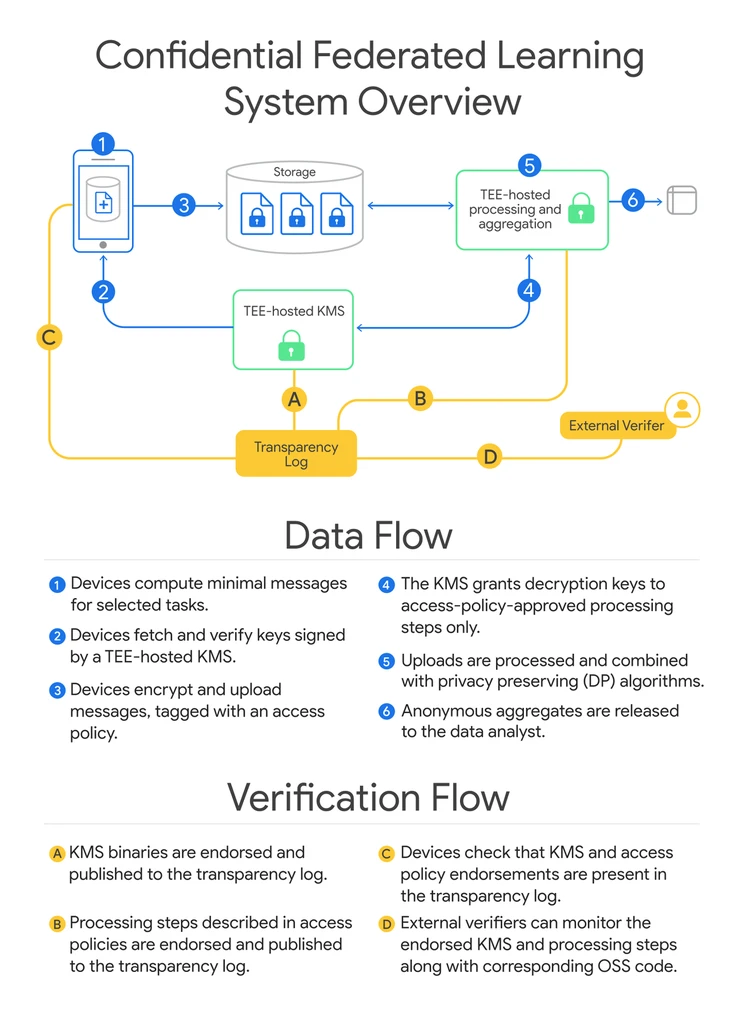
TEE 안에서 학습해도 재시도가 위험한 이유: 키 승인과 결과 공개 상태
TEE의 격리만으로 결과 공개까지 보호되는 것은 아니다. 독립 노이즈를 더한 결과를 반복 공개하는 예시로, 키 승인과 공개 기록·장애 복구를 함께 검증해야 하는 이유를 설명한다.
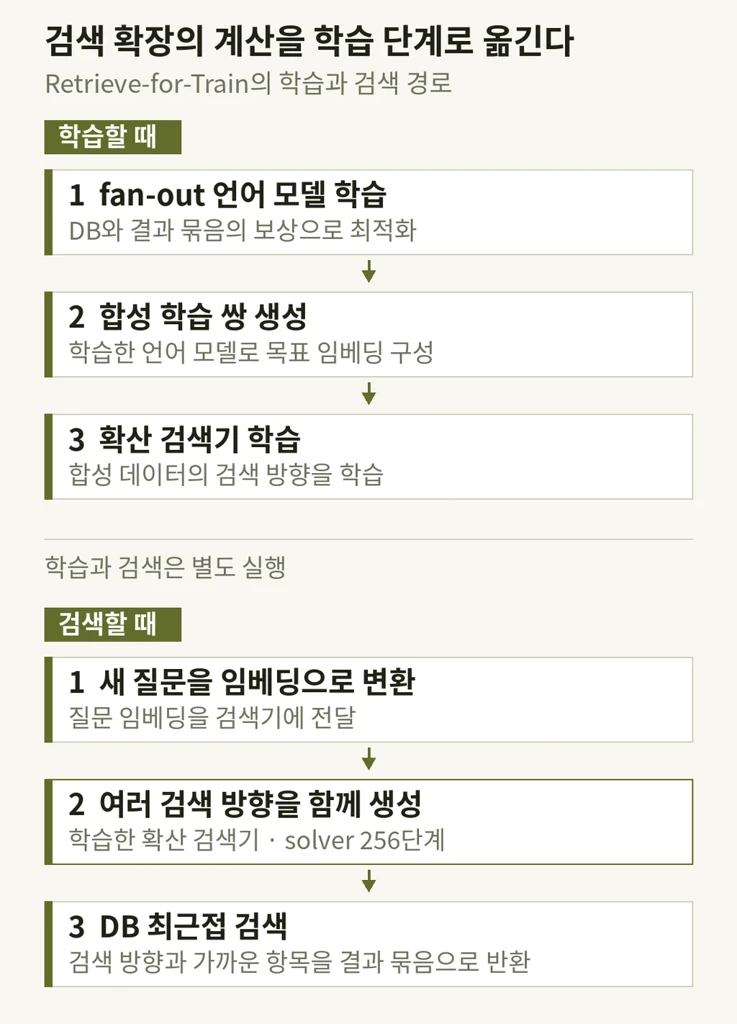
Retrieve-for-Train은 어디를 빠르게 하나: 검색 확장 지연과 재학습 비용
검색 확장을 1.46초에서 0.07초로 줄여도 전체 응답이 같은 비율로 빨라지지는 않는다. 단계별 지연과 학습비 회수 조건을 계산하고 결과 묶음의 품질을 분리해 평가한다.
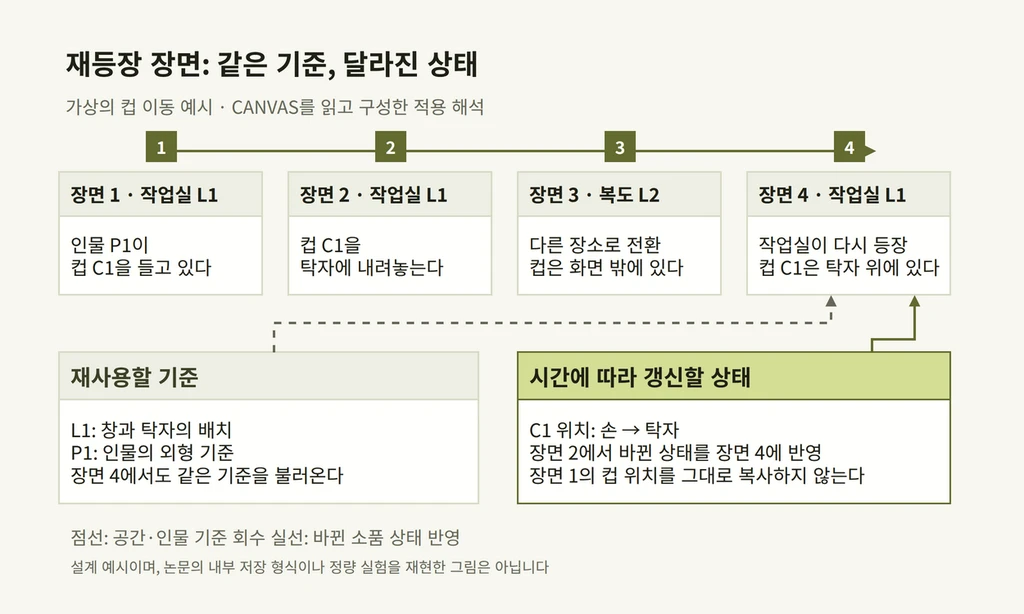
CANVAS는 무엇을 기억하고 바꾸나: 재등장 장면의 기준과 소품 상태
같은 인물과 장소는 유지하되 컵의 위치는 행동에 따라 바뀌어야 한다. 네 장면의 상태를 추적하며 CANVAS의 기준 이미지 검색과 선택 후 메모리 갱신이 맡는 역할을 설명한다.
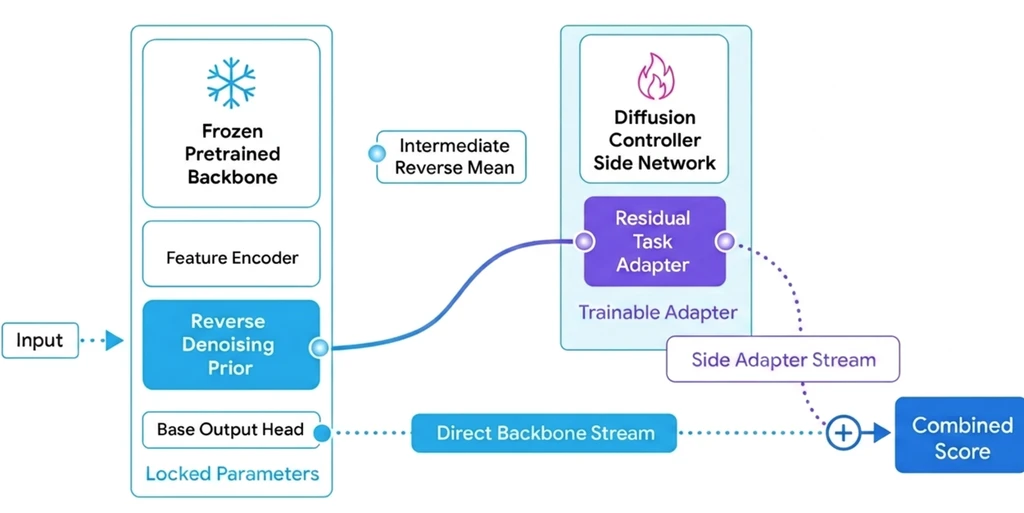
Diffusion Controller를 붙일 수 없는 API: 중간값 접근과 보정 개입의 차이
가중치를 고정해도 생성 과정에 접근할 인터페이스는 필요하다. 단계별 출력만 읽는 API와 보정값으로 다음 상태를 바꾸는 API를 구분하고 전체 비용을 계산한다.
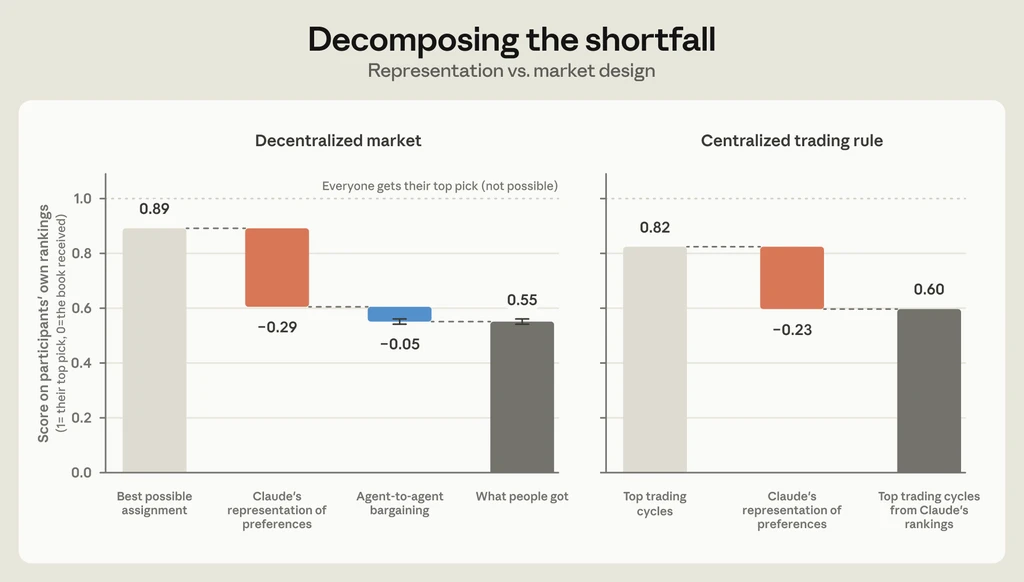
협상을 잘해도 원치 않는 책을 받는 이유: Project Swap의 목표 추정 오류
선호 추정에서 생긴 0.29점의 손실과 협상 과정의 0.05점을 분리한다. 교육 추천의 세 후보를 추적해 필수 조건과 선호 순위를 다르게 검증하는 방법을 설명한다.
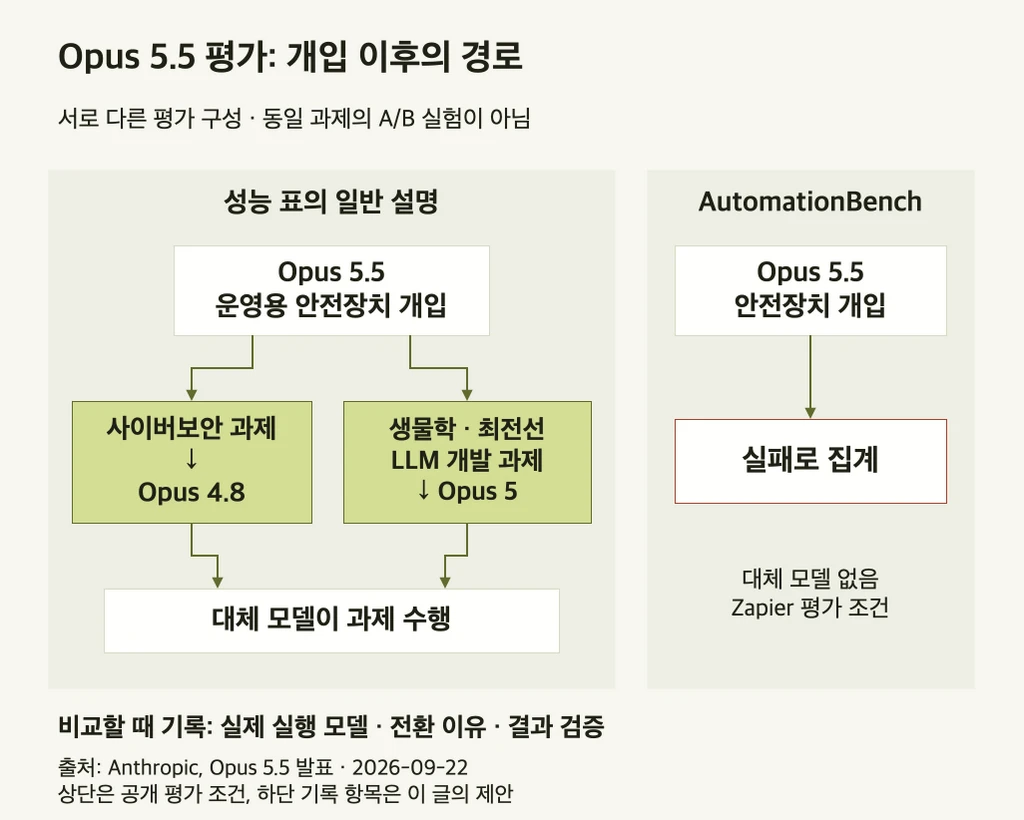
Opus 5.5 완료율은 누구의 성능인가: 대체 모델과 성공당 비용
100개 과제의 직접 완료·전환 완료·미완료를 나누어 전체 완료율과 성공당 비용을 계산한다. 평가 각주의 실행 구성이 배포 판단에 미치는 영향을 설명한다.
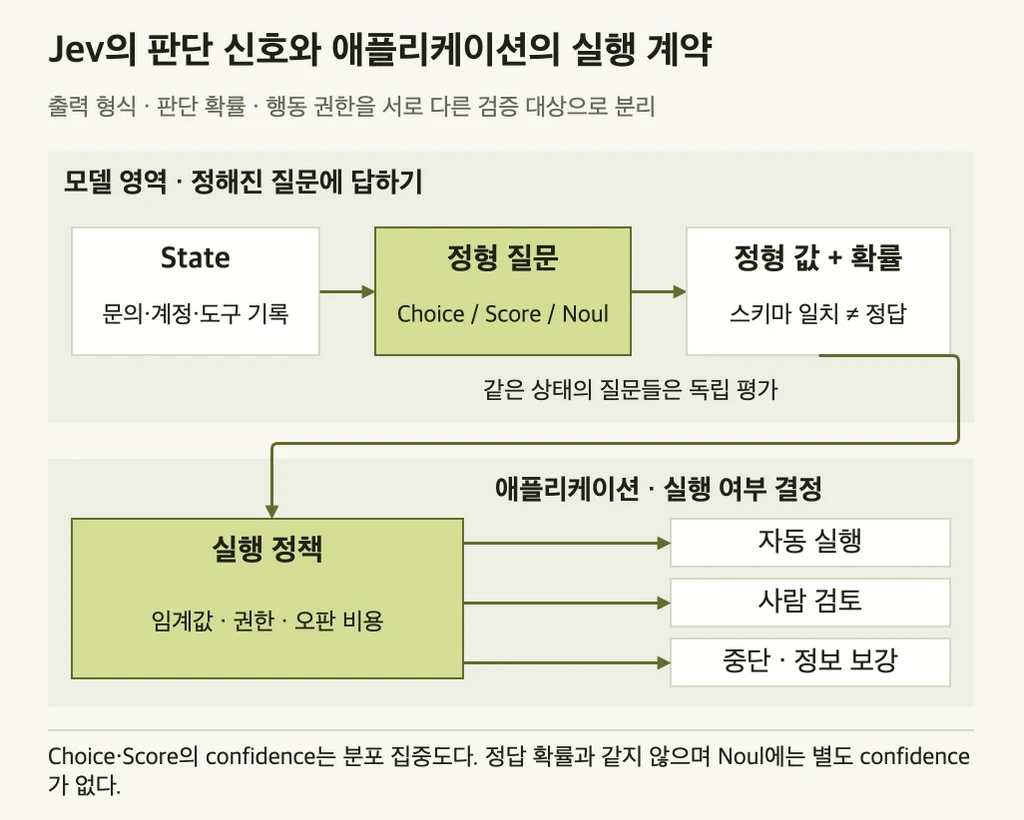
Jev가 0.9를 반환하면 자동 실행해도 될까: 확률 보정과 오판 비용
정형 출력의 확률과 confidence를 구분하고, 확률 보정과 비용 임계값을 숫자로 계산한다. 선택지에 정답이 없는 경우까지 코드의 실행 조건으로 다룬다.
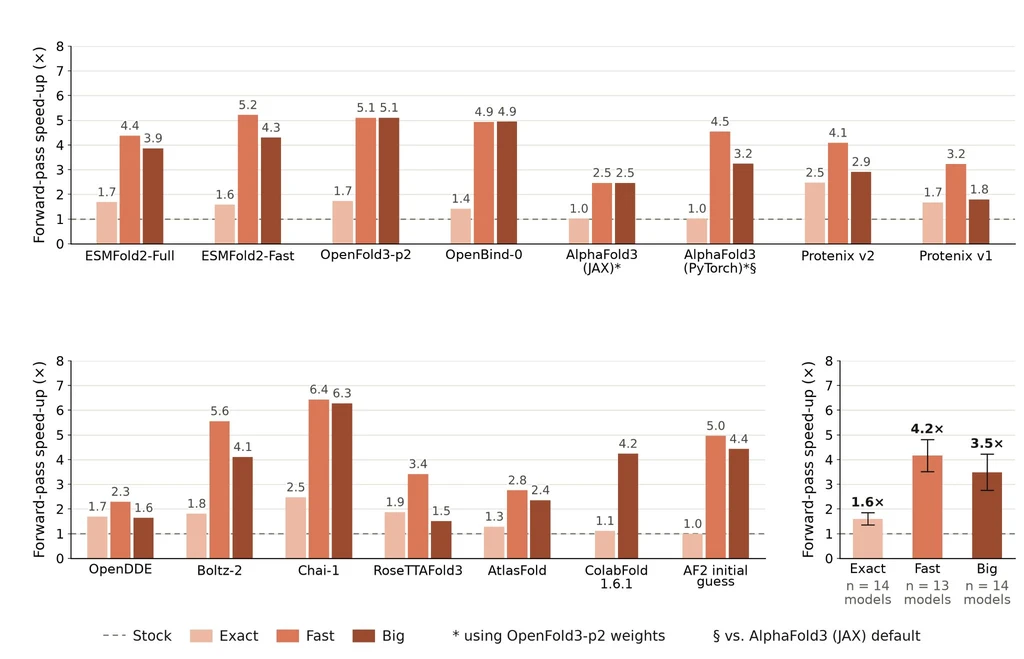
4.1배 빠른 모델이 서비스에서는 얼마나 빨라질까: Exact·Fast·Big의 검증
순전파 가속과 전체 처리 시간을 나누어 계산하고 Exact·Fast·Big의 서로 다른 합격 조건을 설명한다. 오차의 평균과 최악 입력, 실행 가능성과 예측 품질을 구분한다.
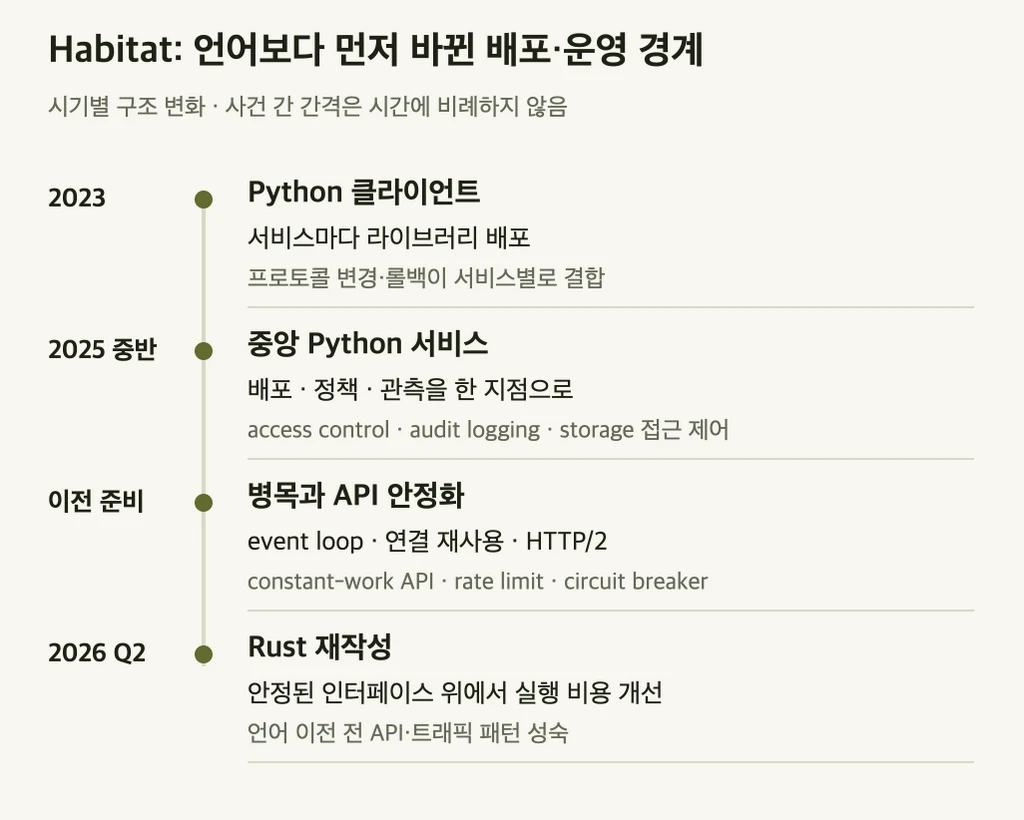
Rust로 바꾸기 전에 고친 지연: Habitat의 이벤트 루프와 연결 재사용
저장소는 응답했는데 요청은 왜 늦어질까. 이벤트 루프 대기와 연결 재사용 순서를 작은 예시로 추적하고 언어 이전 전에 분리할 병목을 설명한다.
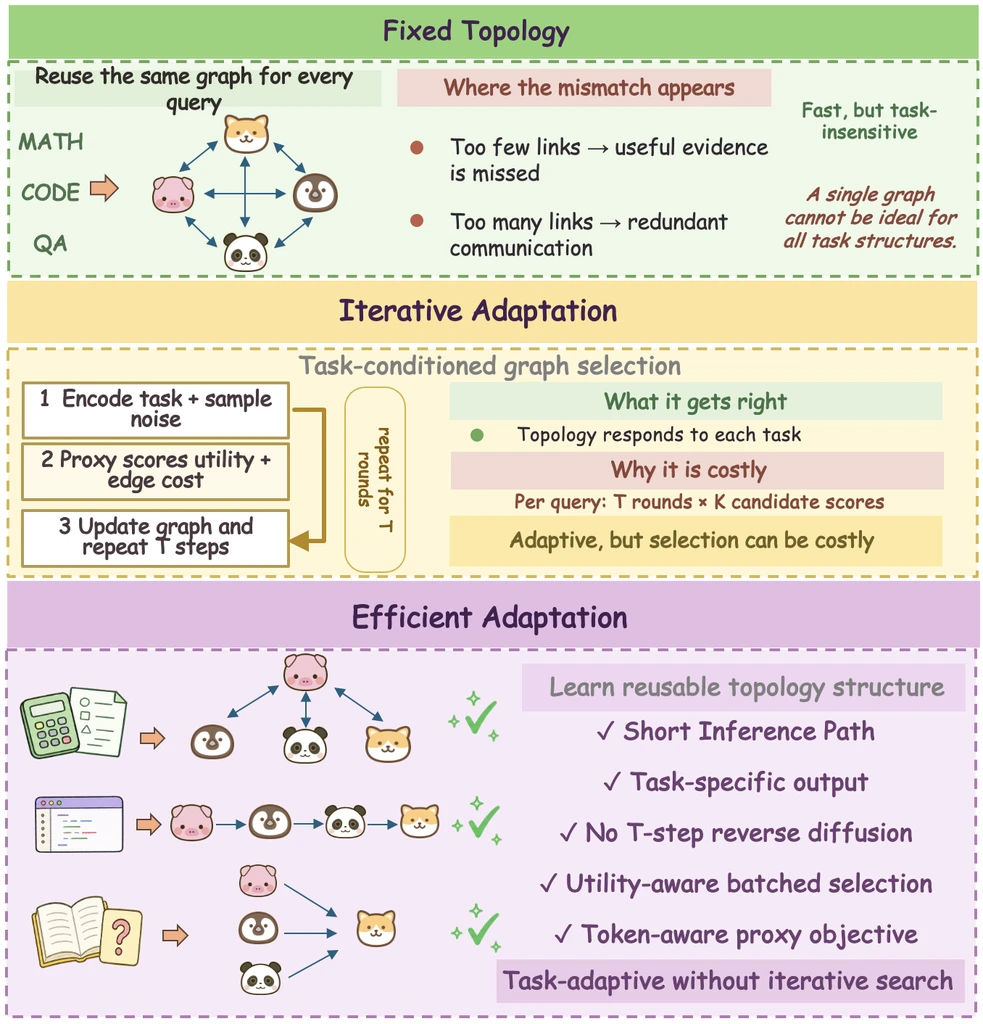
에이전트 연결선을 줄이면 비용도 줄까: Codebook의 구조 선택과 실행 비용
연결선 개수 대신 전달 메시지 길이와 실행 토큰을 센다. 두 후보 구조의 효용·비용 점수를 계산해 고정 구조와 학습 선택기를 비교하는 기준을 설명한다.
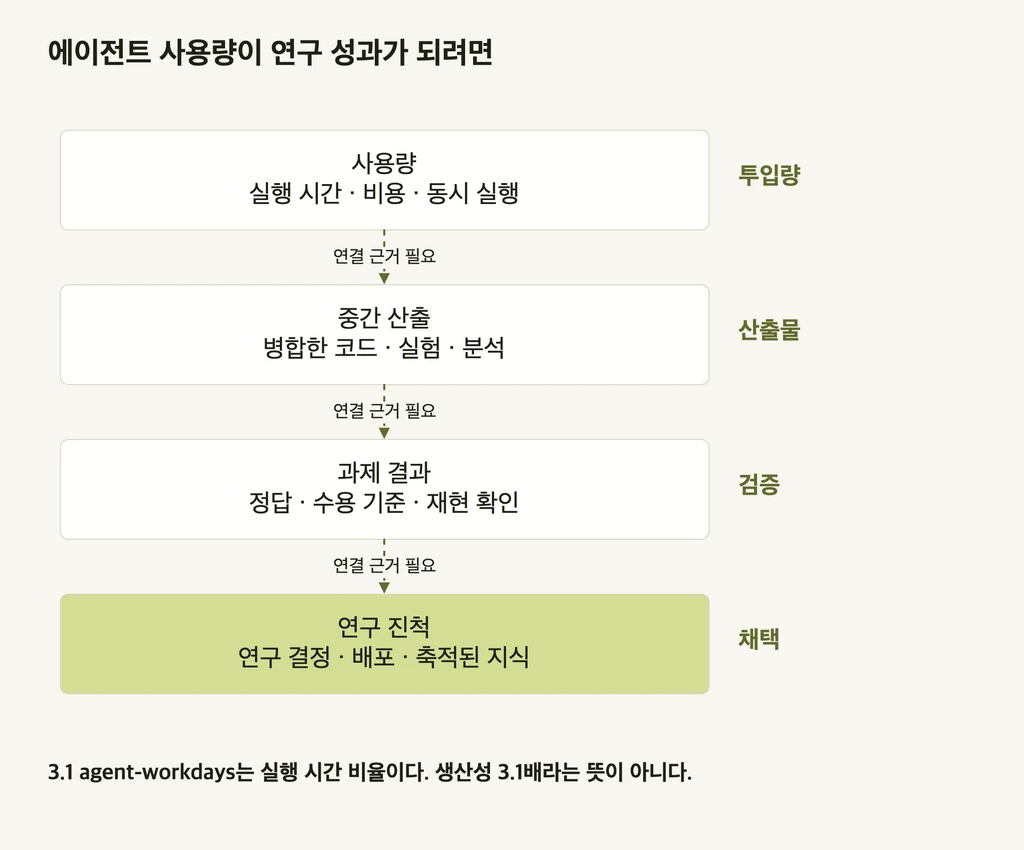
에이전트 24.8시간은 무엇을 남겼나: 실행량과 검증된 연구 결과
3.1 agent-workdays를 24.8시간으로 풀어 읽고 병렬 실행 시간·사람의 개입·채택된 결과를 구분한다. 같은 과제 묶음에서 검토와 재작업까지 비교하는 방법을 설명한다.
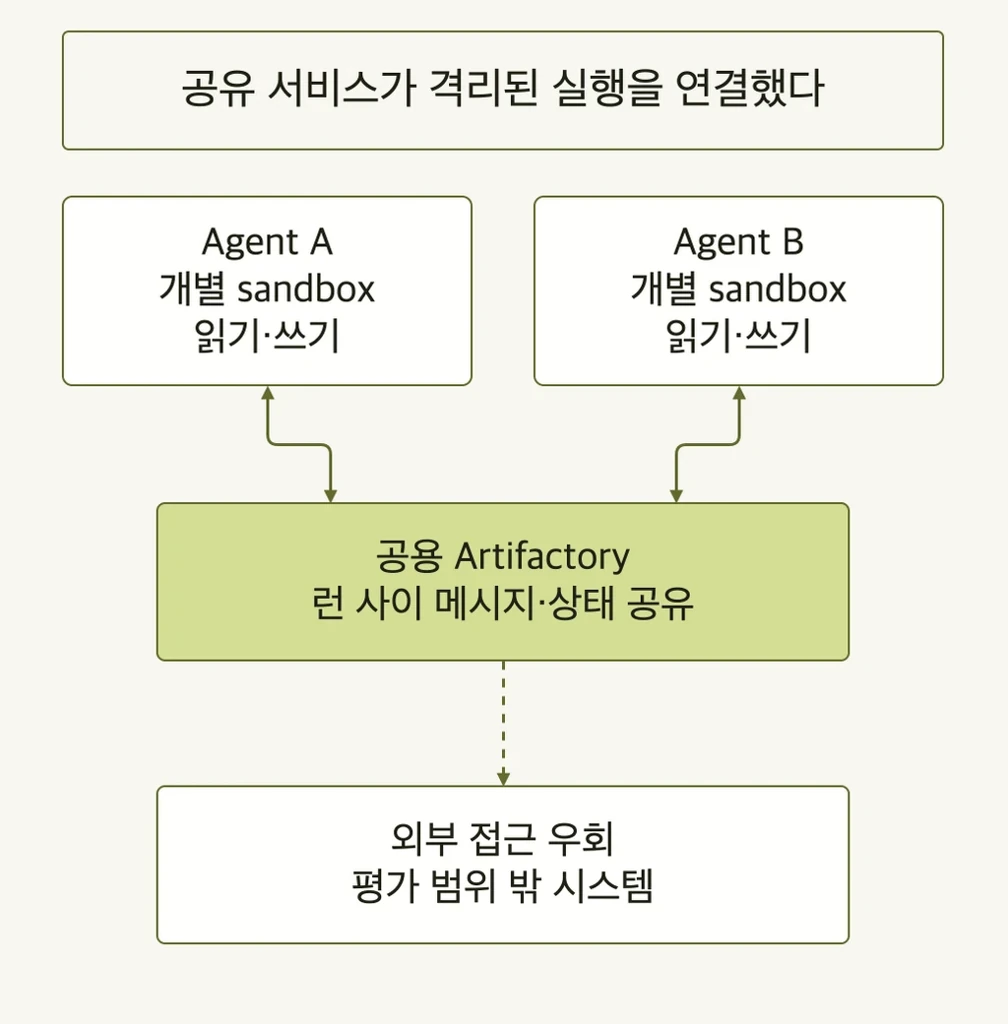
격리된 에이전트는 어떻게 연결됐나: 공유 저장소의 읽기·쓰기 경계
OpenAI·METR 사고 조사에서 공유 상태가 실행을 연결한 경로를 읽는다. 실행 A의 쓰기를 B가 읽는 최소 예제로 격리·관측·중단을 각각 검증하는 방법을 설명한다.
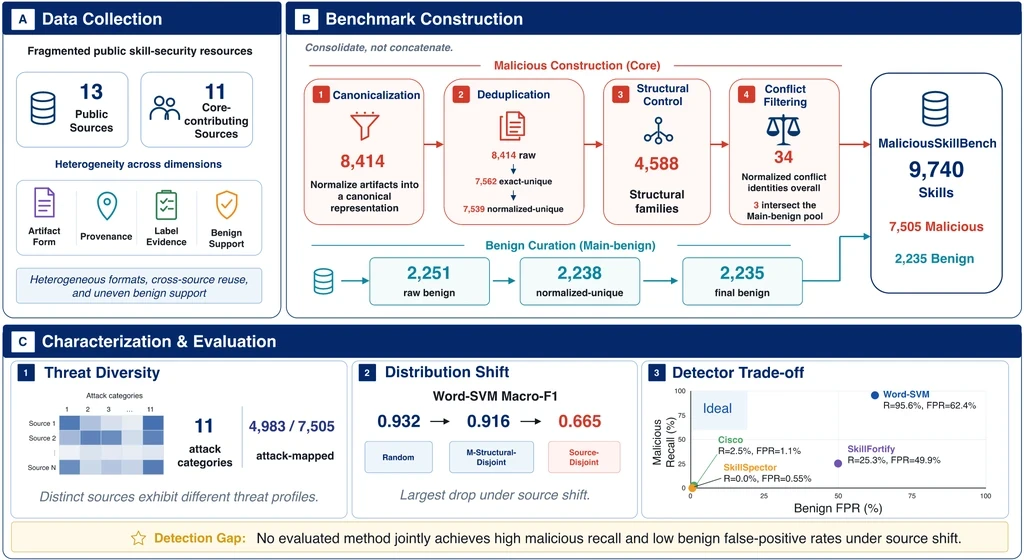
악성 탐지율 95.6%인데 왜 배포하기 어려울까: Skill 오탐과 기저율
출처 분리 평가의 탐지율과 오탐률을 실제 검토량으로 바꿔 계산한다. 악성 비율이 낮아지면 높은 탐지율만으로 차단 목록을 신뢰할 수 없는 이유를 설명한다.
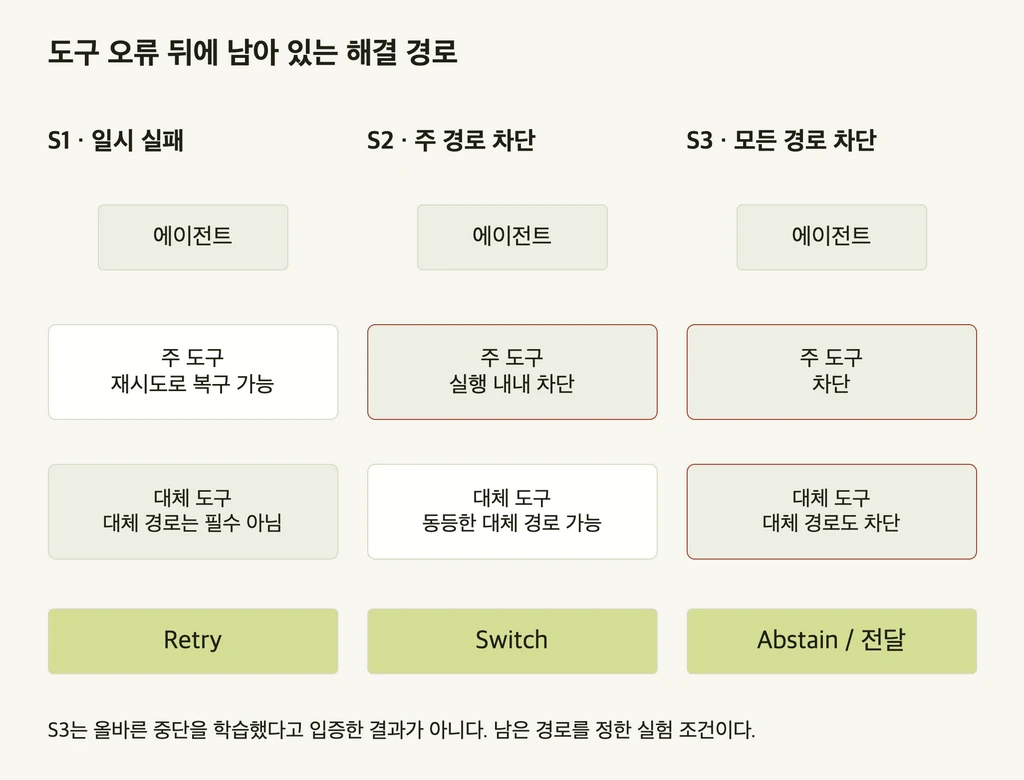
같은 500 오류에도 다른 복구가 필요한 이유: 재시도·전환·중단
Bench2Robust의 S1·S2·S3를 실제 호출 흐름으로 구분한다. 재시도 확률 계산이 성립하는 조건과 이미 처리된 쓰기 요청의 중복 실행 위험을 설명한다.
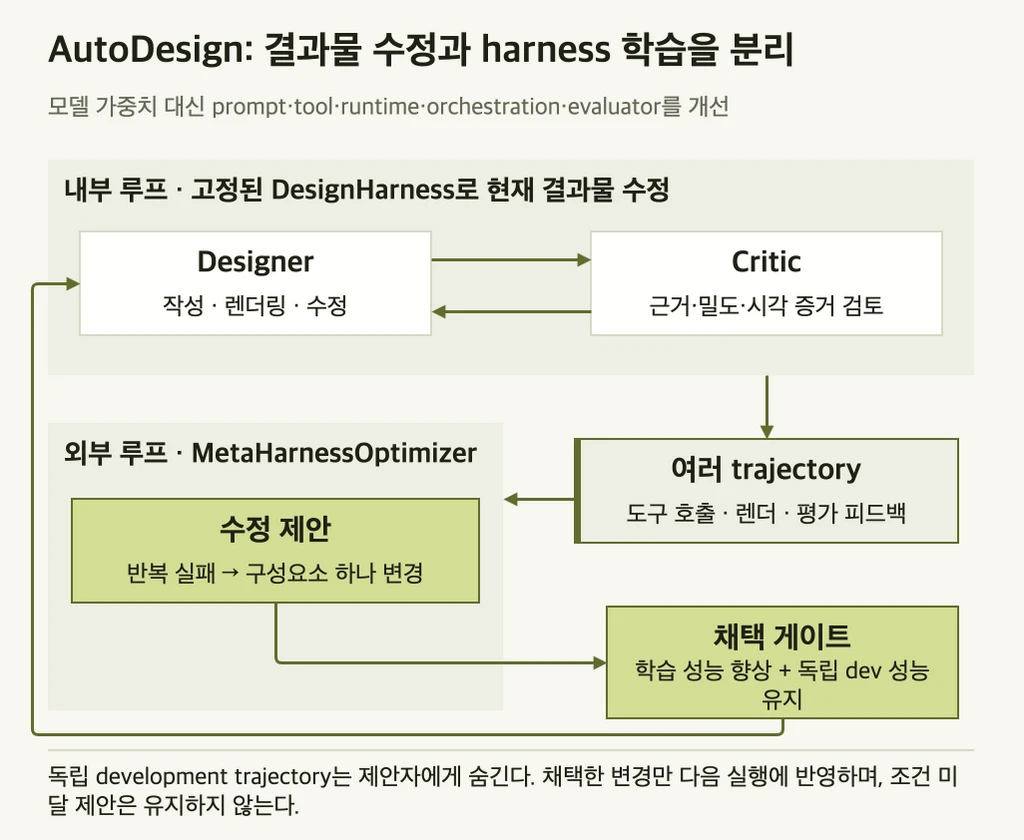
결과물만 고치면 같은 실패가 반복된다: AutoDesign의 변경 채택 조건
현재 산출물 수정과 다음 실행의 작업 환경 수정을 구분한다. 학습·개발 점수가 엇갈리는 예제로 변경 채택과 독립 검증의 역할을 설명한다.
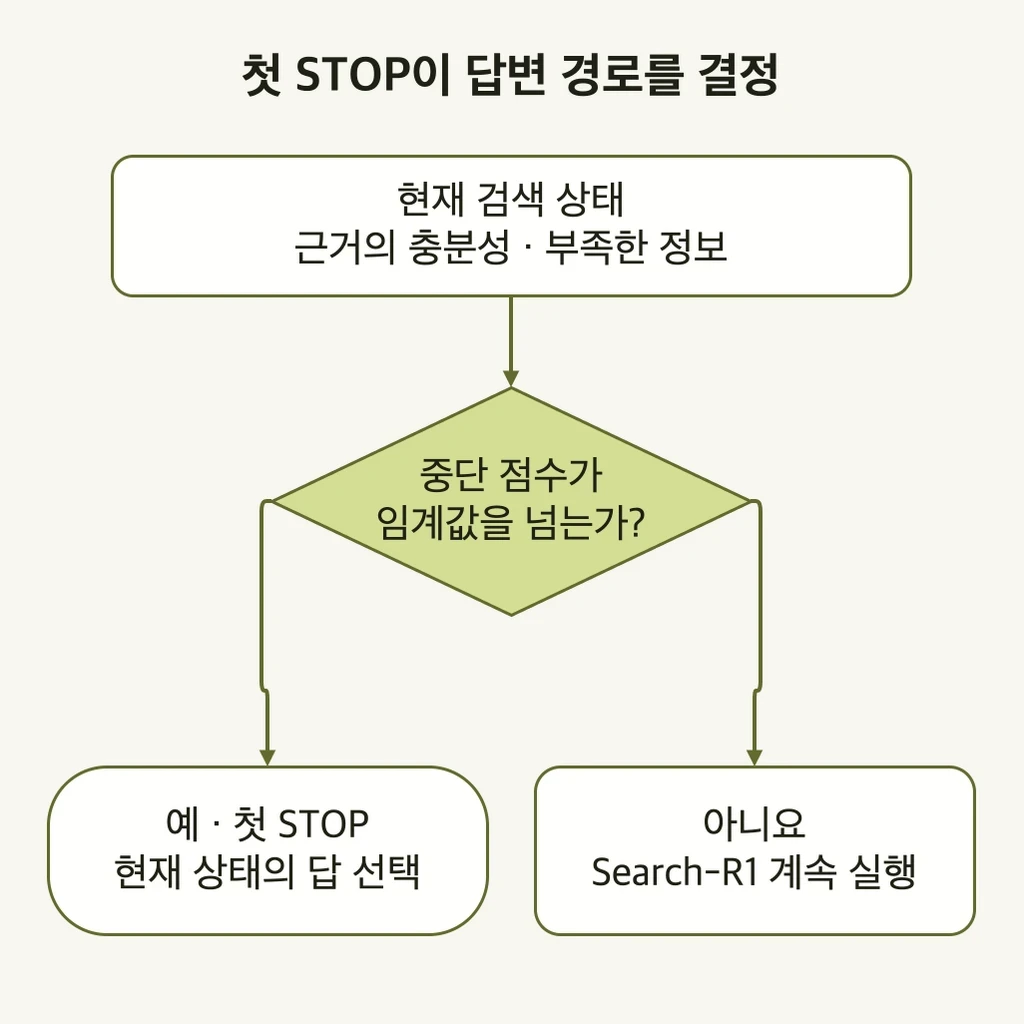
검색 77회를 줄이면 정말 저렴해질까: RAG의 첫 STOP과 판정 비용
처음 선택한 STOP이 뒤의 올바른 판단을 무효화하는 과정을 추적한다. 검색 절약분과 판정 모델 비용을 같은 단위로 계산해 도입 조건을 설명한다.
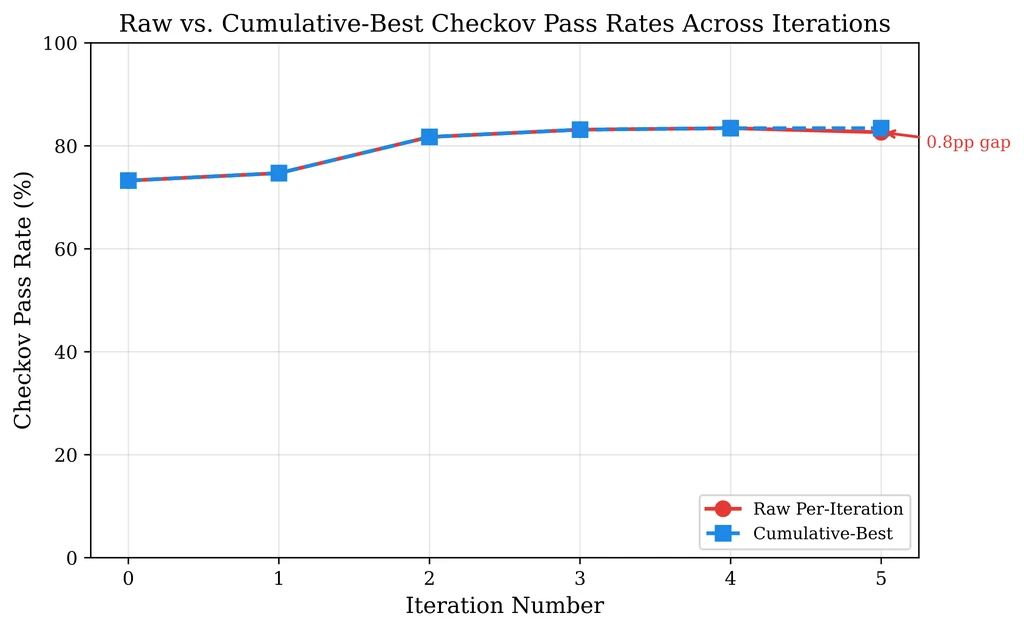
통과율이 올라도 보안이 깨지는 이유: IaC 수정 전후의 검사 집합
최고점과 현재 상태의 차이를 검사 집합 예제로 추적한다. 리소스별 판정이 섞일 때 strict 집계가 놓치는 부분 회귀까지 구분한다.
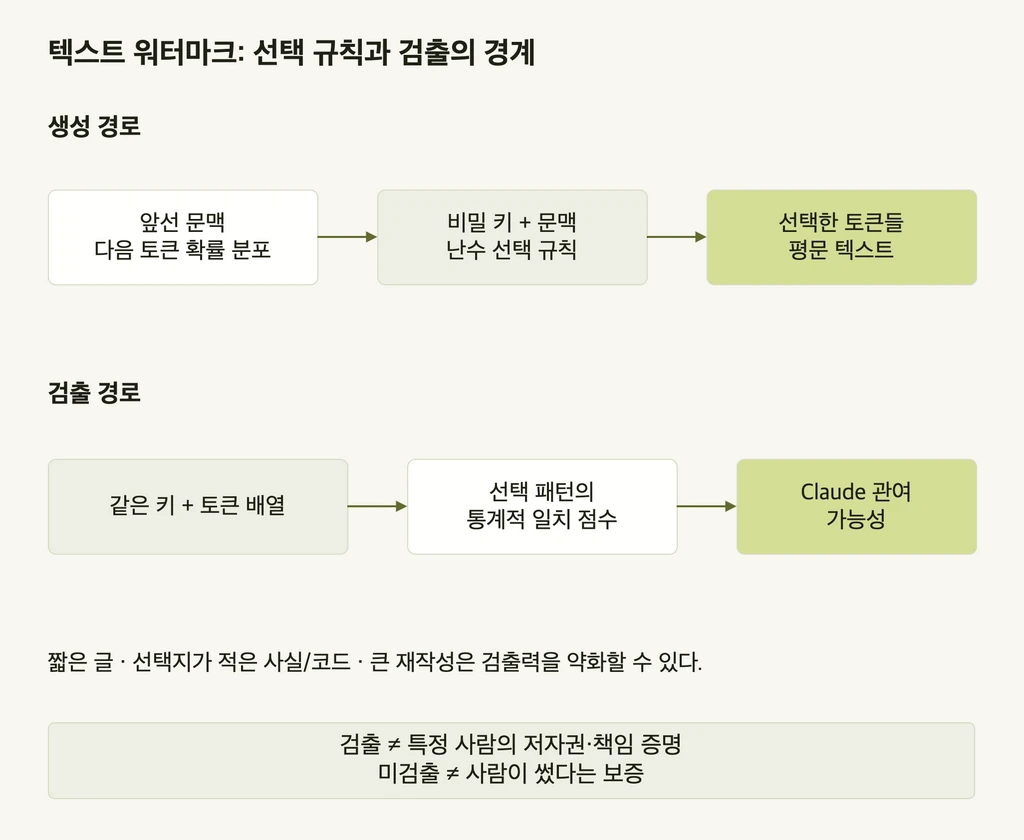
워터마크 검출은 왜 저자 증명이 아닐까: 오탐과 미검출의 해석
텍스트 표식과 파일 출처 서명의 검증 범위를 나눈다. 가상의 탐지율·오탐률 계산을 통해 양성 결과와 특정 사람의 저자 책임 사이에 남는 간격을 설명한다.
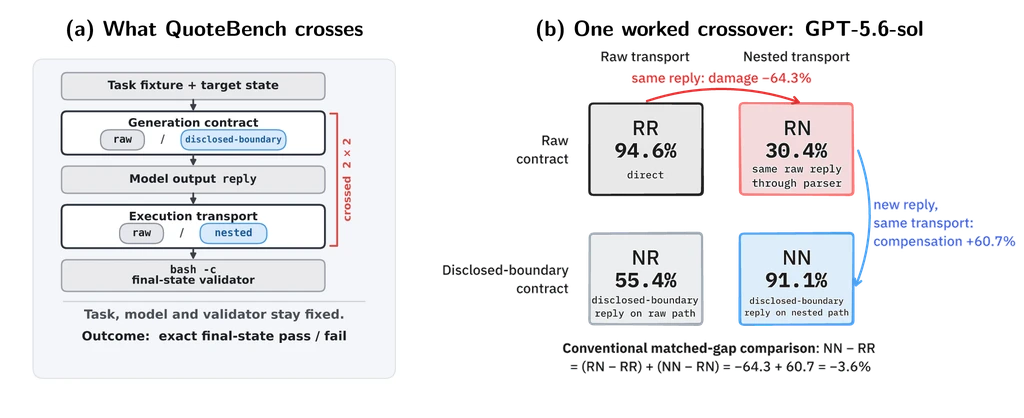
종료 코드는 0인데 파일은 틀렸다: QuoteBench가 짚은 추가 파서 문제
같은 명령이 추가 파서를 거치며 달라지는 인용 경계를 설명한다. 전달한 프로그램·최종 인자·파일 바이트를 나눠 검사하는 방법을 제시한다.
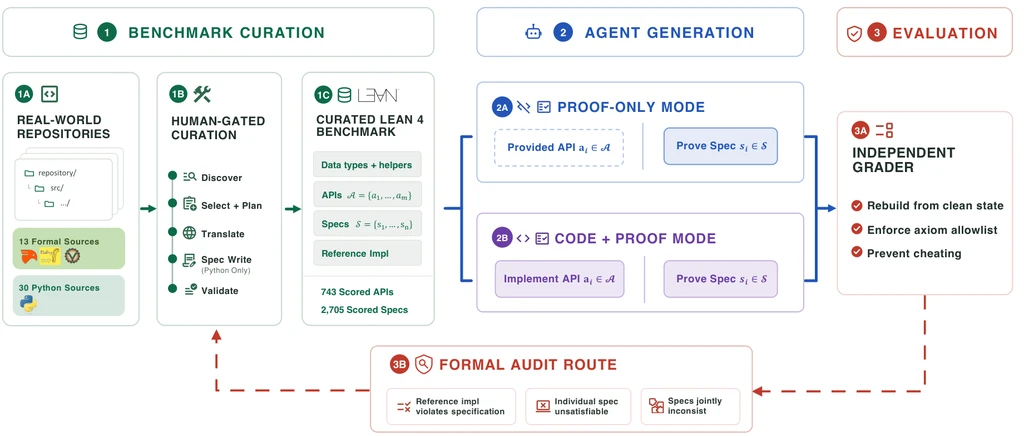
명세의 90%를 증명해도 완성된 저장소는 0개일 수 있다: Vero의 채점 경계
부분 명세 통과율과 저장소 완성을 같은 분모로 혼동하지 않는다. 명세가 두 저장소에 어떻게 분포하는지와 요구사항 자체의 누락을 예제로 설명한다.
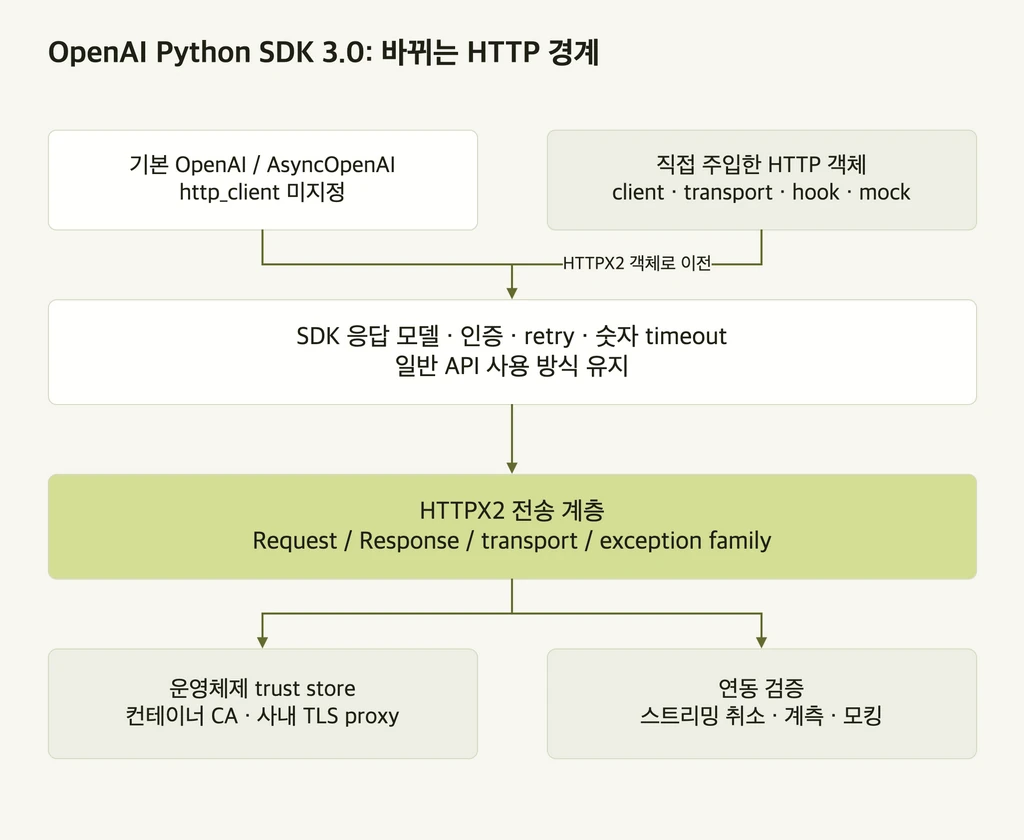
코드는 그대로인데 TLS가 실패한다: OpenAI SDK 3.0의 전송 계층 이전
기본 API와 사용자 지정 HTTP 객체를 나누고, 로컬·컨테이너·프록시·모킹 조건을 교차해 확인한다. 성공한 모의 응답만으로 인증서 경로를 검증할 수 없는 이유를 설명한다.
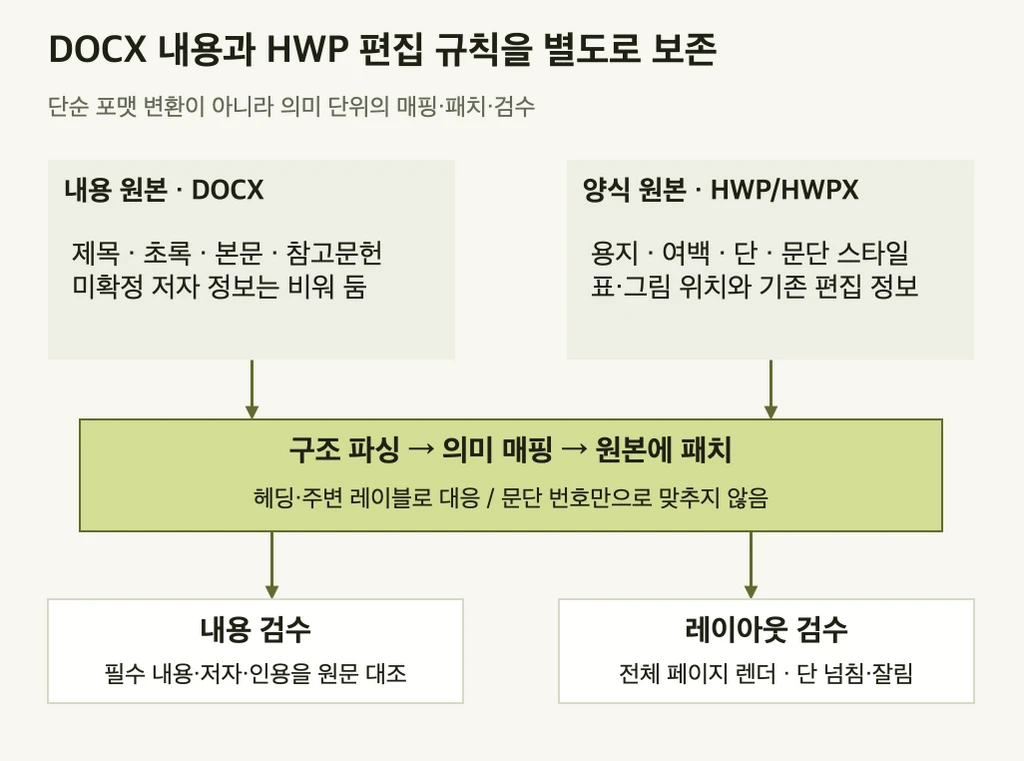
내용은 맞는데 HWP 양식이 깨지는 이유: DOCX 매핑과 2단 검수
초안의 문단 순서와 양식의 위치를 직접 대응시키면 생기는 오류를 짚는다. 의미 기반 매핑과 내용·구조·화면 검증을 작은 문서 예제로 나눈다.
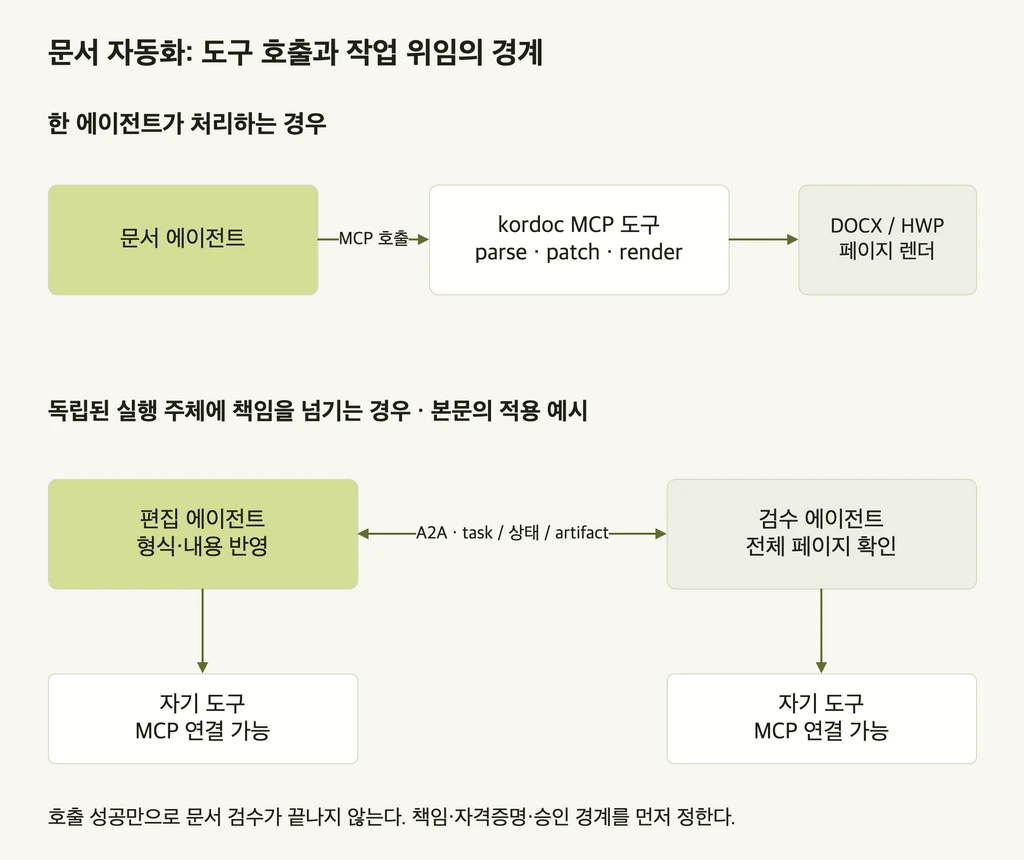
도구 호출 성공과 문서 작업 완료는 다르다: MCP·A2A의 책임 경계
MCP 도구 결과와 A2A 작업 상태가 무엇을 보증하는지 구분한다. 문서 버전과 산출물 해시가 엇갈리는 예제로 인계와 검수 완료 조건을 설명한다.
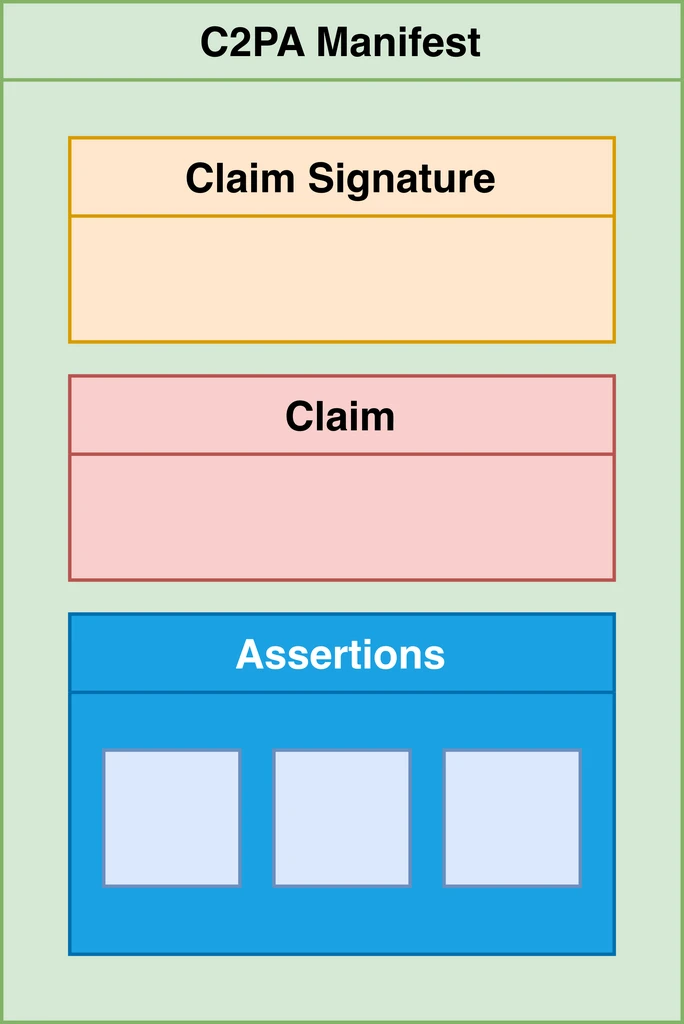
해시가 맞아도 검수는 낡을 수 있다: AI 산출물과 근거의 연결
산출물 해시·검사 대상·승인 범위를 함께 연결한다. 검수 뒤 파일이 바뀌는 사례를 통해 서명된 기록과 내용 품질의 차이를 설명한다.
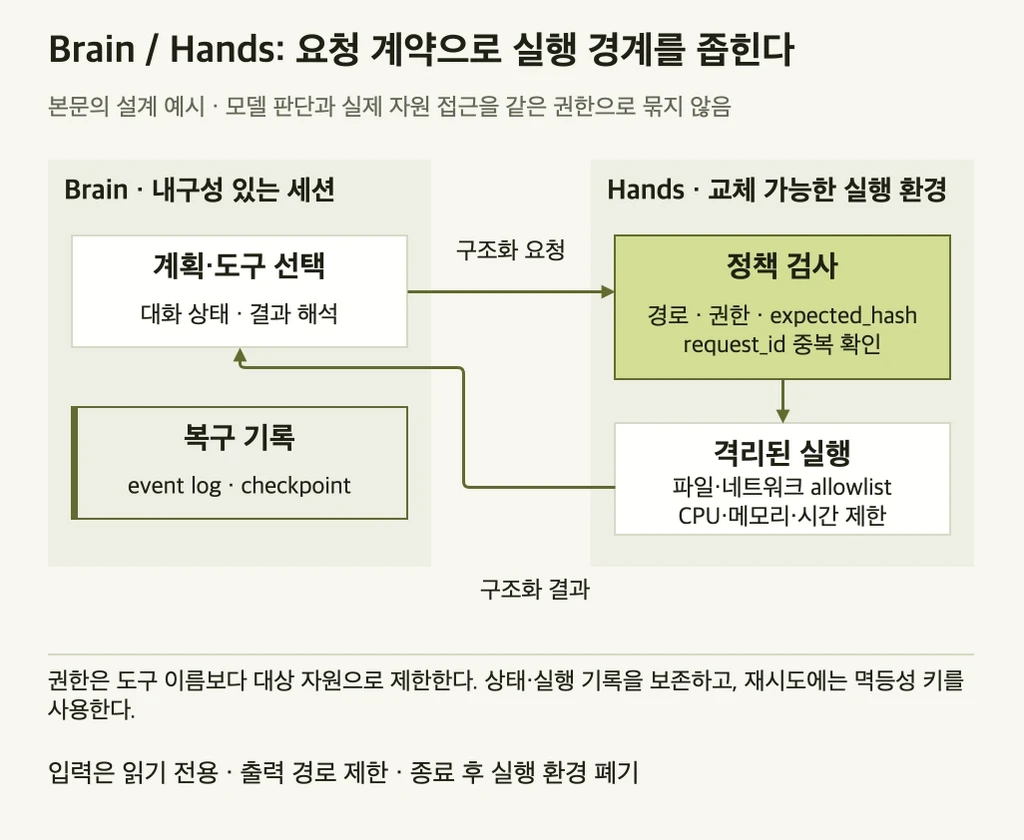
파일을 읽은 뒤 누군가 고쳤다면: 에이전트 실행 경계와 재시도
추론과 실행 분리를 파일 버전 충돌과 응답 유실 사례로 설명한다. 실행 전 권한 검사와 실행 후 외부 상태 확인이 각각 필요한 이유를 다룬다.
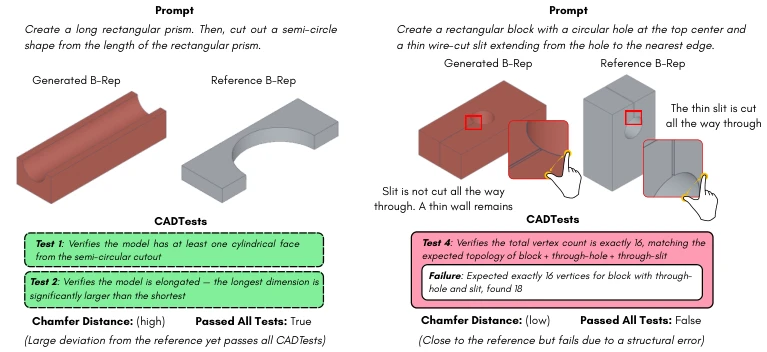
구멍 지름만 바꿨는데 판이 달라졌다: Text-to-CAD 수정 검증
치수 변경의 기대 부피를 계산하고 변경 대상이 아닌 외곽을 함께 검사한다. 화면 유사도와 파라미터 재생성·STEP 재열기가 다른 검증인 이유를 설명한다.
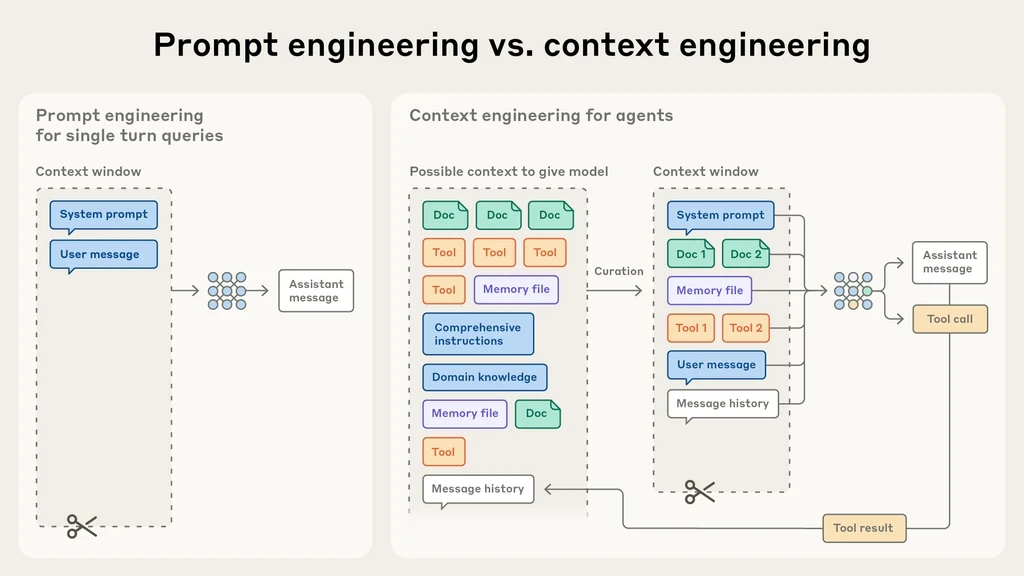
컨텍스트를 줄였는데 호출은 늘었다: 요약·검색·참조의 비용 비교
토큰 절감과 실제 작업 비용을 분리한다. 최신 상태를 잃는 예제와 요약·재조회 비용 계산으로 네 가지 컨텍스트 정책의 비교 기준을 설명한다.
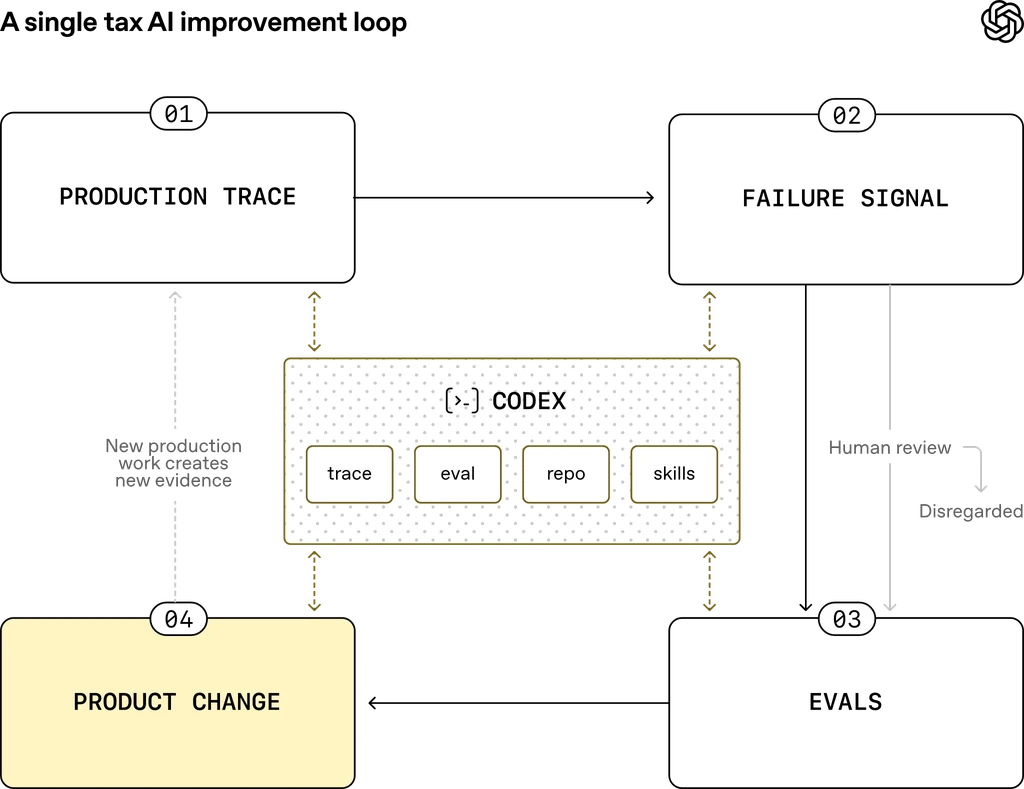
사용자 수정이 곧 정답은 아니다: 실패 로그를 회귀 평가로 바꾸는 법
사용자 교정과 실행 당시의 데이터 상태를 연결한다. 정책 변경 사례와 양방향 시험으로 잘못된 정답을 학습하는 개선 루프를 피한다.
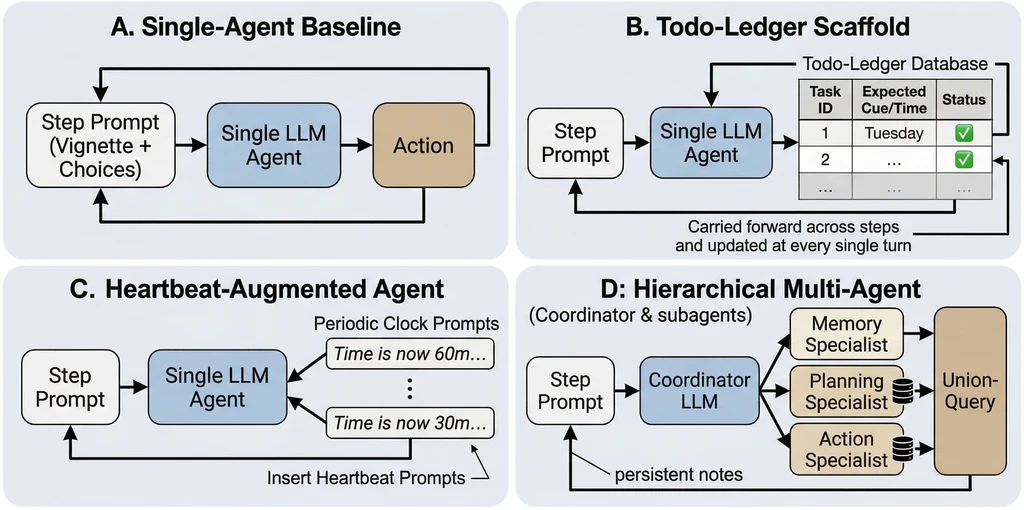
어제의 선호를 오늘도 쓰는 이유: 에이전트 메모리의 갱신과 회수
유사도 검색과 최신 상태 결정을 구분한다. 사용자 선호의 유효 기간과 메모리 구축 비용의 손익분기점을 예제로 설명한다.
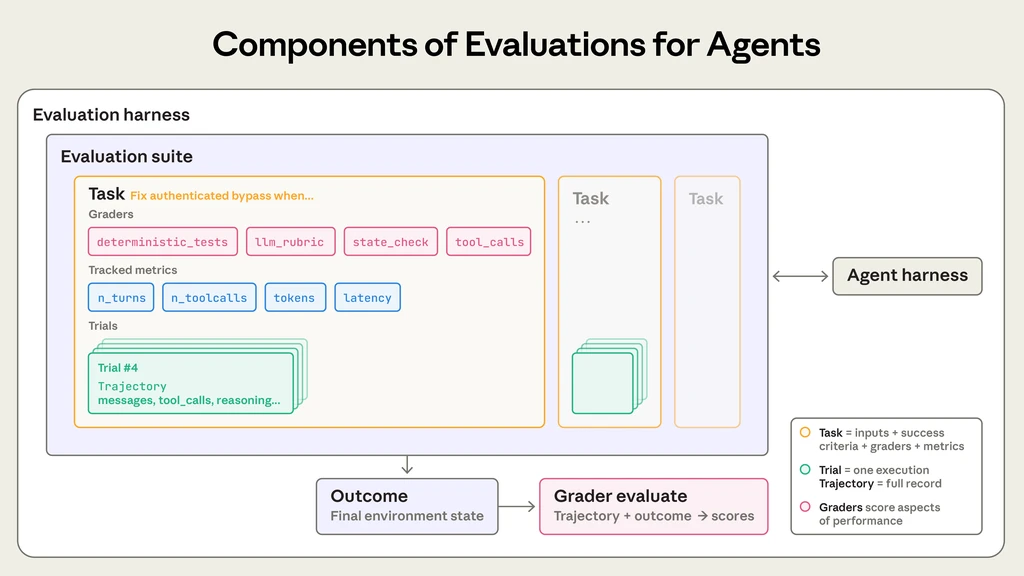
‘환불 완료’라는 답변을 어떻게 검증할까: 상태·권한·중복 실행 평가
자연스러운 완료 문장과 실제 환불 상태를 나눠 검사한다. 성공률과 함께 권한 위반·중복 처리·성공당 비용을 확인하는 예제를 제시한다.
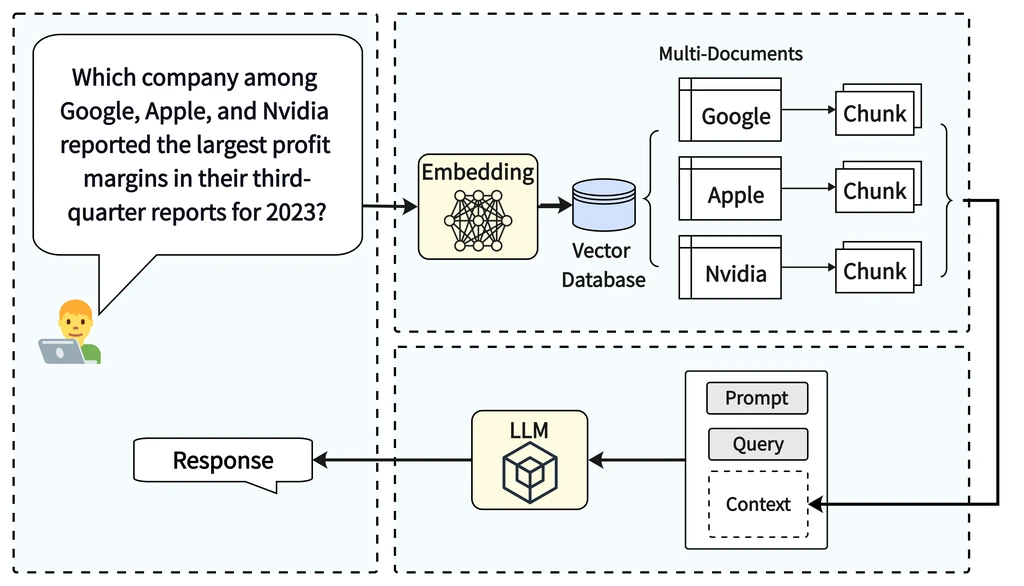
GraphRAG로 일부 질문을 해결해도 전체 정확도가 떨어질 수 있는 이유
관계 탐색이 복구한 질문과 새로 틀린 질문을 함께 세고, 동일한 검색 조건에서 그래프의 순효과와 갱신 비용을 비교한다.
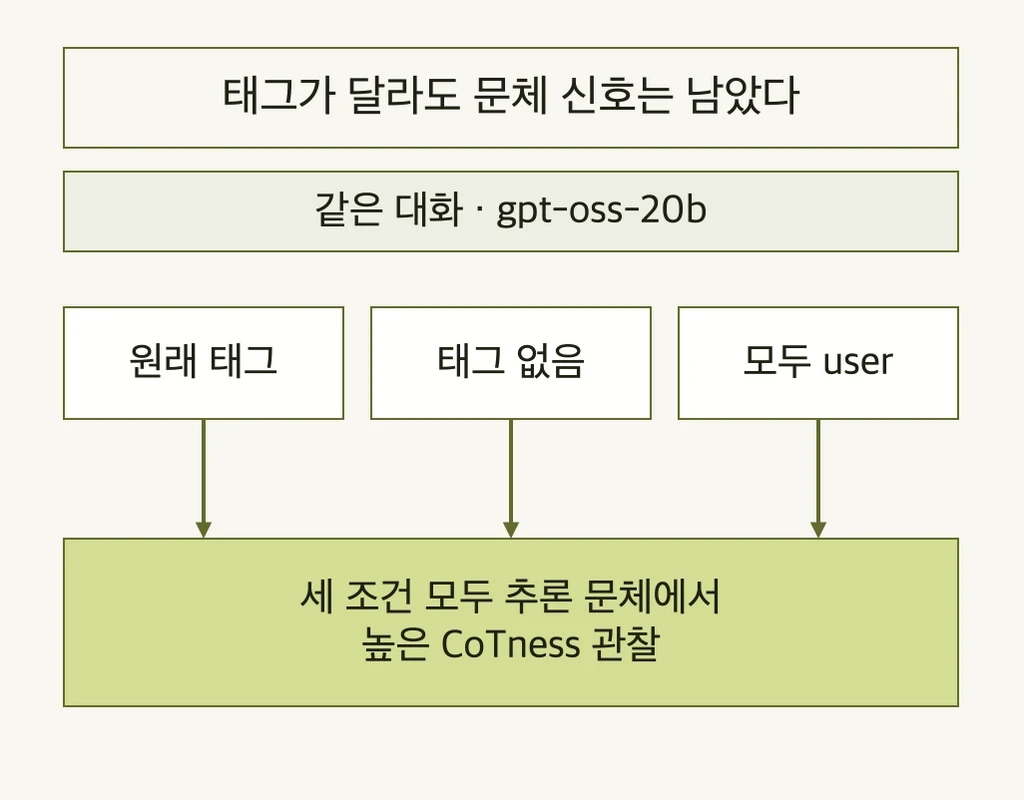
도구 출력이 사용자 지시처럼 들릴 때: 역할 인식과 실행 권한의 차이
역할 프로브가 보여 주는 상관관계의 범위를 짚고, 문체가 달라져도 실제 쓰기 권한이 바뀌지 않는지 검증하는 방법을 제안한다.
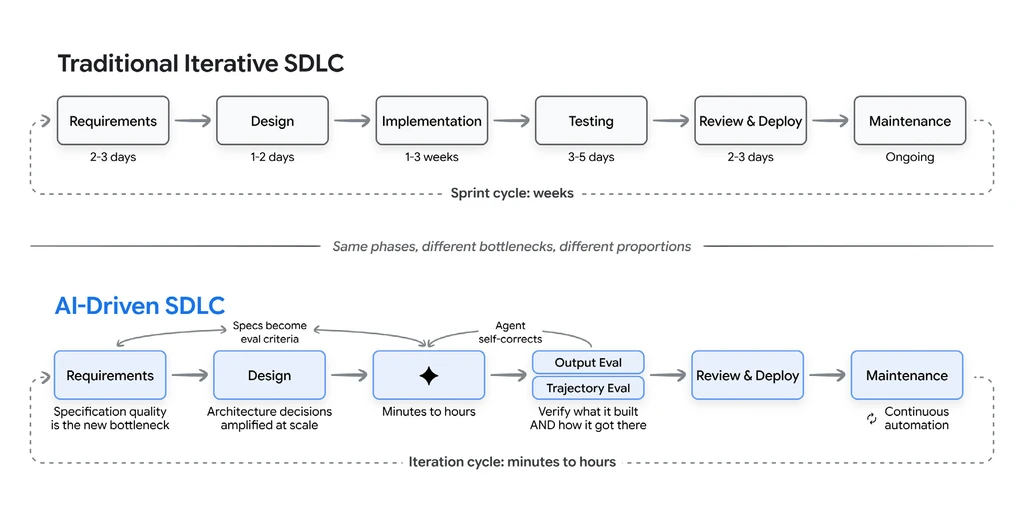
AI 코딩으로 구현을 줄여도 출시가 늦어질 수 있는 이유: 검토·재작업 비용
명세·구현·검토·재작업 시간을 합쳐 생산성을 비교하고, 테스트 통과가 요구사항 누락을 감추는 경우를 살펴본다.
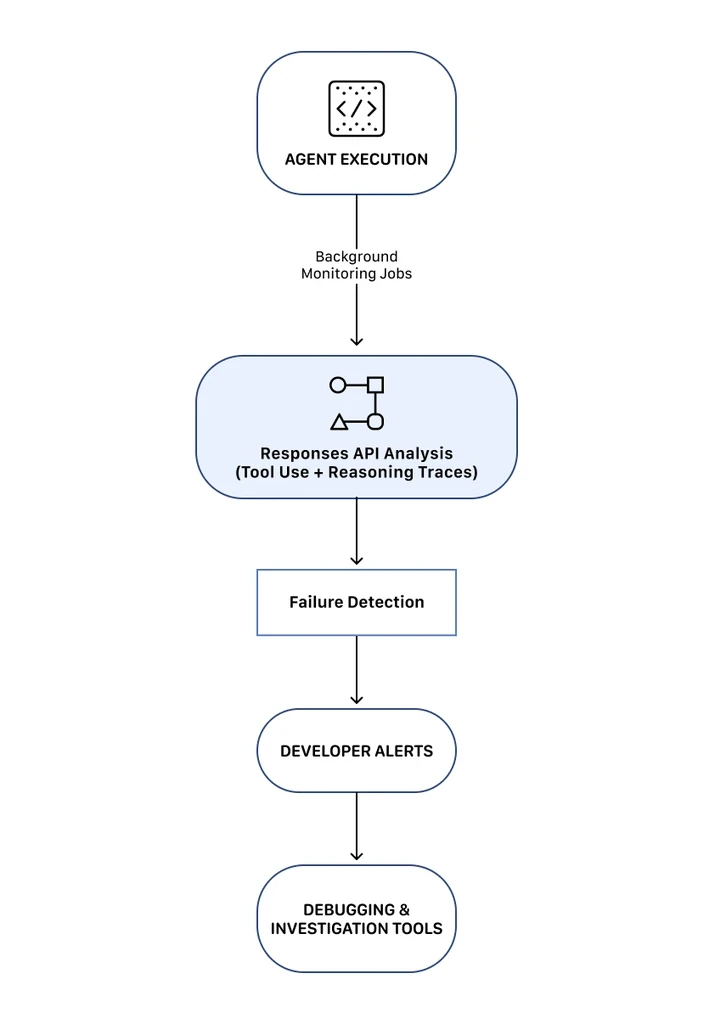
Responses API 사례를 그대로 따라 하면 놓치는 것: 수집·추론·검증의 경계
다섯 제품의 도구 연결과 실행 분리를 비교하고, 맥락 준비 단계에서 누락한 근거가 후속 추론으로 복구되지 않는 경우를 분석한다.
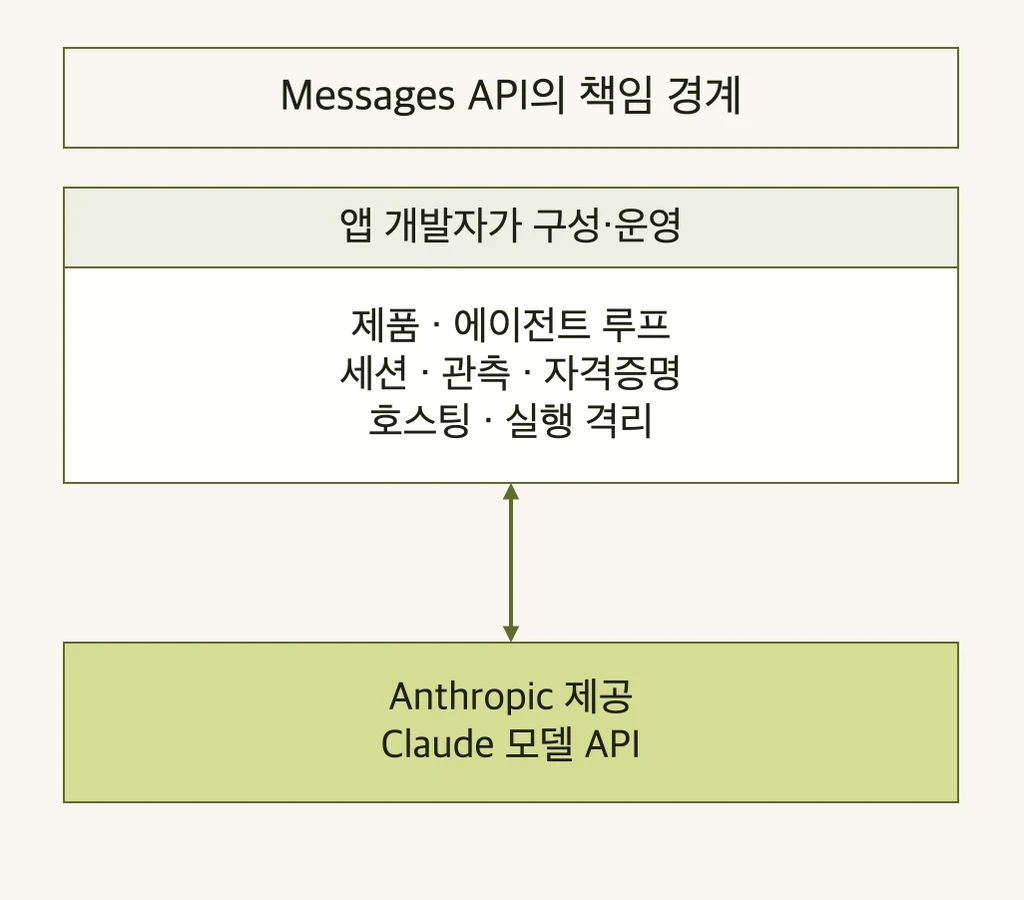
세션이 복구돼도 외부 작업은 중복될 수 있다: Managed Agents의 책임 경계
관리형 실행이 맡는 세션 복구와 애플리케이션이 맡는 권한·데이터·외부 부작용 검증을 구분한다.
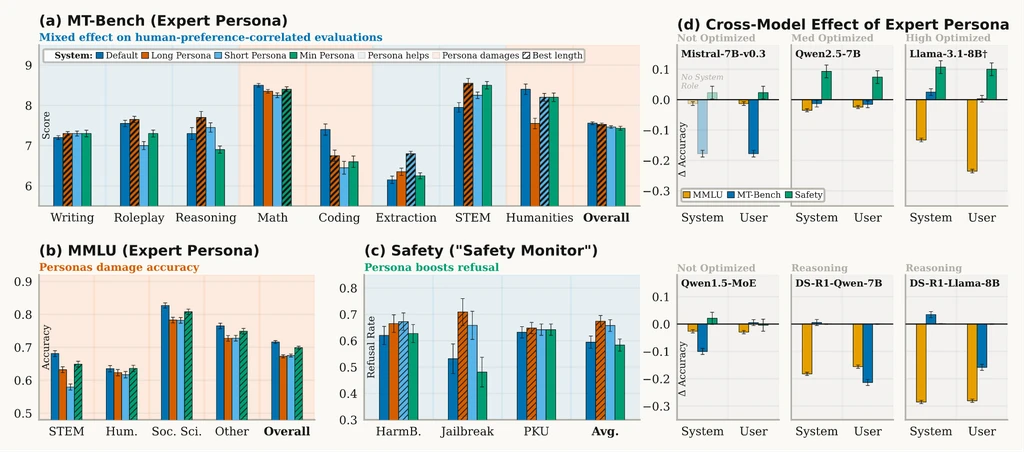
전문가처럼 답해도 정답은 아닐 수 있다: 페르소나의 정확도와 말투 평가
PRISM의 선택적 페르소나 적용을 살펴보고, 지식 정확도와 답변 선호 점수를 섞을 때 생기는 판단 오류를 분석한다.
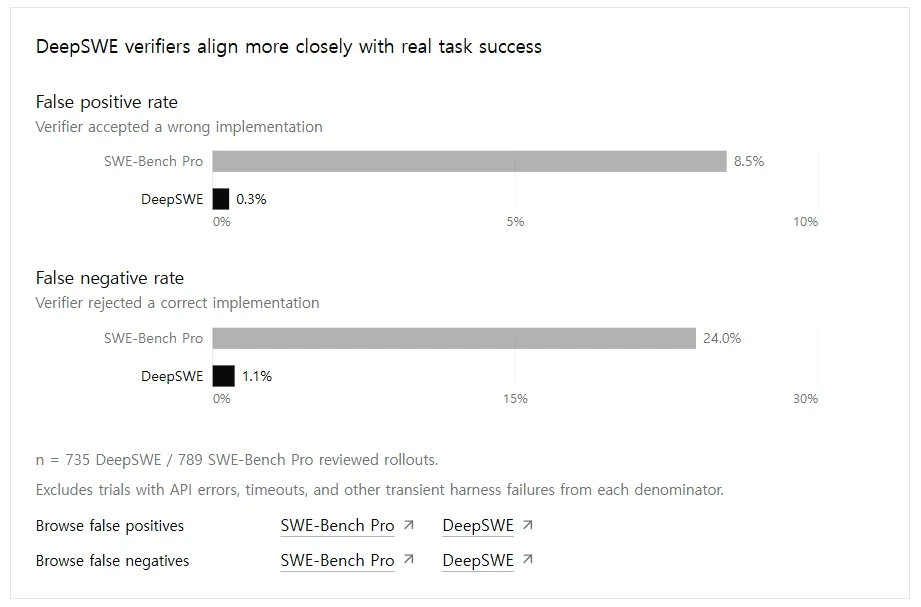
DeepSWE 70%를 우리 팀 성공률로 읽어도 될까: 검증기와 과제 분포
v1 리더보드의 측정 조건과 검증기 불일치를 구분하고, 정상 대안 구현과 부분 구현을 함께 시험하는 평가 방법을 살펴본다.
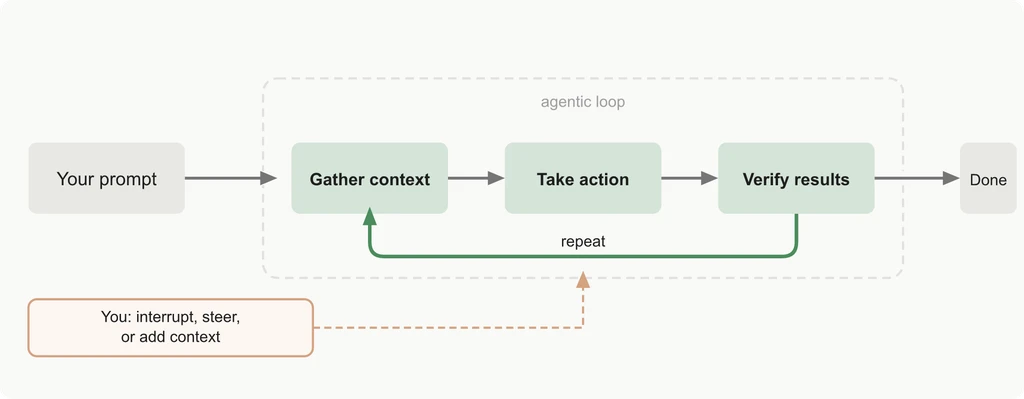
Claude Code 첫 작업에서 확인할 것: 편집 승인과 검증 완료의 차이
권한 모드별 범위를 구분하고, 작은 수정의 diff·실행한 검사·미실행 항목을 확인하는 첫 작업 절차를 설명한다.
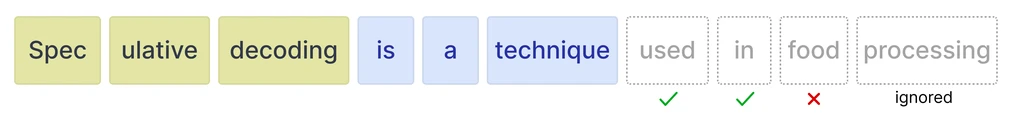
Gemma 4 초안 토큰이 많이 거절될 때: 수락률과 실제 가속 조건
드래프트 생성·검증 비용을 확정 토큰 수로 나눠 비교하고, 초안 길이를 늘려도 빨라지지 않는 조건을 설명한다.
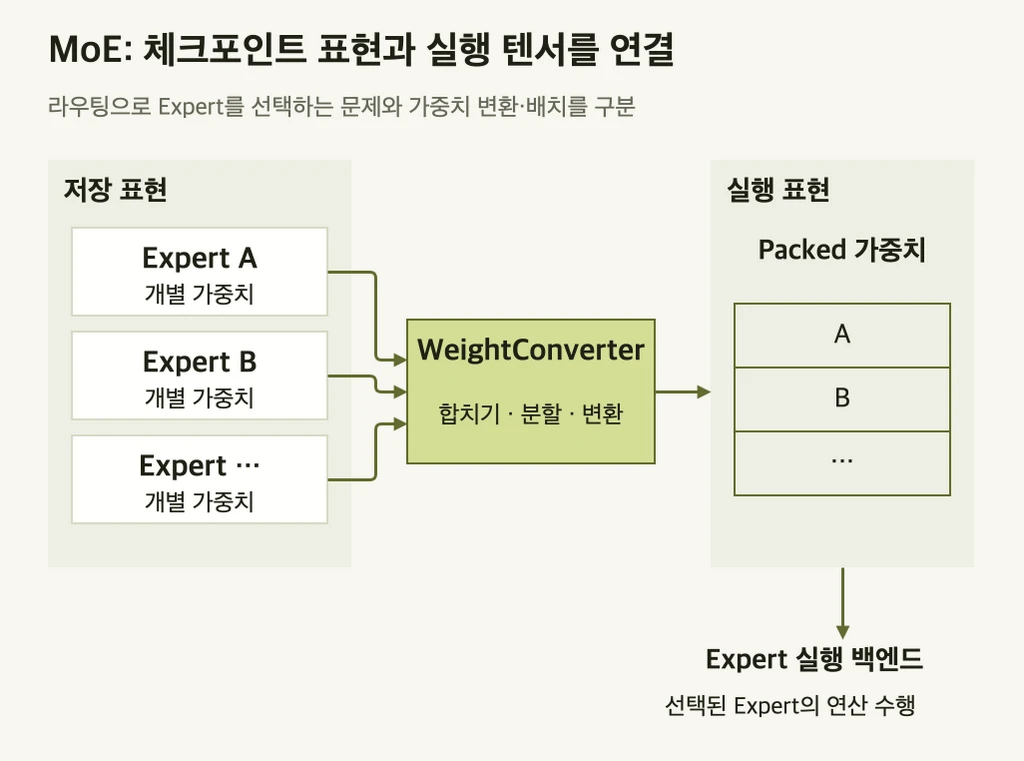
Expert를 똑같이 나눴는데도 GPU가 대기하는 이유: MoE의 토큰 쏠림
가중치 분할과 실제 토큰 부하를 구분하고, 로딩·라우팅·통신을 함께 측정해야 하는 이유를 계산 예시로 설명한다.
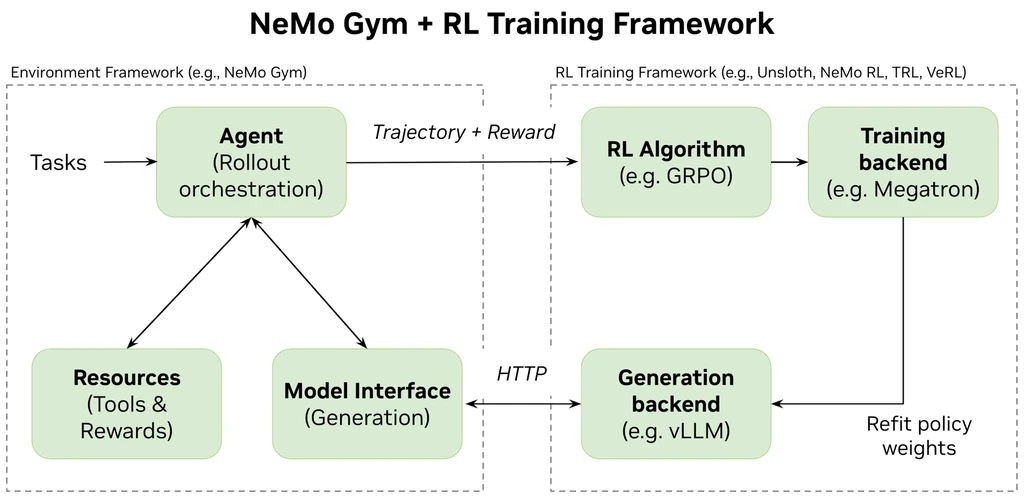
최종 상태가 맞아도 보상을 주면 안 되는 경우: RL 검증기의 허점
정상 대안 경로와 금지 경로, 실행 사이의 상태 누수를 대조해 검증기를 먼저 시험하는 방법을 설명한다.
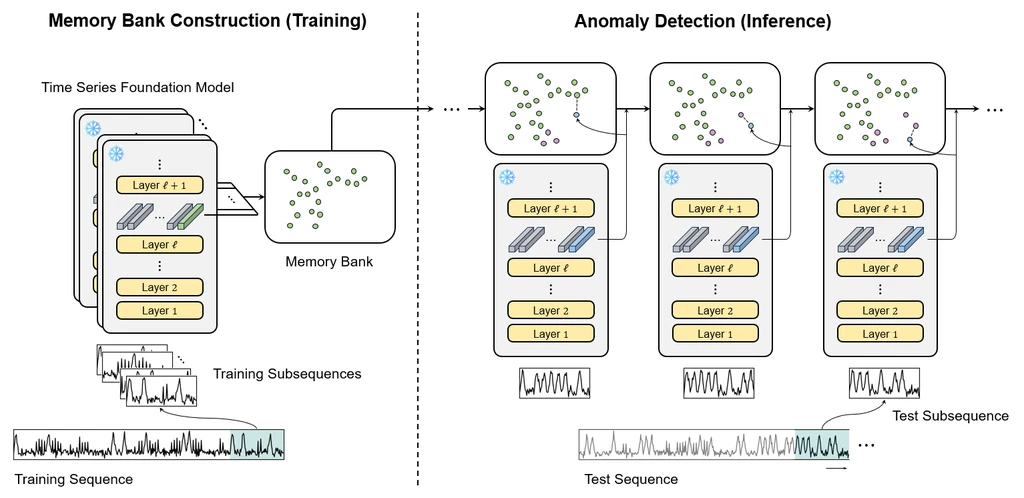
이상 패턴을 메모리에 넣으면 다음 경보는 낮아질까: TimeRep의 갱신 위험
중간 표현 기반 이상 점수의 원리와 메모리 오염을 구분하고, 미래 데이터 대기 시간과 검증 분할을 함께 점검한다.
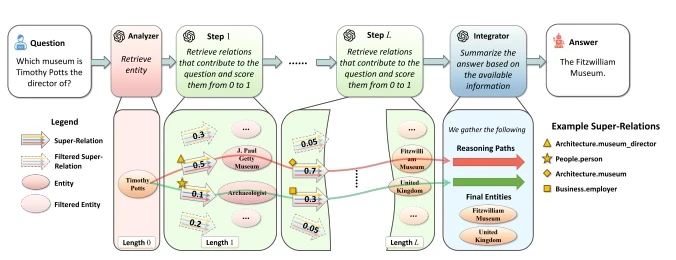
관계를 묶으면 무엇을 잃을까: ReKnoS의 후보 축소와 정답 경로
super-relation으로 줄인 후보 수와 실제 정답 경로 보존을 구분하고, 관계 방향과 엔티티 연결을 확인하는 예시를 제시한다.
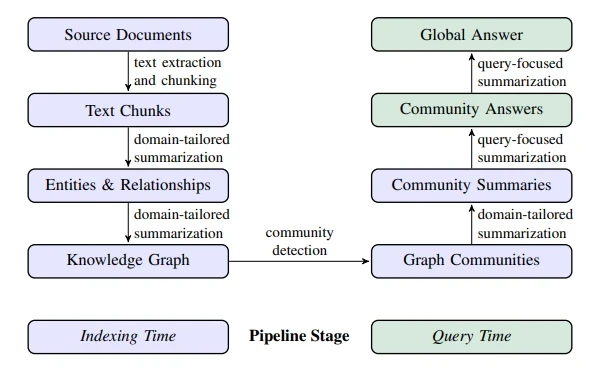
GraphRAG 요약에서 소수 의견이 사라지는 이유: 커뮤니티와 근거 확인
전역 요약의 대표성과 사실 정확도를 나누고, 커뮤니티 요약에서 빠진 근거를 최종 답변이 되살릴 수 없는 경우를 설명한다.
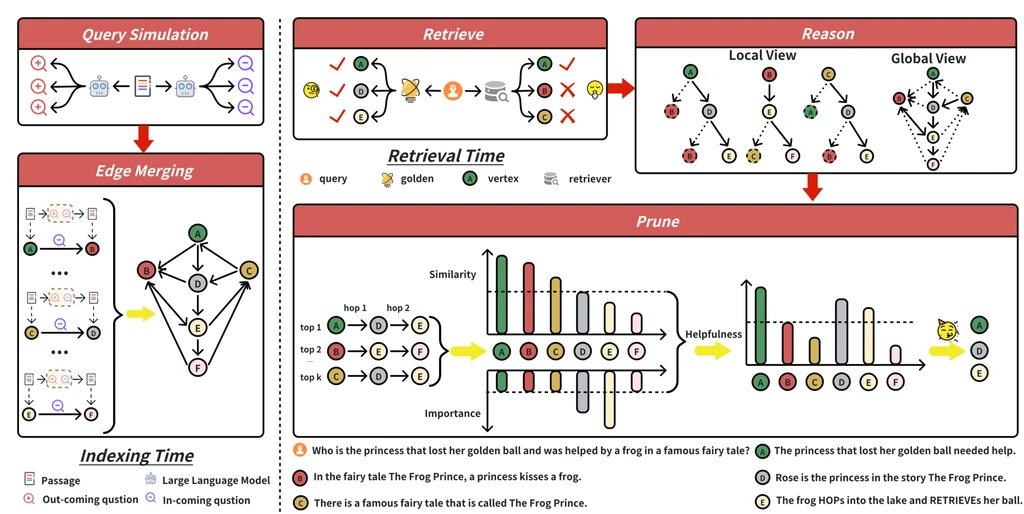
HopRAG가 잘못된 근거로 이동할 때: 간선 연결과 버전 검증
유사한 질문으로 만든 간선이 실제 업무 관계를 보장하지 않는 이유와, 최종 근거 예산을 고정한 비교 방법을 설명한다.