TorchTPU는 언제 빨라질까: 입력 모양과 컴파일 비용의 손익
TorchTPU의 모양별 그래프 재사용을 A·B·A 요청으로 따라가고, 컴파일에 30초를 쓰는 가정에서 반복 횟수별 손익을 계산한다. 커널 가속과 전체 서비스 지연의 차이도 구분한다.
같은 모델을 TPU에서 실행할 수 있다는 사실과 그 모델을 더 싸고 빠르게 운영할 수 있다는 판단 사이에는 컴파일 비용이 놓여 있다. 한 번 만든 실행 그래프를 오래 재사용하면 유리할 수 있지만, 새로운 입력 모양이 계속 들어오면 준비 비용을 반복해서 낸다.
TorchTPU의 실행 모드와 모양별 재사용 방식을 따라가며 컴파일 비용의 손익을 계산해 보자. 아래 시간은 설명을 위한 가정이며 TPU에서 직접 실행해 얻은 측정값은 아니다. 실제 제공자 커널 비교는 이 가정과 구분해 읽는다.
같은 PyTorch 코드 아래에서 실행을 묶는 방법은 달라진다
TorchTPU 저장소 (새 창)는 PyTorch 연산을 TPU에서 실행하는 백엔드와 컴파일 통합 기능을 제공한다. 모델 정의를 별도로 유지하는 부담을 줄이더라도 장치에 전달되는 연산 묶음까지 항상 같아지는 것은 아니다.
Diffusers 안내 (새 창)는 기본 eager가 연산을 하나씩 비동기로 전달하고, optimized eager는 연산을 미뤄 더 큰 그래프로 합치며, compile은 그래프를 미리 컴파일하는 방식으로 구분한다. 이 글에서 확인한 main 문서는 설치한 배포판과 다를 수 있으므로 실제 환경의 버전과 실행 모드를 함께 기록한다.
가상으로 작은 연산 여러 개를 따로 실행하면 각각의 준비·전달 비용이 생긴다. 이를 하나로 합치면 그 비용이나 중간 데이터 이동을 줄일 여지가 있지만, 큰 그래프를 준비하는 시간이 추가될 수 있다. 즉 네이티브 지원은 모델 코드를 연결하는 변화이고, 실행 모드 선택은 반복 계산과 준비 비용을 어떻게 배분할지 정하는 별개의 문제다.
21.5배는 다른 칩과의 비교가 아니다
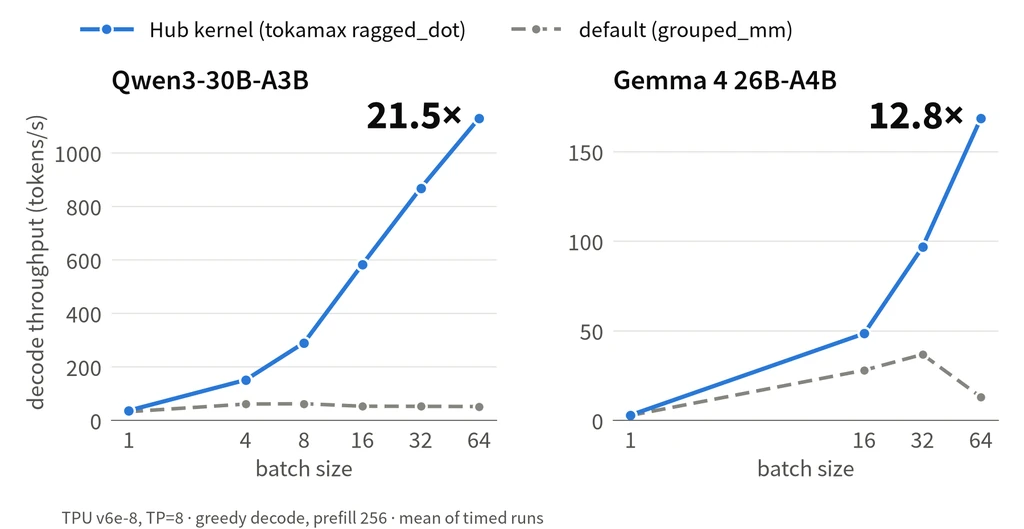
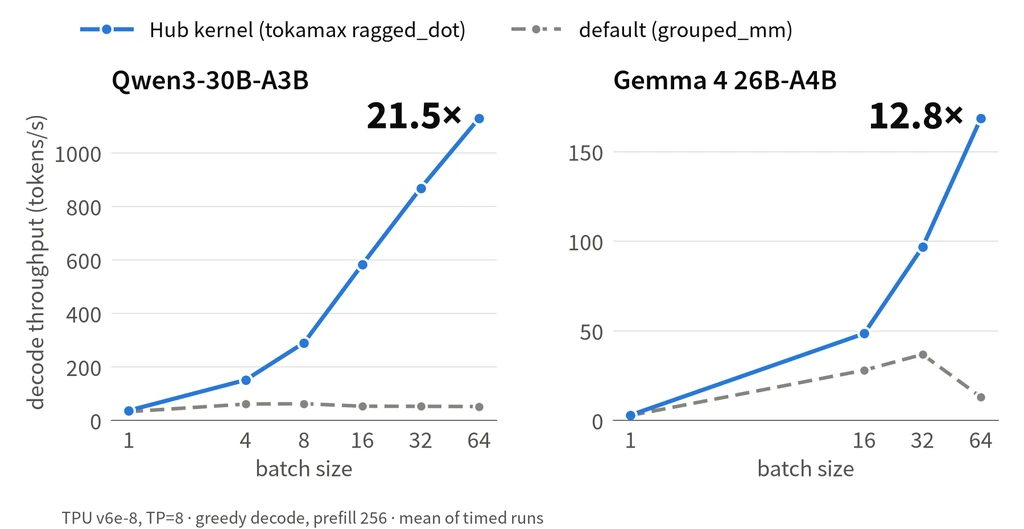
공식 발표 (새 창)의 아래 그림은 TPU v6e-8에서 기본 grouped_mm과 Hub의 tokamax ragged_dot 커널을 비교한다. 배치 64에서 Qwen3-30B-A3B는 21.5배, Gemma 4 26B-A4B는 12.8배의 디코딩 처리량을 보고했다. TP=8, greedy decode, prefill 256 조건이며 두 패널의 세로축 눈금도 서로 다르다.
이 배수는 같은 TPU 환경에서 구현을 바꾼 비교다. 이를 GPU 대비 가속 배수나 개별 요청의 응답 시간 개선율로 그대로 옮길 수는 없다. 배치를 크게 묶어 초당 토큰 수를 늘렸더라도 그 배치가 모일 때까지 기다리는 시간은 별개다.
가상의 서버가 요청을 모으느라 100ms를 기다리고 이후 계산 시간을 20ms에서 10ms로 줄였다고 하자. 계산은 두 배 빨라졌지만 전체 시간은 120ms에서 110ms로 줄어 약 1.09배가 된다. 이는 실제 그림의 벤치마크를 환산한 값이 아니라, 커널 성능과 서비스 지연의 분모가 다른 이유를 보여 주는 예다.
A·B·A 해상도 요청은 그래프 두 종류를 만든다
Diffusers 문서는 dynamic=False로 정적 모양을 사용하고, 새로운 높이·너비가 들어오면 그 모양에 맞춰 다시 컴파일한다고 설명한다. 이미 본 모양은 재사용하며 num_inference_steps만 바꾸는 것은 재컴파일을 일으키지 않는다고 명시한다. 모든 인수 변화가 그래프를 새로 만드는 것은 아니다.
가상으로 A를 1024×1024, B를 768×1024라고 하자. 다른 컴파일 조건이 같고 캐시가 유지된다면 A·B·A 요청은 A 준비, B 준비, A 재사용 순서로 처리된다. 세 번째 요청이 첫 번째와 같은 준비 비용을 다시 낼 필요는 없다. 반면 매번 새로운 해상도를 허용하면 한 번만 쓰고 마는 그래프가 늘어날 수 있다.
그래서 처음 실행한 요청, 이미 준비된 모양, 아직 없는 모양을 나누어 측정해야 한다. 자주 쓰는 해상도를 미리 준비하면 첫 사용자 요청 전에 준비 비용을 지불할 수 있지만 준비 작업 자체가 사라지는 것은 아니다. 해상도를 몇 가지로 묶는 방식도 가능하지만 확대·축소나 패딩이 품질과 계산량에 미치는 영향을 함께 비교해야 한다.
준비에 30초를 쓴다면 몇 번 반복해야 이득일까
가정상 eager는 요청당 1초, 컴파일 뒤 실행은 0.5초, 모양 하나의 컴파일은 30초가 걸린다고 하자. 같은 모양을 N번 순차 실행할 때 eager는 N초, 컴파일 방식은 30+0.5N초다. 두 값이 같아지는 지점은 N=60이며, 이 가정에서는 60번보다 많이 반복해야 총시간이 줄어든다.
같은 모양으로 100번을 실행하면 100초와 80초를 비교하게 된다. 그러나 100번 동안 서로 다른 모양 세 종류를 각각 처음 준비해야 한다면 준비에 90초, 실행에 50초가 걸려 합계 140초가 된다. 실행 한 번의 속도가 빨라졌다는 사실만으로 작업 전체가 빨라졌다고 말할 수 없는 이유다.
이 계산은 컴파일 직렬화, 동일 실행시간, 캐시 유지 등을 가정한 단순 모형이다. 실제 컴파일 비용은 모양마다 다를 수 있고 병렬 실행·메모리·입출력·캐시 정책에 따라서도 결과가 달라진다. 그럼에도 총 요청 수만 보던 질문을 모양별 반복 횟수와 재사용률로 바꿔 준다.
메모리를 옮기는 경로까지 컴파일 범위에 포함한다
공식 Diffusers 안내는 CPU offload의 훅을 torch.compile로 추적할 수 없으므로 반복되는 transformer 블록만 컴파일하는 경로를 제시한다. 여러 TPU에 모델을 나누는 tensor parallelism과 필요할 때 CPU에서 옮기는 offload는 메모리를 확보하는 방식도, 데이터가 이동하는 경로도 다르다.
따라서 이관 시험은 같은 모델·정밀도·입력에서 결과 품질을 먼저 맞춘 뒤 실행 모드, 커널, 모양 분포를 하나씩 바꿔야 해석하기 쉽다. 동일한 요청 묶음에서 첫 호출과 재사용 호출, 새 모양 호출을 나누어 보면 느려진 원인이 계산인지 준비인지도 드러난다. 여기서는 실제 TPU 호환성이나 비용 절감을 검증하지 않았다.
TorchTPU의 가치는 코드를 옮길 수 있다는 데서 시작하지만 운영상의 이득은 반복 패턴에서 결정된다. 어떤 그래프를 얼마나 자주 재사용하는지, 메모리 이동과 대기를 포함해 절약한 시간이 준비 비용을 넘어서는지를 계산해야 이관 판단이 구체화된다.