4-bit AdamW는 무엇을 반올림하나: 역제곱근 오차와 전체 메모리
4-bit AdamW에서 상태 평균을 맞춰도 역제곱근 계수에 오차가 생기는 이유를 계산한다. 모멘트 압축률과 전체 메모리, 검증 손실 차이의 분모를 구분한다.
4-bit AdamW를 쓰면 학습에 필요한 GPU 메모리도 크게 줄어들까. 압축된 옵티마이저 상태의 크기만으로는 판단하기 어렵다. 학습 손실이 유지되는지, 전체 학습의 최대 메모리가 줄어드는지, 저장한 체크포인트에서 같은 조건으로 재개할 수 있는지를 함께 확인해야 한다.
아래 수치 예제는 원리를 설명하기 위한 가정이며, 해당 모델의 학습이나 하드웨어 성능을 직접 실험한 결과는 아니다.
복원한 상태보다 다음 업데이트의 오차를 본다
AdamW는 기울기의 1차·2차 모멘트를 보관하고, 2차 모멘트의 역제곱근으로 업데이트 크기를 조절한다. Rounding in Preconditioner Space 논문 (새 창)은 상태 값의 복원 오차를 줄이는 반올림과 실제 업데이트에 작용하는 오차를 줄이는 반올림을 구분한다. 역제곱근의 비선형성 때문에 두 목표는 일치하지 않는다.
ZIP-SR은 복원할 값을 모아 둔 코드북에 0을 포함하고, 업데이트 크기를 조절하는 프리컨디셔너 공간에서 확률적 반올림을 수행한다. 반면 ZE-EDEN은 2차 모멘트 코드북에서 0을 제외하고, 블록별 보정을 통해 양의 최솟값이 만드는 왜곡을 줄인다.
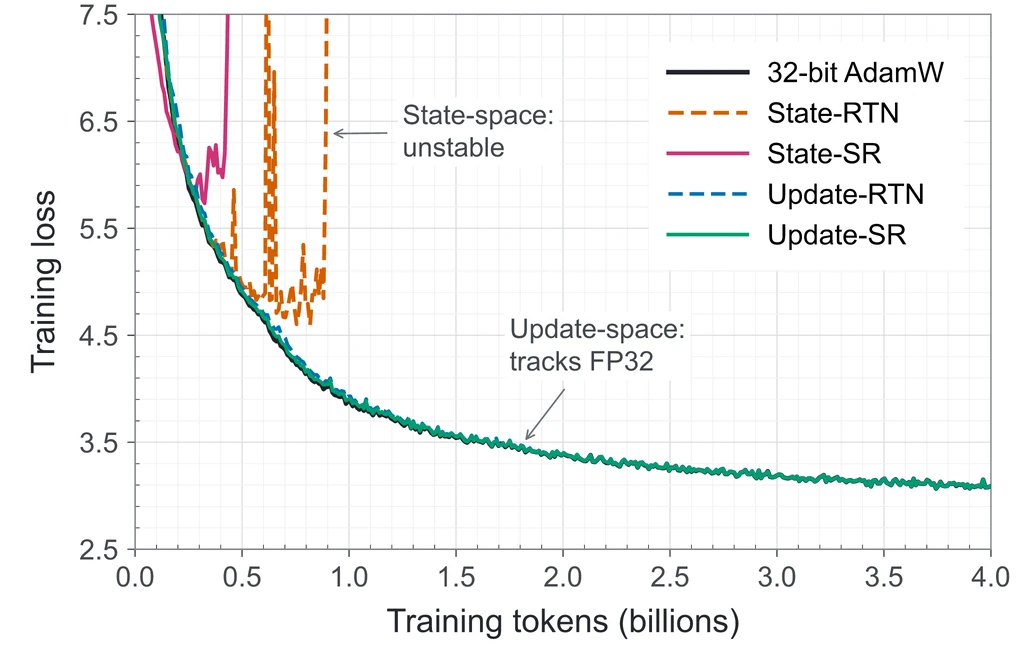
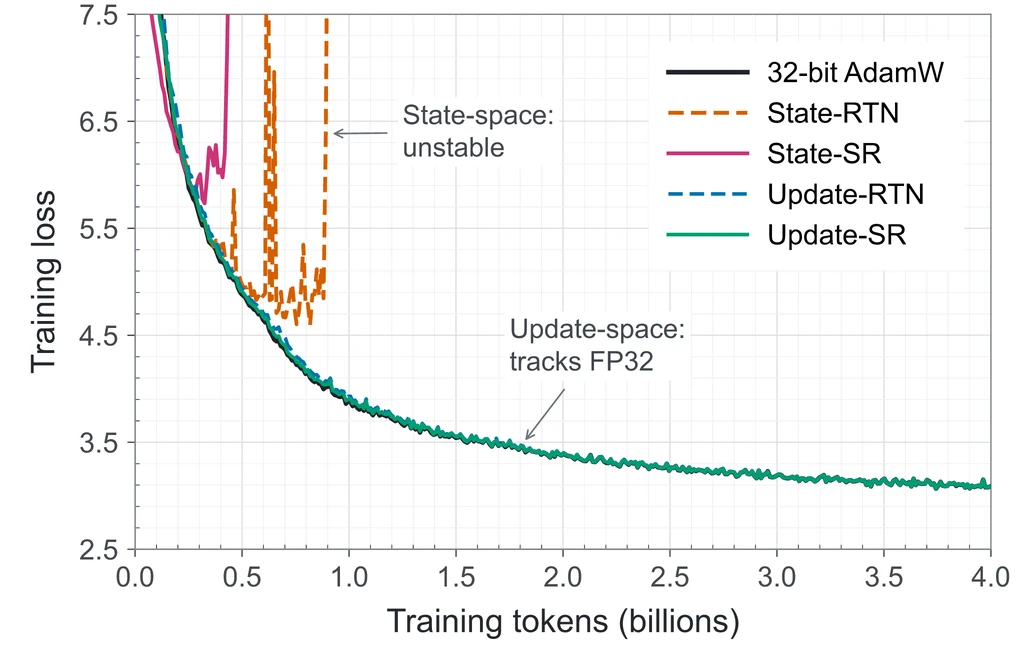
아래 원문 Figure 1 (새 창)은 GPT 834M의 첫 4B 토큰 학습 손실을 보여준다. 1차 모멘트는 FP32로 고정하고, 동일한 Dyn4 2차 모멘트 코드북에서 반올림 공간을 비교했다. 상태 공간에서 반올림하면 손실이 불안정하지만, 업데이트 공간에서 반올림하면 FP32 기준선을 따른다.
가상으로 2차 모멘트 v=0.25를 코드북의 0.1과 0.4 사이에서 반올림한다고 해보자. 상태 공간에서 두 값을 절반씩 선택하면 평균 v는 0.25로 맞춰진다. 하지만 ε을 생략한 프리컨디셔너 1/√v는 원래 2인 반면, 반올림 후 평균은 (1/√0.1+1/√0.4)/2=약 2.372가 된다. 상태의 평균 오차가 0이어도 업데이트에 곱해지는 계수는 약 18.6% 커질 수 있다.
이처럼 양의 두 값만 쓰는 단순 예제에서 계수의 평균을 2로 맞추려면, 낮은 값인 0.1을 선택할 확률은 약 0.265가 된다. 이때 상태 평균 자체는 약 0.321이 되어 원래 값인 0.25와 달라진다. 무엇을 평균적으로 맞출 것인지 목표가 바뀐 셈이다. 실제 ZIP-SR의 0 인접 셀과 ε 처리는 이 단순 예제에 포함하지 않았다.
70.1%는 전체 손실의 감소율이 아니다
Table 4 (새 창)의 GPT 1.4B·세 쌍의 시드 실험에서 FP32 검증 손실은 2.5186이며, 기준선과의 차이는 TorchAO 0.0521, ZE-EDEN 0.0184, ZIP-SR 0.0156이다. 여기서 70.1%는 TorchAO에서 발생한 손실 차이를 ZIP-SR이 얼마나 줄였는지를 나타내는 비율이지, 전체 검증 손실이나 학습 시간을 그만큼 줄였다는 뜻이 아니다.
공식 코드의 평가 설명 (새 창)에 따르면 기준 방식과 제안 방식의 마지막 검증 시점이 서로 다르다. 이 차이는 GPT 1.4B를 비롯해 여섯 가지 작은 모델 설정에 모두 해당한다. 따라서 도입 여부를 판단하려면 같은 학습 예산과 평가 시점을 기준으로 다시 비교해야 한다.
손실 차이 감소도 계산의 분모를 확인할 수 있다. (0.0521−0.0156)/0.0521=약 70.1%다. FP32 기준선에 각 차이를 더한 손실은 2.5707과 2.5342로, 전체 손실 기준의 상대 차이는 약 1.42%다. 같은 숫자라도 무엇을 분모로 삼는지에 따라 의미가 달라진다.
7.53배 압축의 범위는 두 모멘트 상태다
논문의 저장량 계산 (새 창)에 따르면 적용 대상 파라미터당 모멘트 저장량은 약 1.0625바이트다. 두 모멘트를 FP32로 저장할 때의 8바이트와 비교하면 약 7.53배 압축된다. 이는 블록별 스케일을 포함한 지속 상태를 기준으로 계산한 값이며, 작은 텐서 등은 그대로 FP32를 유지한다.
실제 학습에서는 모델 가중치, 기울기, 활성값과 임시 연산 공간도 메모리를 차지하므로 먼저 기존 실행의 메모리 구성을 확인해야 한다. 모멘트 상태의 비중이 큰 작업이라면 도입을 비교해 볼 이유가 충분하지만, 긴 시퀀스의 활성값이 최대 메모리를 좌우하는 작업이라면 상태만 줄여도 배치 크기는 그대로일 수 있다. 압축률의 분모를 전체 메모리로 바꾸어 계산해서는 안 된다.
가상으로 전체 최대 메모리 24GB 중 모멘트 상태가 8GB이고 나머지가 16GB라고 해보자. 상태를 1.0625GB로 줄여도 전체 메모리는 17.0625GB가 된다. 상태 자체는 약 7.53배 압축되지만 전체 메모리 절감률은 약 28.9%다. 만약 임시 공간이 따로 4GB 늘어난다면 최대치는 21.0625GB가 되어 절감 폭이 더 작아진다. 이는 모든 메모리가 같은 시점에 겹친다는 가정하에 계산한 것이며, 실제 피크 메모리는 실행 구간별로 확인해야 한다.
반올림 방식만 바꿔서는 재현 조건이 갖춰지지 않는다
구현 안내 (새 창)에서는 기본 예제만으로는 논문의 전체 설정이 재현되지 않는다고 밝히고 있다. 학습의 마지막 10% 구간에서 적용하는 LM head 1차 모멘트의 확률적 반올림은 학습 루프에서 별도로 설정해야 한다. 또한 파라미터별 1차 모멘트 설정은 체크포인트에 저장되지 않으므로 학습을 재개할 때 다시 적용해야 한다.
이 조건을 놓치면 같은 이름의 옵티마이저로 실행하더라도 논문과는 다른 실험이 된다. 학습 재개를 점검할 때는 중단 전후의 설정뿐만 아니라 해당 설정이 실제로 어느 파라미터에 적용됐는지도 함께 기록해야 한다. 설정이 다른 상태에서 논문 수치와 비슷한 결과를 얻더라도, 손실만 단순 비교해서는 그 원인을 설명하기 어렵다.
메모리 최적화 옵션 (새 창)인 optimized=True는 아직 실험적인 기능이며 속도가 더 느려질 수 있어, 적용되는 연산 조건을 따로 확인해야 한다. 일부 조건에서는 텐서 전체 크기의 임시 공간을 쓰는 방식으로 돌아간다.
도입 여부는 동일한 작업의 손실·메모리·시간으로 정한다
실무 검증은 기존 FP32 실행과 데이터 순서, 학습 예산, 평가 시점을 똑같이 맞추는 데서 시작한다. 그다음 최종 검증 손실과 손실이 불안정한 구간, 전체 실행의 최대 메모리, 반복 스텝 시간을 함께 비교한다. 이때 컴파일이 처음 발생하는 구간과 이후 구간을 나누어 기록해야 초기 비용이 지속 비용처럼 보이는 문제를 피할 수 있다.
상태를 압축한 뒤에도 최대 메모리가 그대로라면 임시 공간이나 활성값이 병목인지 확인해야 한다. 메모리는 줄었지만 스텝 시간이 느려졌다면, 확보한 여유 메모리로 배치 크기를 키웠을 때 총 학습 시간이 실제로 줄어드는지 다시 확인한다. 압축률만 보고 이 두 가지 경우의 도입 여부를 똑같이 결정할 수는 없다.
검증 손실을 유지하면서 전체 최대 메모리나 총 실행 비용이 개선되고, 학습 중단 후에도 같은 설정으로 재개된다면 도입을 검토할 만하다. 이 조건이 확인되지 않은 작업에서는 기존 FP32 기준 실행을 유지한다.