악성 탐지율 95.6%인데 왜 배포하기 어려울까: Skill 오탐과 기저율
출처 분리 평가의 탐지율과 오탐률을 실제 검토량으로 바꿔 계산한다. 악성 비율이 낮아지면 높은 탐지율만으로 차단 목록을 신뢰할 수 없는 이유를 설명한다.
Random은 항목을 무작위로 나누고, Source-Disjoint는 출처 전체를 통째로 분리하는 평가다. 같은 출처의 문체와 구조가 학습·평가 데이터에 섞였는지 확인하고, 악성 탐지율(recall)과 정상 Skill 오탐률(FPR)을 함께 봐야 한다.
새 출처에서도 유지되는 성능인가
탐지기가 악성 행위를 배운 것일까, 아니면 특정 수집처의 문체와 구조를 외운 것일까? 논문 결과만 보면 Random 평가는 이 둘을 충분히 가려내지 못한다. 출처를 통째로 분리하자 성능이 크게 떨어졌고, 악성을 많이 잡는 대신 정상 Skill까지 대량으로 차단하는 운영상의 위험도 드러났다.
실행하지 않고 텍스트를 검사한 벤치마크
2026년 8월 20일 공개된 논문 MaliciousSkillBench: A Comprehensive Benchmark for Malicious Agent Skill Detection v1은 13개 공개 출처를 수집한 뒤, 실제 Skill 산출물과 출처의 악성 주장, 뒷받침 근거를 보존할 수 있는 11개 출처만 Core 악성 데이터에 포함했다.
이 벤치마크는 Skill의 지시문과 메타데이터를 정적으로 검사한다. 코드·보조 프로그램·payload·URL·설치 프로그램·내장 지시문을 직접 실행하지 않으므로, 실제 실행 중 드러나는 행위를 탐지하는 평가와는 다르다.
구조적 중복과 출처를 각각 분리하기
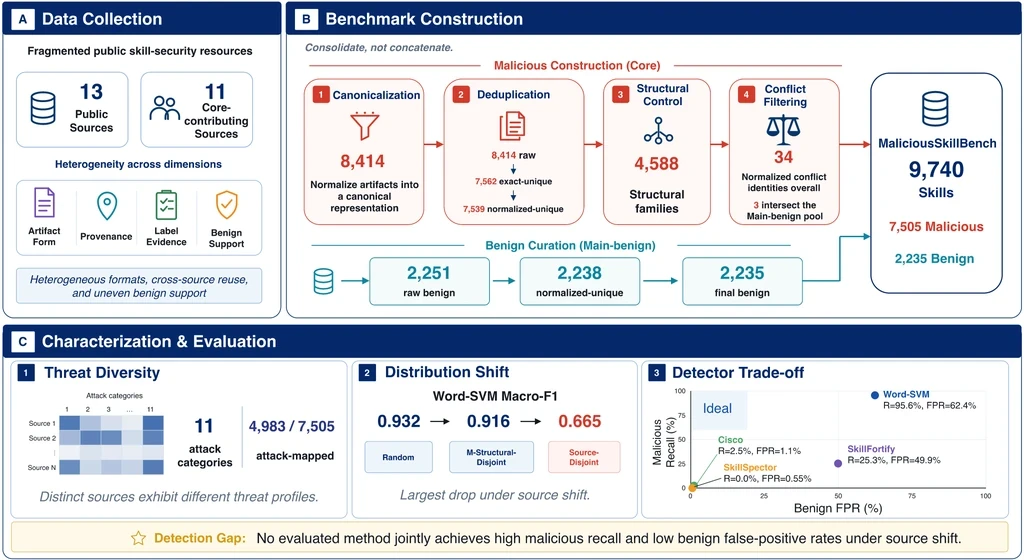
출발점은 단순 수집이 아니라 중복과 구조적 재사용을 가려내는 일이다. 연구진은 8,414개 원시 악성 레코드를 정규화해 7,539개 고유 항목으로 줄인 뒤, 4,588개 구조적 family로 묶었다. 보수적으로 label conflict를 제외한 주 벤치마크는 총 9,740개 Skill로, 악성 7,505개와 정상 2,235개로 구성된다. 이 중 출처가 제공한 근거로 공격 유형을 매핑할 수 있는 악성 항목 4,983개는 11개 category로 정리했다.
그다음 평가 분할 방식을 달리했다. Random은 항목을 무작위로 나누고, structural-disjoint는 구조적으로 가까운 악성 family가 학습과 평가에 함께 들어가지 않도록 분리한다. Source-Disjoint는 특정 출처 전체를 평가셋에만 남긴다. 이 마지막 조건은 운영 중 처음 마주하는 공급 채널이나 수집 관행의 변화에 더 가깝다. 다만 출처마다 공격 구성과 정상 데이터의 성격도 함께 달라진다는 점은 감안해야 한다.
악성 탐지율과 정상 오탐률의 대가
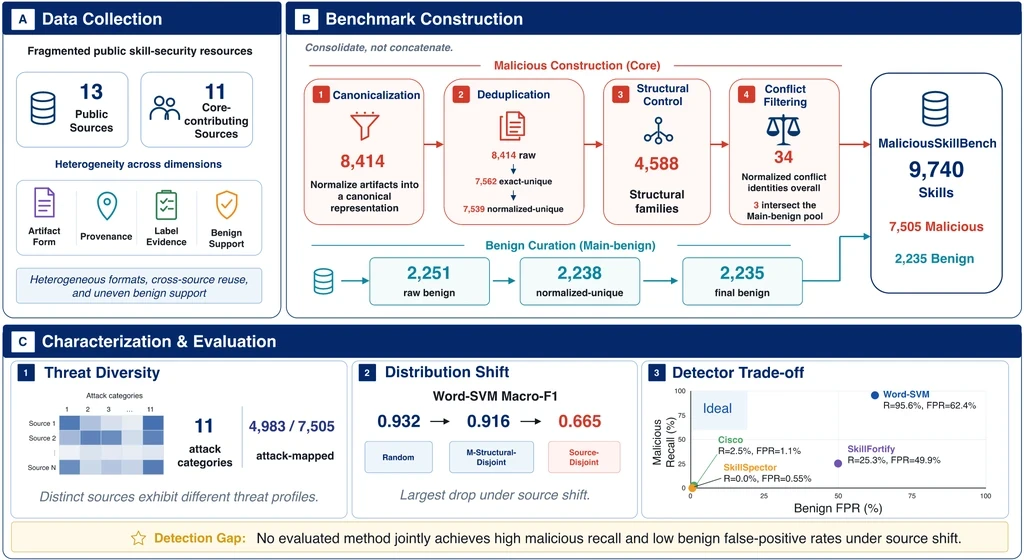
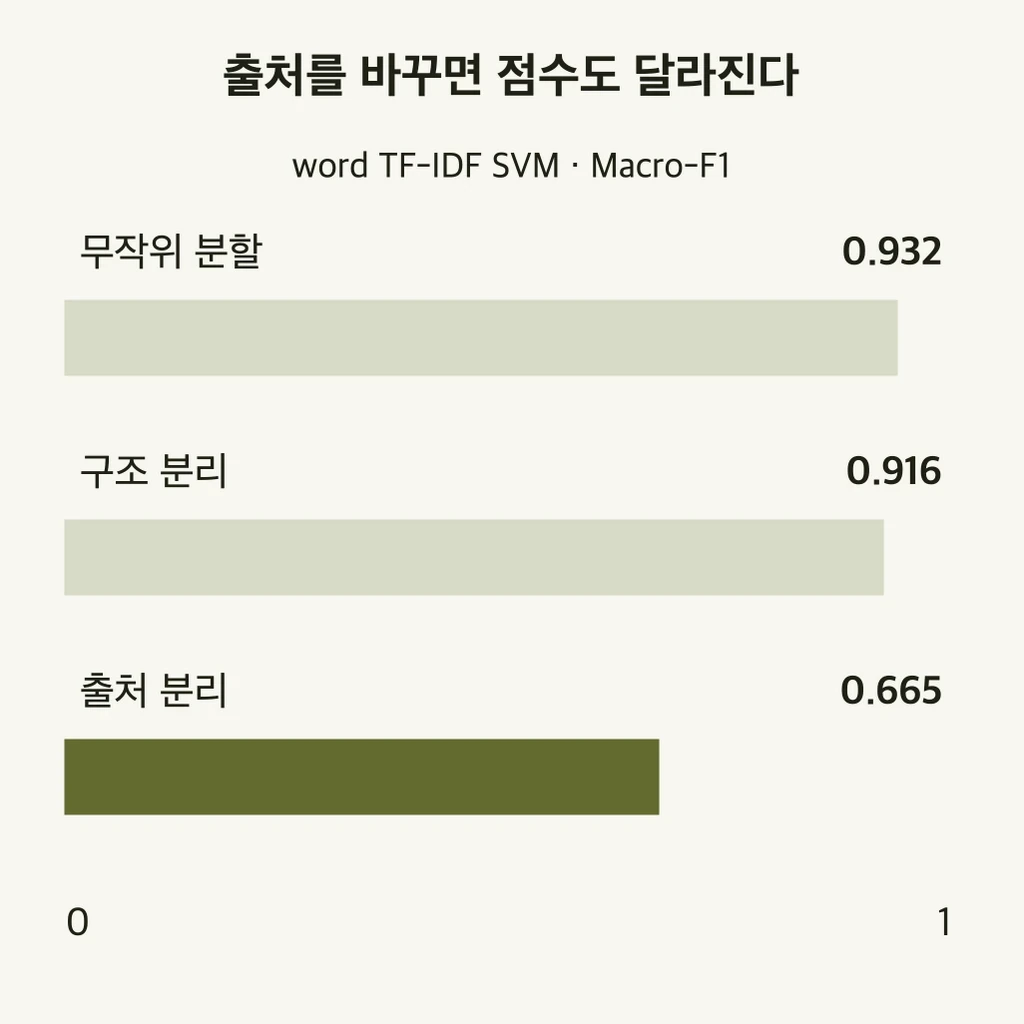
세 종류의 learned text detector는 Random에서 Macro-F1 0.882~0.932를 기록했지만, Source-Disjoint에서는 0.653~0.665에 머물렀다. 가장 성능이 높은 word TF-IDF SVM의 점수는 Random, structural-disjoint, Source-Disjoint 순서로 각각 0.932, 0.916, 0.665였다. 구조적 중복만 막았을 때보다 출처까지 분리했을 때 성능 하락 폭이 훨씬 컸다.
같은 모델은 평가용으로 분리해 둔 출처의 악성 Skill을 95.6% 잡아냈지만, 정상 Skill의 62.4%도 악성으로 잘못 분류했다. 악성 탐지율만 보면 정상 도구의 절반 이상을 차단하는 비용을 놓치게 된다. 반면 기성 scanner 세 개는 오탐률을 낮추는 대신 악성 탐지율이 크게 떨어졌다.
이 결과가 탐지기가 출처 이름만 외웠다는 직접적인 증거는 아니다. 무작위 분할에서는 같은 출처 특유의 문체·템플릿·메타데이터 관행과 유사한 변형이 학습과 평가에 함께 들어갈 수 있다. 출처 분리는 이러한 규칙성에 대한 의존도를 시험하지만, 출처별 공격 구성의 차이도 함께 반영한다.
실제 운영 부담은 기저율에 따라 달라진다. 설명을 위해 새 Skill 1,000개 중 악성이 10개, 정상이 990개라고 가정하고, 논문의 탐지율 95.6%와 오탐률 62.4%가 그대로 유지된다고 해보자. 기대 탐지 수는 9.56개, 정상 오탐 수는 617.76개다. 차단 후보 약 627.32개 가운데 실제 악성 비율은 약 1.52%에 불과하다. 여기서 소수점은 반복 표본의 기대값이며, 실제 한 번의 검사에서 발생하는 건수는 정수다.
이 계산은 논문의 평가셋 구성이나 실제 서비스 예측치가 아니다. 새로운 데이터 분포에서도 두 비율이 그대로 유지된다는 강한 가정 아래, 탐지율이 아무리 높아도 검토 인력 대부분이 정상 항목을 확인하는 데 소모될 수 있음을 보여주는 예시다. 악성 비율이 달라지거나 공급 채널이 바뀌면 수식의 입력값부터 다시 측정해야 한다.
차단 결과를 사람이 검토한다면 검토 시간과 정상 도구의 대기 시간을 함께 기록한다. 임계값을 높여 오탐을 줄일 때는 놓치는 악성이 얼마나 늘어나는지 동일한 출처 분리 데이터에서 확인한다. 단일 Macro-F1 점수를 높이는 것과 조직이 감당할 수 있는 검토량 안에서 위험을 줄이는 것은 같은 최적화 문제가 아니다.
분할 단위와 오탐 비용을 먼저 정하기
조직에서 Skill scanner를 평가할 때는 데이터 분할 단위를 개별 파일보다 크게 잡아야 한다. 공급 채널, 저장소, 작성 조직과 structural family까지 분리한다. Random 결과는 회귀 확인용 기준선으로 삼되, 최소한 family-disjoint와 source-disjoint 결과를 함께 기록한다. Macro-F1 외에도 malicious recall, benign FPR, technical abstention을 나란히 확인해야 한다.
외부 Skill은 정적 검사를 첫 단계로 두고 최소 권한, 네트워크·파일시스템 격리, 실행 전 검토, 실행 중 감사를 함께 적용한다. 출처를 제한한 사내 Skill을 사람이 직접 승인하는 환경이라면, 학습형 탐지기보다 서명과 정책 검사가 더 투명하다.
정상적인 개발을 멈추게 하는 오탐 비용과 자격증명·코드·데이터를 위험에 노출하는 미탐 피해를 구분해 임계값을 정한다. 학습에 없던 출처를 평가셋에 추가하고 새로운 공급 채널이 들어올 때마다 재평가해야 0.932라는 점수의 유효 범위를 확인할 수 있다.
정적 데이터와 출처 분리의 한계
MaliciousSkillBench는 여러 출처를 정규화한 대규모 정적 벤치마크지만 완전한 위협 지도는 아니다. source-native label의 품질과 공개 가능한 artifact의 범위에 영향을 받으며, 실제 실행 환경에서만 드러나는 조건부 payload나 service interaction도 평가하지 않는다. Source-Disjoint 역시 출처, 공격 구성, 작성 style의 변화를 한꺼번에 묶어 다루므로 성능 하락의 원인을 하나로 단정할 수 없다.
도입 비교표에는 Random과 출처 분리 결과를 나란히 두고 악성 탐지율·정상 오탐률·판단을 유보한 비율을 함께 기록하는 편이 좋다. 평균 점수보다는 새로운 공급 채널에서 감당할 수 있는 차단·누락 비용이 실제 운영 기준이 된다.
참고 자료
MaliciousSkillBench: A Comprehensive Benchmark for Malicious Agent Skill Detection (새 창)
· arXiv v1, 2026-08-20