LLM은 연구 아이디어의 새로움을 아는가: 점수와 판정 불일치 읽기
LLM의 새로움 평가에서 질문의 전제가 무엇을 바꾸는지 살펴본다. 10쌍의 예제로 평균 선택 비율과 판정 불일치를 구분하고, 약한 라벨·제시 순서·반복 평가를 해석하는 방법을 설명한다.
연구 아이디어를 고르는 LLM이 질문 한 문장에 따라 다른 후보를 택한다면 무엇을 측정한 셈일까? 아이디어의 새로움 자체일 수도 있고, 심사자가 기대했을 법한 답을 추정하는 능력일 수도 있다. 모델 이름과 점수가 같아 보여도 평가 질문이 바뀌면 판단 대상 자체가 달라진다.
Ai2의 새로움 평가 실험을 바탕으로 질문의 전제, 정답 라벨, 판정 일치율을 분리해 살펴보자. 특히 평균 점수가 같더라도 탈락하는 후보는 크게 달라질 수 있다. 아래의 간단한 집계는 이 차이를 설명하기 위한 가상 계산이며, 이 글에서 모델 평가를 직접 실행한 결과는 아니다.
심사 결과를 맞히는 질문과 새로움을 묻는 질문
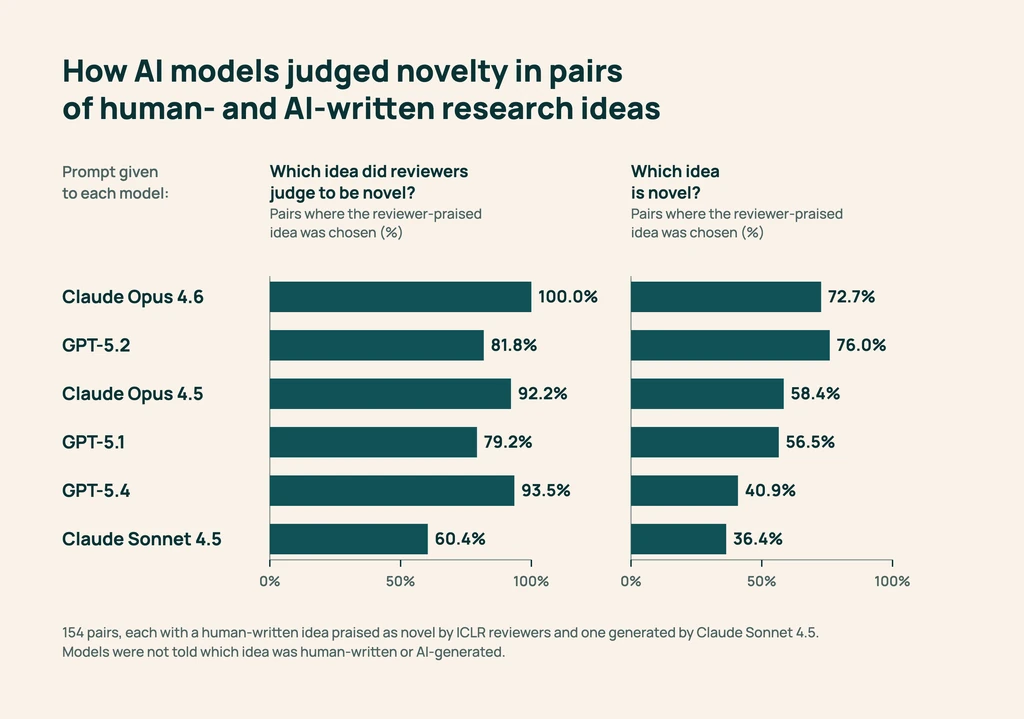
Ai2 공식 해설 (새 창)은 동일한 두 아이디어를 서로 다른 전제에서 비교했다. 한 질문은 심사자가 둘 중 정확히 하나를 새롭다고 판단했다는 정보를 주고 그 아이디어를 찾게 한다. 다른 질문은 그런 정보 없이 어느 아이디어가 새로운지만 묻는다. 작성자가 사람인지 AI인지는 모델에 알려 주지 않았다.
Human+Generated의 154쌍에서 GPT-5.4가 사람의 아이디어를 고른 비율은 두 설정에서 각각 93.5%와 40.9%로, 52.6%포인트 차이가 났다. 아래 그래프는 여섯 모델에 대해 같은 비교를 수행한 결과를 보여 준다. 이 숫자는 특정 쌍과 라벨에서의 선택 비율일 뿐, 모든 연구 아이디어에 대한 객관적인 정답률은 아니다.
첫 번째 질문은 이미 내려진 심사 판단을 추정할 단서를 준다. 두 번째 질문은 그런 단서 없이 직접 판정을 내리도록 요구한다. 따라서 이를 단순히 길거나 친절한 프롬프트가 더 좋다는 결론으로 요약할 수는 없다. 아직 심사받지 않은 후보에 “하나는 심사자가 새롭다고 했다”는 전제를 넣는 것은 실제 사용 환경에는 없는 정보를 만들어 주는 셈이다.
선택 비율의 차이는 뒤집힌 비율과 같지 않다
두 설정에서 사람 아이디어를 선택한 비율 차이가 52.6%포인트라면, 같은 쌍을 비교했다는 조건 아래 판정이 달라진 비율은 적어도 그 이상이다. 한 방향의 변화만 남는 비율 차이와 양방향 변화를 모두 세는 불일치율은 다르기 때문이다. 반대 방향으로 바뀐 사례가 있다면 전체 불일치율은 더 커질 수 있다.
10쌍으로 구성된 가상 예제를 보자. 설정 A는 1~8번에서 사람 아이디어를, 설정 B는 1~5번과 9번에서 사람 아이디어를 고른다. 선택 비율은 각각 80%와 60%로 20%포인트 차이다. 하지만 6·7·8번은 사람에서 생성 아이디어로, 9번은 그 반대로 바뀌었으므로 실제 판정 불일치는 4/10, 즉 40%다.
평균 점수가 같아도 안심할 수 없다. 설정 B가 1~6번과 9·10번에서 사람 아이디어를 고르면 두 설정 모두 선택 비율은 80%지만, 7·8·9·10번의 판정은 서로 다르다. 최종 후보 목록은 달라졌는데 집계 점수만 보면 그 변화가 가려진다. 실제 운영에서 후보를 자동으로 탈락시킨다면 쌍별 기록을 남겨야 하는 이유다.
라벨의 신뢰도와 판단의 안정성을 따로 읽는다
공개 저장소 (새 창)는 Human-Only와 Human+Generated의 라벨 출처를 구분한다. 사람의 아이디어 중 높은 새로움 집합은 채택 여부뿐 아니라 해당 분야 상위 10% 평가, 심사자의 명시적 새로움 인정 등을 기준으로 추린 154개다. 낮은 새로움 집합은 반대 조건에 해당하는 145개다. 즉, 전체 연구 아이디어에서 추출한 무작위 표본이 아니다.
Human+Generated에서는 앞서 추린 154개를 단순 생성 모델이 낸 아이디어와 비교한다. 이때 생성 모델에는 문헌 검색이나 도구, 반복 개선 기회를 주지 않았다. 생성 아이디어가 덜 새롭다는 라벨은 약한 라벨이며, 모든 항목에 대해 전문가가 확정한 판정도 아니다. 전문가가 추가로 검토한 30쌍 역시 평가자가 틀린 사례에 치우쳐 있어 전체 비율을 대표하지 않는다.
가상으로 모든 라벨을 뒤집어 보면 같은 모델 출력이라도 정답률은 달라진다. 하지만 두 설정에서 같은 후보를 골랐는지를 나타내는 일치 여부는 그대로 유지된다. 따라서 정답률이 의심스럽다고 해서 불일치 관찰 결과까지 버릴 필요는 없다. 반대로 두 설정이 항상 같은 답을 낸다고 해서 그 답이 옳다는 보장도 없다. 안정성과 타당성은 별개로 확인해야 할 성질이다.
후보를 버리기 전에 어떤 조건에서 바뀌었는지 기록한다
팀의 다음 연구 후보를 추리는 가상 절차를 생각해 보자. 먼저 새로움의 기준과 비교 대상이 될 선행연구를 고정한다. 이어서 같은 아이디어 쌍을 A·B 순서와 B·A 순서로 제시하되, 결과는 화면상의 첫째·둘째 위치가 아니라 원래의 후보 ID로 변환해 저장한다. 제시 순서를 바꾼 뒤 “첫째”라는 응답만 단순 비교하면 실제 선택을 잘못 읽을 수 있다.
같은 프롬프트의 반복 실행과 프롬프트 변경도 구분한다. 전자는 동일 조건 내에서의 변동을, 후자는 문구나 전제가 바뀌었을 때의 변동을 확인하기 위함이다. 두 요소를 한꺼번에 바꾸면 무엇 때문에 판정이 달라졌는지 해석하기 어렵다. 후보 ID, 제시 순서, 프롬프트 버전, 선택, 근거 문헌을 한 행에 기록해 두면 판정이 뒤집힌 사례를 다시 검토할 수 있다.
가상으로 100쌍을 두 가지 프롬프트와 두 가지 순서로 한 번씩 평가하면 호출 횟수는 400번이다. 각 조건을 세 번씩 반복하면 1,200번이 된다. 이는 예산 계산일 뿐 성능 개선을 보장하는 횟수가 아니다. 같은 편향을 공유하는 응답을 여러 번 모으면 다수결 결과도 같은 방향으로 틀릴 수 있다. 반복 횟수를 늘리기보다 어떤 실패를 구별해 낼 것인지 먼저 정한다.
문헌을 찾는 일과 새 기여를 입증하는 일 사이
문헌 검색을 연동했다면 검색 전후의 판정 변화뿐 아니라 실제로 찾아낸 근거까지 확인한다. 관련 문헌 자체를 찾지 못한 것인지, 문헌은 찾았지만 기존 기여와 새 제안의 차이를 잘못 비교한 것인지는 별개의 문제다. 검색 결과가 많다는 이유만으로 평가가 타당해지지는 않는다.
자동 선별 과정에서는 높은 점수를 곧바로 채택 신호로 삼기보다, 판정이 바뀐 후보와 근거가 부족한 후보를 추려 사람이 직접 검토할 목록으로 남길 수 있다. 이는 이 글의 운영 제안일 뿐 검증된 성능 수치가 아니다. 연구 분야나 생성 모델이 달라지면 평가할 후보의 분포도 달라지므로, 동일한 문구가 그대로 통할 것이라고 가정하지 않는다.
좋은 평가자는 같은 답을 일관되게 내는 데 그치지 않는다. 어떤 선행연구와 비교해 무엇이 새롭다고 판단했는지 설명할 수 있어야 한다. 평균 점수와 쌍별 불일치, 근거의 타당성을 함께 기록해야 자동 선별 과정에서 실제로 어떤 아이디어를 놓치고 있는지 파악할 수 있다.