결과물만 고치면 같은 실패가 반복된다: AutoDesign의 변경 채택 조건
현재 산출물 수정과 다음 실행의 작업 환경 수정을 구분한다. 학습·개발 점수가 엇갈리는 예제로 변경 채택과 독립 검증의 역할을 설명한다.
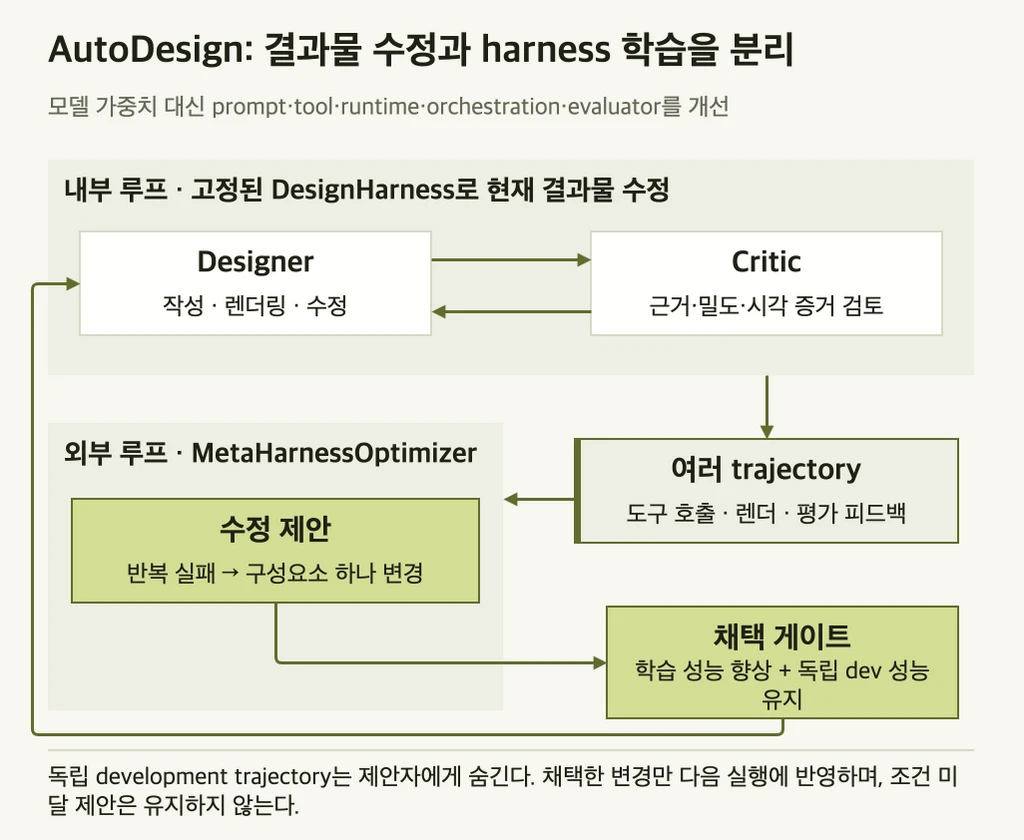
2026년 8월 13일 공개된 AutoDesign은 모델 가중치 대신 prompt·skill·도구·실행 환경·작업 조율·평가기를 개선한다. PosterBench Main Track에서 78.32점을 기록해 같은 Claude Code·Claude 4.8 구성의 Claude Design보다 7.45점 높았다.
결과물 수정과 다음 실행의 개선
prompt나 도구 명세, 작업 조율 단계에서 실패가 반복된다면 완성된 결과물만 고쳐서는 원인이 다음 실행에도 그대로 남는다. AutoDesign은 실행 기록을 모아 공통 작업 환경인 harness의 구성요소를 직접 수정한다.
다만 실험 중심은 논문을 학술 포스터로 바꾸는 과제로 한정되며, PosterBench와 최적화 방법을 같은 연구팀이 만들었다. 따라서 방법론의 구조와 보고된 성능은 구분해 살펴봐야 한다.
100편 포스터 평가와 다른 생성 경로의 차이
연구진은 5개 학문 분야의 논문 100편으로 PosterBench Main Track을 만들고, 통제 실험용 10편을 추려 PosterBench-mini를 구성했다. 최종 산출물은 원문 근거가 연결된 편집 가능한 HTML 포스터이며, 평가 항목은 faithfulness·coverage·density·visual evidence 등 일곱 축으로 나뉜다.
2026년 8월 14일 공개된 공식 저장소는 포스터뿐 아니라 slides·webpage·video 생성 경로도 제공한다. 그러나 논문의 정량 평가는 주로 paper-to-poster 과제에 집중되어 있어, 다른 산출물에서도 같은 폭으로 성능이 오른다고 일반화할 수는 없다.
결과 수정과 harness 개선은 다른 루프다
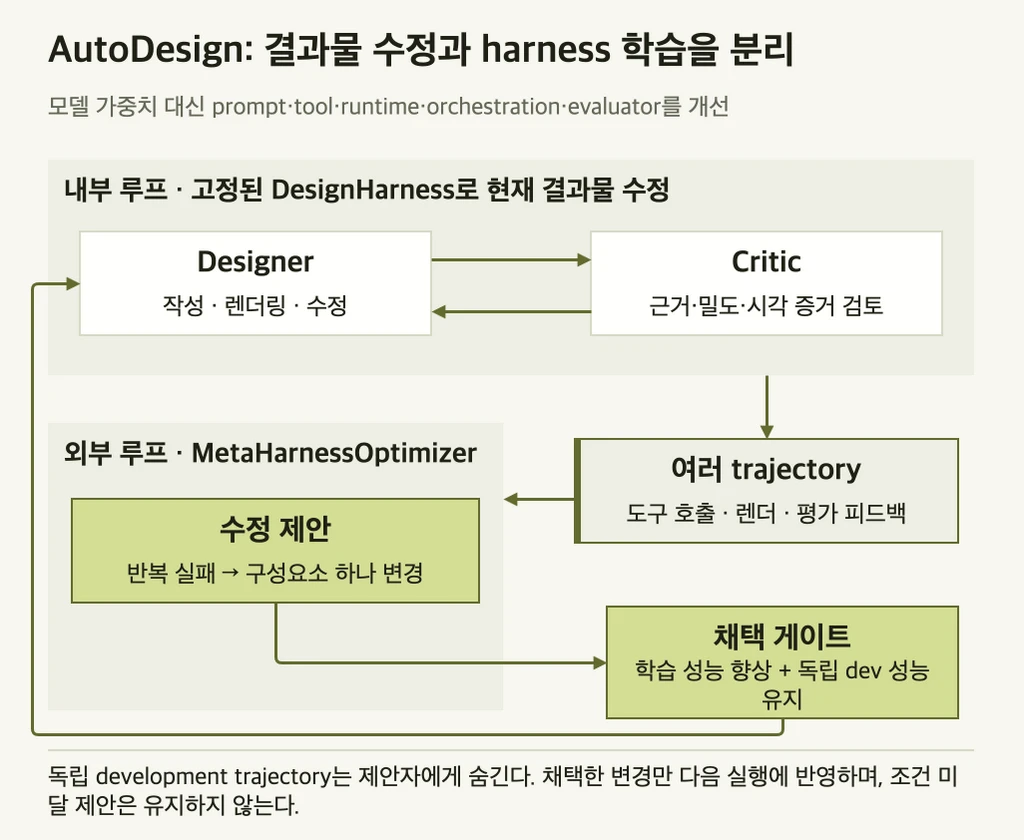
내부 루프의 Designer는 고정된 DesignHarness로 포스터를 만들고 Critic의 피드백을 받아 결과물을 수정한다. 이때 원자료·도구 호출·렌더링·평가 피드백은 실행 경로(trajectory)로 기록된다.
외부 루프의 MetaHarnessOptimizer는 여러 trajectory에서 반복되는 실패 패턴을 찾는다. 성능 변화의 원인을 명확히 추적하기 위해 Context and Memory, Tools and Specifications, Execution Runtime, Orchestration, Evaluation and Feedback 중 한 번에 한 구성요소만 수정하는 제안을 만든다.
수정한 제안은 학습 성능이 오르고 독립 개발셋의 성능이 떨어지지 않을 때만 채택한다. 관찰한 예제와 평가기 성향에만 맞춰 작업 환경이 과적합되지 않도록, 개발셋의 실행 기록은 변경 제안기에 숨긴다.
보고된 성능을 읽는 법
PosterBench Main Track(100편)에서 AutoDesign은 78.32점을 기록해 Claude Design보다 7.45점, OpenDesign보다 8.87점 높았다. Codex·GPT-5.5 구성은 10편짜리 PosterBench-mini에서 81.46점, Main Track에서 77.97점을 기록했으므로 서로 다른 평가 집합의 점수를 직접 비교해서는 안 된다.
PosterBench-mini에서 7개 code-agent-model 구성에 학습된 DesignHarness를 적용했을 때 평균 점수는 54.99에서 67.39로 12.40점 올랐다. 논문 초록에는 +12.4%로 표기되어 있지만, 두 점수의 단순 차이는 비율이 아닌 benchmark point 차이이므로 원점수와 차이 값을 함께 확인해야 한다.
완전 자율 실행 한 건은 253회의 tool call과 11회의 editing turn을 거쳐 40분 안에 끝났고 비용은 $3 미만이었다. 이 수치는 당시의 모델 가격·실행 환경·포스터 작업 특성에 종속되므로 일반적인 에이전트 운영비 기준으로 볼 수는 없다.
어떤 시스템에 적용할 수 있나
같은 형태의 작업이 반복되고 결과를 자동으로 검사할 수 있을 때 meta-harness가 유리하다. 문서 변환, 코드 migration, 정형 report 생성처럼 실패 패턴이 누적되는 workflow가 대표적이다. 반대로 작업이 매번 다르거나 평가가 주관적이고 드문 경우에는 외부 루프를 돌리는 비용이 더 클 수 있다.
실제 적용할 때는 모델 버전을 고정하고 harness 변경에 따른 차이만 비교한다. 실행 기록과 평가기 버전을 함께 저장하며 변경 단위는 작게 유지한다. 학습 성능 향상과 더불어 독립 개발셋에서 성능이 회귀하지 않는지 확인하고, 자동 평가 점수에만 편향되지 않도록 일부는 조건을 가린 사람 검토 결과와 대조한다.
가상으로 기존 harness의 학습 평균이 70점, 개발 평균이 75점이라고 해보자. 새 도구 명세를 적용한 후보 A가 78점·73점을 얻었다면 학습 점수는 개선됐지만 개발 점수가 회귀했으므로 논문의 채택 조건을 통과하지 못한다. 반면 후보 B가 74점·75점을 얻었다면 이 단순 예시의 두 조건을 모두 충족한다. 이는 실제 AutoDesign의 실험값이 아니라 변경 채택 논리를 설명하기 위한 가상 점수다.
다만 평균 점수가 유지되더라도 개별 과제의 실패가 가려질 수 있다. 개발 과제 두 개가 80점·70점에서 90점·60점으로 바뀌면 평균은 여전히 75점이다. 출처 누락이나 읽을 수 없는 도표가 허용되지 않는 업무라면 평균 점수 외에 해당 실패 여부를 별도 조건으로 둬야 한다. 이 추가 조건은 논문의 성능 결과가 아니라 실무 운영에 적용할 때 고려할 만한 제안이다.
같은 개발셋을 두고 반복해서 합격 여부를 묻는 과정 역시 선택 편향을 만들 수 있다. 제안기가 개발셋의 실행 기록을 보지 못하게 막는 것과 최종 성능을 독립적으로 추정하는 것은 별개의 문제다. 반복 최적화가 끝난 뒤에는 변경 판단에 한 번도 쓰지 않은 과제로 평가하고, 모델·평가기 버전과 난수 조건을 맞춰 비교한다. 그래야 도구 명세 수정으로 얻은 이득을 모델 교체나 평가 기준 변화로 인한 이득과 혼동하지 않는다.
포스터 평가에서 확인하지 못한 범위
PosterBench는 신규 벤치마크여서 외부 재현과 장기적인 상관관계 검증이 더 필요하다. 비교 대상인 Claude Design은 closed-source라 내부 설정을 완전히 맞추기 어렵고, 벤치마크 제작자와 방법론 제안자가 동일하다. human preference가 가장 높았다는 결과 역시 학술 포스터 제작 과제에 한정된다.
실무에 적용하려면 먼저 원자료·도구 호출·검사 결과를 하나의 실행 기록으로 묶어 남긴다. 그다음 자주 실패하는 구성요소 하나를 수정하고 독립된 과제로 검증해야 다음 실행의 출발점이 실제로 개선됐는지 확인할 수 있다.
참고 자료
AutoDesign: Meta-Harness Optimization for Long-Horizon Agentic Design
AutoDesign official repository