Responses API 사례를 그대로 따라 하면 놓치는 것: 수집·추론·검증의 경계
다섯 제품의 도구 연결과 실행 분리를 비교하고, 맥락 준비 단계에서 누락한 근거가 후속 추론으로 복구되지 않는 경우를 분석한다.
AI 에이전트의 장애를 감지하고 고친다 — Raindrop AI
사용 툴: 자체 구축 툴 / 모델: GPT-5.2
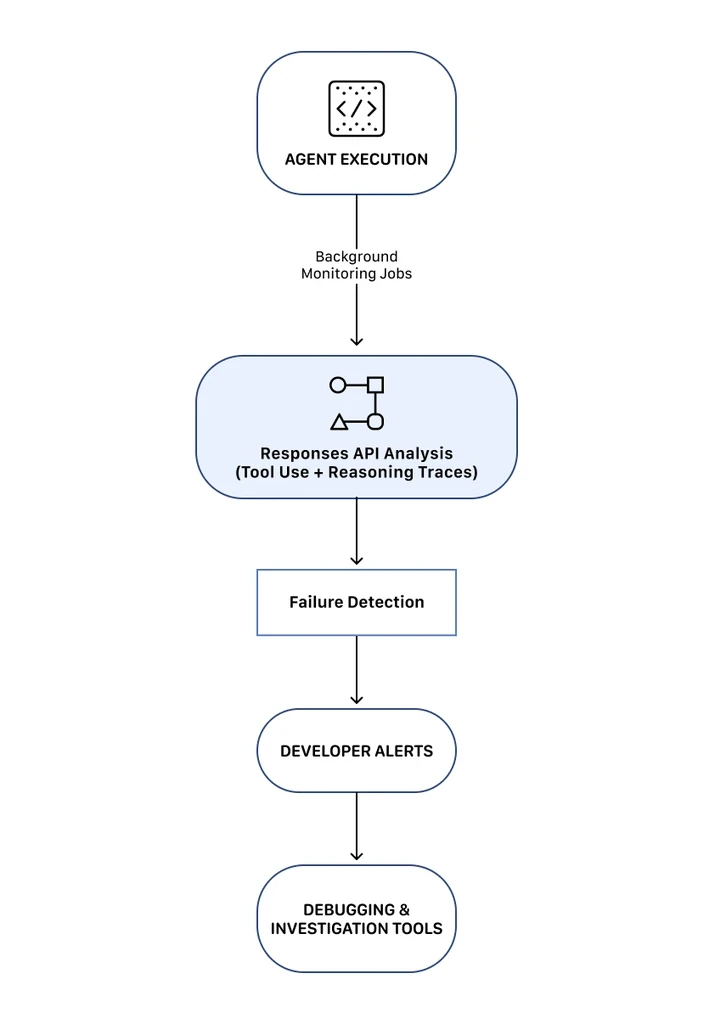
Raindrop AI (https://www.raindrop.ai/ (새 창))는 에이전트 실행 기록을 분석해 예상과 다른 행동을 조사하도록 돕는 모니터링 플랫폼이다. 아래의 모델명과 기능은 OpenAI 소개 사례를 기준으로 한다.
이 시스템은 Responses API로 백그라운드 분석 워크플로우를 실행한다. Vercel AI SDK로 여러 모델 제공자 간에 툴을 공유하며 실행 환경에 관계없이 이식성을 유지한다. 이상 동작이 발생하면 개발자에게 알리고 원인 진단을 돕는다.
플랫폼은 세 가지 기능을 제공한다.
에이전트 행동 모니터링: 에이전트가 예상대로 동작하는지 지속적으로 평가한다. 개발자가 원하지 않는 결과 조건을 설정해 두면 해당 조건이 충족될 때 알림을 받는다.
장애 감지 및 알림: 이상을 감지하면 조사에 필요한 컨텍스트와 함께 개발자에게 알린다. 에이전트 버전 간 행동 변화를 추적하고, 프롬프트나 시스템 변경이 유발한 실패를 파악하며, 추론 트레이스와 툴 호출 내역을 검토할 수 있다.
디버깅 툴: 장애 감지부터 시스템 개선까지 이어지는 도구를 제공한다.
복잡한 데이터를 위한 심층 추론 워크플로우 — Repo Prompt
사용 툴: Codex with App Server + MCP, 웹 검색 / 모델: GPT-5.3-Codex
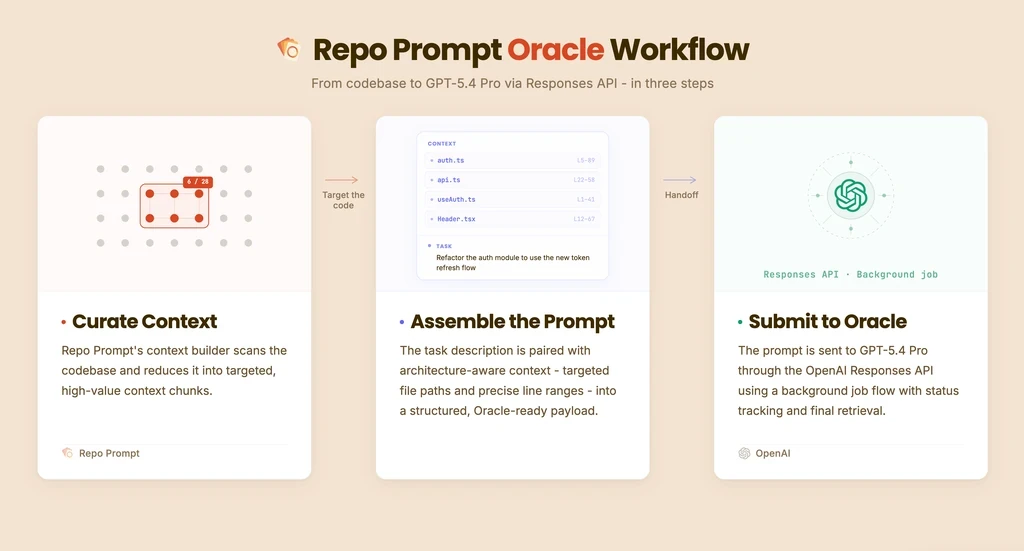
Repo Prompt (https://repoprompt.com/ (새 창))는 대규모 문서, 코드베이스, 데이터셋의 심층 분석을 돕는 시스템이다. Eric Provencher가 만든 이 플랫폼은 컨텍스트 수집과 심층 추론을 분리한다.
별도 에이전트가 필요한 맥락을 먼저 추려내면 추론 모델은 준비된 자료를 분석하는 데 집중할 수 있다. 앞 단계에서 필요한 근거를 빠뜨리지 않는지가 중요해지는 구조다.
시스템은 세 단계로 구성된다.
컨텍스트 빌더 에이전트: Responses API 툴과 모델 추론을 활용해 쿼리와 관련된 파일, 문서 간 관계, 핵심 섹션을 찾아낸다. 그 결과로 구조화된 컨텍스트 패키지를 만들어 다음 단계에 넘긴다.
“Oracle” 단계: 추론 모델이 추가 도구 호출이나 검색 없이 앞서 준비된 맥락 묶음을 분석한다. 이러한 분리는 제품 설계상의 선택이며, 모든 과제에서 성능이 좋아진다는 비교 결과는 아니다.
반복적 리서치 루프: 추론 모델의 결과가 나오면 다른 에이전트가 추가 조사가 필요한지 검토한다. 필요하면 컨텍스트 수집과 추론을 다시 수행한다. 이 루프 덕분에 시스템은 분석을 점진적으로 다듬는 장기 조사를 수행할 수 있다.
대규모 코드베이스 분석, 코드 리뷰, 의학·과학 문서 분석 등에 활용된다.
바이닐 레코드 컬렉터를 위한 대화 인터페이스 — Collxn
사용 툴: 웹 검색 + 커스텀 툴 16개 / 모델: GPT-5.4, GPT-5 nano
Collxn (https://www.collxn.com/ (새 창))은 바이닐 컬렉터들이 자신이 보유한 레코드를 재발견하도록 돕는 서비스로, Ash Ryan Arnwine이 만들었다. 컬렉터들은 Discogs에 수천 장의 레코드를 등록해 두고도 정작 그 음악을 잊고 지내는 경우가 많다.
Collxn은 이 컬렉션과 연동해 매일 다른 레코드를 소개하는 "Daily Drop" 이메일을 보낸다. 아티스트 관련 정보도 함께 담긴다.
여기에 Responses API로 동작하는 "Ask This Drop" 채팅 인터페이스를 더했다. 사용자가 소개된 레코드를 두고 궁금한 점을 질문할 수 있는 기능이다.
"이 레코드 지금 시세가 어떻게 돼?", "이 아티스트 다른 앨범 뭐가 있어?", "이 프레싱 얼마나 희귀해?" 같은 질문에 Discogs API 툴로 실시간 데이터를 가져와 답한다.
웹 검색 툴은 Daily Drop 이메일의 "최근 뉴스" 섹션에도 쓰인다. Agents SDK로 아티스트의 최근 소식을 찾아 이메일에 덧붙이는데, 베타 사용자 사이에서 가장 인기 있는 기능이 되었다.
Ash는 Responses API 덕분에 풀 RAG 시스템을 직접 구축하는 것보다 훨씬 단순하게 아키텍처를 잡을 수 있었다고 말한다.
화면 녹화를 인터랙티브 데모로 변환한다 — Arcade
사용 툴: Computer use / 모델: GPT-5.2, computer-use-preview
Arcade (https://www.arcade.software/ (새 창))는 화면 녹화 영상을 인터랙티브 제품 데모로 변환하는 플랫폼이다. Nick Sorrentino와 Pawel Wszola가 이끄는 팀이 만들었다.
데모 생성 흐름은 다음과 같다. 사용자가 화면을 녹화하면 데스크톱과 브라우저에서는 클릭, 입력, 스크롤 같은 구조화된 인터랙션을 직접 캡처한다. 반면 모바일은 iOS 샌드박싱 때문에 앱 전체의 인터랙션을 캡처할 수 없어 일반 화면 영상을 녹화한다. 이 영상을 Responses API의 computer-use 툴과 함께 전송하면 시각적 프레임을 분석해 어떤 인터랙션이 일어났는지 추론한다. 그 결과를 구조화된 단계로 변환한 뒤, Chat Completions API로 각 단계의 제목과 설명 텍스트를 생성한다.
Arcade 팀은 기능 통합 후 게시까지 필요한 액션의 중간값이 50% 감소했고, P80은 약 230개에서 약 120개로 줄었다고 보고했다.
AI 응답에서 브랜드 가시성을 측정하고 개선한다 — Hexagon
사용 툴: 웹 검색 / 모델: GPT-5.2 Chat
Hexagon (https://joinhexagon.com/ (새 창))은 AI 어시스턴트가 브랜드 제품을 어떻게 소개하는지 측정하는 플랫폼이다. Tunde Adeyinka와 Ramon Silva가 만들었다.
이 시스템은 Responses API를 다음 세 가지 목적에 맞게 구성한다.
응답 시뮬레이션 파이프라인: 매일 수천 건의 소비자 프롬프트와 상품 추천 질의를 생성해 Responses API로 실행한다. 돌아온 응답을 분석해 AI 생성 답변에서 브랜드 가시성을 추적한다.
멀티 에이전트 콘텐츠 생성: AI 응답 내 브랜드 가시성을 높이기 위해 최적화된 콘텐츠를 생성한다. 4개의 에이전트가 각각 전문화된 단계를 수행하고 다음 에이전트로 결과를 넘기는 구조다. 각 에이전트는 게시 전 결과를 반복해서 다듬는 루프를 거친다.
"Hexi" 챗봇: Responses API의 함수 호출로 구현한 챗봇이다. 고객이 대화 형식으로 분석 데이터를 탐색하고 AI 가시성 데이터 요약을 셀프서비스로 생성할 수 있다.
Hexagon은 웹 검색 툴로 ChatGPT 같은 브라우징 기반 응답을 재현하고, 사용자 위치 파라미터로 지역별 차이를 테스트하며, Reasoning Effort로 응답 깊이를 조절한다.
공통 API보다 제품별 실행 경계에 주목하기
지난 1년간의 사례에서 눈여겨볼 점은 하나의 만능 구성이 아니라 제품별 역할 분리다. Raindrop은 관측, Repo Prompt는 맥락 준비, Collxn은 기존 데이터 도구 연결을 중심에 둔다. 실제 도입 시에는 모델 호출이나 도구 기능과 별개로 데이터 저장, 실행 권한, 결과 검증, 운영 주체를 정해야 한다.
Repo Prompt 방식의 분리를 이해하기 위해 가상의 계약 검토 상황을 생각해 보자. 컨텍스트 수집기가 계약 본문만 넘기고 예외 조항이 담긴 부속서를 빠뜨리면, 추가 검색을 하지 않는 추론 단계에서는 그 누락을 스스로 복구할 수 없다. 추론 모델이 아무리 길게 생각해도 입력에 없는 문서를 확인한 것은 아니다. 이 예시는 해당 제품에서 실제로 관측된 장애가 아니라, 단계 분리 구조에서 검증해야 할 지점을 설명하기 위한 것이다.
따라서 수집 단계에서는 필요한 자료의 종류와 버전, 누락 여부를 기록하고, 추론 결과에는 실제 제공된 근거와 결론을 연결한다. 근거가 부족할 때 추가 수집 단계로 돌아갈지, 확인 불가로 끝낼지도 정해야 한다. 단계가 분리됐다는 설계 설명만으로 정확성이 높아졌다고 결론 내릴 수는 없다.
Arcade에서 게시까지 필요한 액션 수가 줄어든 사례도 같은 관점으로 읽는다. 행동 횟수는 작업 시간이나 오류율과는 다른 지표다. 액션 수가 줄어도 사람이 각 결과를 더 오래 검토한다면 총 소요 시간은 다르게 변할 수 있다. 자신의 워크플로에 적용할 때는 최종 결과가 합격한 작업을 분모로 두고 수정 횟수, 검토 시간, 전체 비용을 함께 측정해야 사례의 수치를 실무 판단으로 옮길 수 있다.
원문: From prompts to products: One year of Responses (https://developers.openai.com/blog/one-year-of-responses (새 창)) — Eva Sasson (OpenAI, 2026. 3. 11.)