KV 캐시가 디스크에 있는데 다시 계산하는 이유: vLLM 로드 비용의 손익
KV가 저장소에 남아 있어도 GPU 사용 준비에는 시간이 든다. 가상 요청으로 CPU 경유·메모리 해제 시점과 로드 비용을 따라가고, 요청별 로드 제한의 차이를 설명한다.
같은 문맥의 KV 캐시가 저장소에 남아 있으면 다시 계산하는 것보다 항상 빠를까? 저장된 바이트를 찾는 일과 GPU에서 바로 쓸 수 있게 만드는 일은 다르다. 캐시 적중 여부만으로는 첫 응답 시간을 설명하기 어렵다.
vLLM의 계층형 오프로딩 설명 (새 창)과 2026년 11월 9일 갱신된 사용 문서 (새 창)를 바탕으로, GPU에서 내려간 KV를 다시 읽는 경로와 요청별 로드 제한을 살펴본다. 아래 시간과 블록 수는 가상 추적이며 실제 서버를 실행해 얻은 벤치마크가 아니다.
저장소에서 찾은 블록도 CPU를 거쳐야 한다
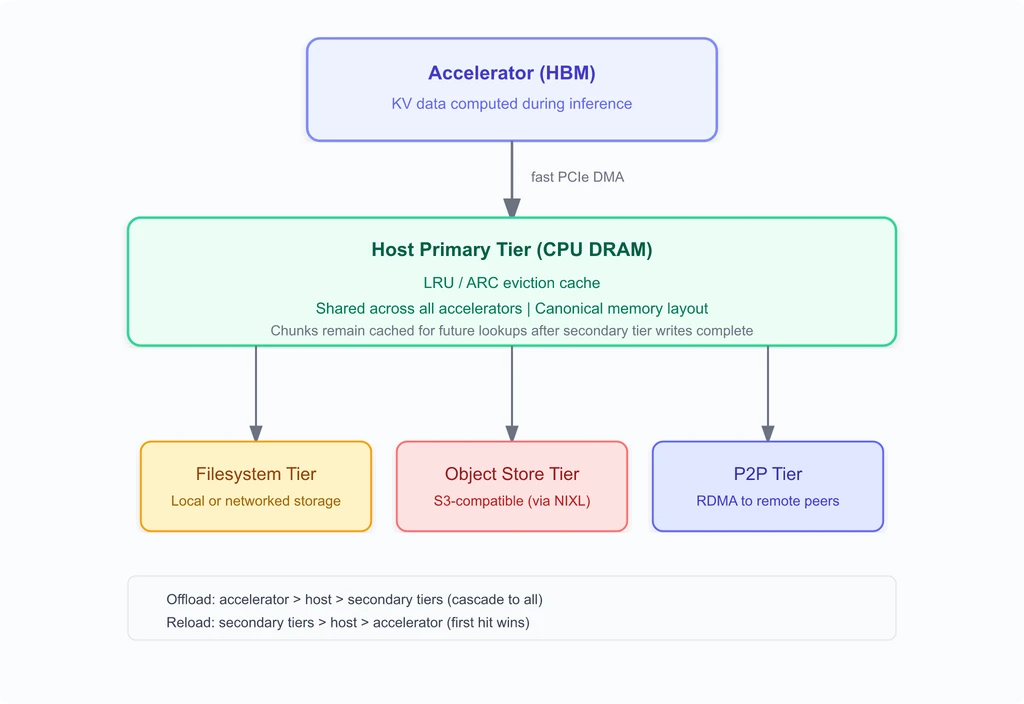
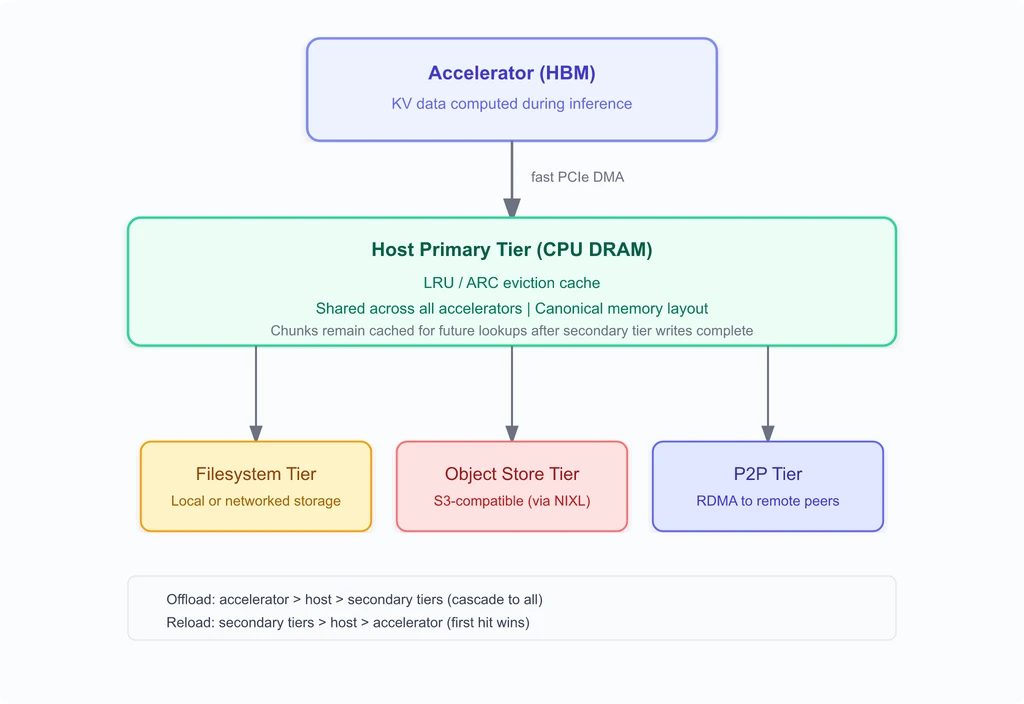
공식 구조 그림 (새 창) 한가운데에 있는 CPU DRAM은 단순한 통로가 아니라 캐시다. GPU에서 복사한 KV를 보관하고, 이를 파일시스템·객체 저장소·다른 노드로 내보내는 작업도 여기서 출발한다. 반대로 보조 계층의 데이터를 읽을 때도 일단 CPU에 올린 뒤 GPU로 옮긴다.
가상 요청 R에 필요한 블록 A·B·C 중 A만 GPU에 남아 있다고 하자. B가 CPU에 있다면 저장소를 다시 읽을 필요가 없다. 반면 C가 파일에만 있다면 파일 조회와 읽기, CPU 공간 확보, GPU 복사까지 거쳐야 한다. 이 세 블록을 모두 캐시 적중 한 건으로 묶어 버리면 C의 대기 비용이 가려진다.
사용 문서 (새 창)는 CPU 단일 계층과 보조 계층을 덧붙인 구성을 구분한다. 저장 공간을 늘린다고 해서 모든 적중이 GPU 적중과 같아지지는 않는다. 먼저 어느 계층에서 데이터를 찾았는지, 그리고 GPU에서 사용할 준비가 언제 끝났는지를 나눠 본다.
GPU 공간을 비우는 시점과 저장 완료는 다르다
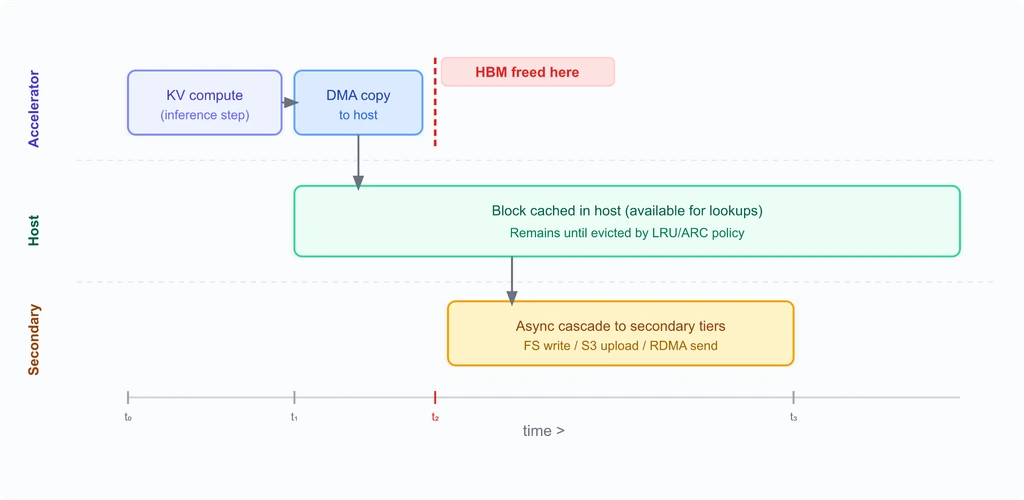
공식 시간축 그림 (새 창)에서 빨간 t2는 GPU에서 CPU로 복사가 끝나는 경계다. 보조 계층 쓰기는 그 뒤에도 이어진다. 이 그림은 상대적인 순서를 보여 주기 위한 것이므로 각 구간의 길이를 실제 밀리초로 읽어서는 안 된다.
C가 처음 계산됐던 때로 돌아가 보자. C를 CPU로 복사하는 데 4ms, 파일에 쓰는 데 추가로 30ms가 걸린다고 가정하자. 오프로딩 대상인 GPU 공간을 해제할 수 있는 시점은 CPU 복사가 끝난 4ms이지, 두 구간을 합친 34ms가 아니다. 물론 4ms 시점에 파일 복사본까지 준비됐다는 뜻도 아니다.
이 구조는 느린 쓰기 작업 때문에 GPU 공간을 계속 붙잡아 두는 일을 줄여 준다. 대신 그사이 복사본은 CPU가 맡아야 한다. 다른 요청이 같은 CPU 대역폭과 공간을 함께 쓰면 경합이 생길 수 있다. 또한 그림의 해제 경계를 현재 사용 중인 모든 KV 블록을 임의로 지워도 된다는 뜻으로 넓혀 해석해서는 안 된다.
20ms를 들여 80ms 계산을 피하는 경우와 그 반대
R에서 GPU에 없는 부분을 다시 계산하는 데 80ms가 걸린다고 가정하자. 로드는 조회·대기 5ms, 저장소에서 CPU로 12ms, CPU에서 GPU로 3ms가 직렬로 이어져 총 20ms가 걸린다. 나머지 요청 비용이 같다면 재계산보다 60ms를 아끼는 셈이다. 이는 전송이 서로 겹치지 않는다고 단순하게 가정한 계산이다.
같은 데이터라도 저장소가 혼잡해 조회·대기가 95ms로 늘어나면 총합은 110ms가 된다. 이번에는 재계산(80ms)보다 30ms 느리다. 캐시에 데이터가 있다는 사실은 같아도 손익 결론은 뒤집힌다. 따라서 바이트 적중률이 높다는 지표만 보고 로드를 늘릴 수는 없다.
블록 일부만 읽는 절충안도 있지만, 실제 손익은 로드한 접두어와 남은 계산이 어떻게 이어지는지에 달려 있다. 블록별 비용을 항상 독립적으로 단순 합산할 수 있는 것은 아니다. 실제로 비교할 때는 같은 요청 도착 기록과 문맥 길이를 사용하고, 첫 토큰 시간의 대기·전송·계산 구간을 함께 기록해야 한다.
로드를 끄는 것과 보조 계층만 빼는 것은 다르다
고정 버전 사용 문서 (새 창)의 max_load_tokens=0은 해당 요청에서 외부 KV 로드를 막는다. 이미 GPU에 있는 접두어 재사용은 그대로 유지된다. 앞선 R 예시라면 A는 계속 재사용하면서 외부에만 있는 B·C는 다시 계산하도록 두고 비교할 수 있다. 이 설정이 저장 동작까지 끄는 것은 아니며, 저장 범위는 max_offload_tokens로 따로 제어한다.
반면 kv_load_tiers에 빈 목록을 주면 보조 계층은 조회하지 않더라도 CPU 적중은 허용한다. R에서 B는 CPU에서 가져올 수 있지만 파일에만 있는 C는 이 경로로 읽지 않는다. 두 설정을 똑같은 “캐시 끄기” 실험으로 취급하면 비교 기준 자체가 달라진다.
양수인 max_load_tokens는 이미 GPU에 있는 토큰을 제외하고 외부에서 로드할 범위를 제한하며, 캐시 그룹이 지원하는 경계에 맞춰 내림된다. 문서는 이 설정을 실험 기능으로 안내한다. 설치된 버전에서 지원하는지, 실제 재계산 범위가 어떻게 잡히는지 확인한 뒤 비교해야 한다.
결국 외부 로드가 유리한지는 캐시 존재 여부만으로 결정되지 않는다. 필요한 KV가 어느 계층에 있는지, 준비될 때까지 얼마나 기다리는지, 그리고 차라리 다시 계산하면 얼마나 걸리는지에 따라 달라진다. 관련 기록의 prefix caching 글은 이보다 앞선 질문인 “같은 문맥으로 인정되는 블록은 무엇인가”를 다룬다.