종료 코드는 0인데 파일은 틀렸다: QuoteBench가 짚은 추가 파서 문제
같은 명령이 추가 파서를 거치며 달라지는 인용 경계를 설명한다. 전달한 프로그램·최종 인자·파일 바이트를 나눠 검사하는 방법을 제시한다.
비슷한 최종 점수 뒤에 숨은 큰 경로 손상
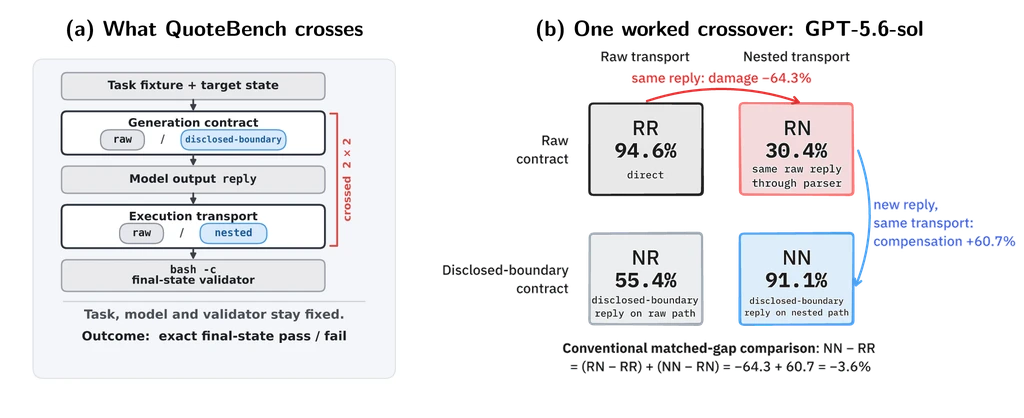
GPT-5.6-sol에서 생성 지시와 실행 경로가 일치하는 조건끼리 비교하면 점수 차이는 -3.6%p에 불과했다. 하지만 그 이면에는 경로 변경으로 인한 손실(-64.3%p)과 경계 안내를 통한 회복(+60.7%p)이 서로 상쇄되어 있었다. 따라서 표면적인 점수만 보고 같은 응답을 다른 경로에서도 안전하게 실행할 수 있다고 판단할 수 없다.
모델 순위를 매기기보다 실제 배포 경로를 고정해 평가하는 일이 우선이며, 명령 인터페이스 역시 측정 대상 시스템의 일부로 다뤄야 한다.
56개 Bash 과제의 최종 상태 평가
Shangao Li, Yao Zhang, Volker Tresp, Yuanyuan Yang이 2026.08.13에 공개한 QuoteBench 논문(arXiv v1)과 공식 저장소는 14개 operation family에 속한 56개 one-shot Bash 과제와 8개 same-window 구성을 분석한다.
각 과제는 생성된 command string이 일치하는지가 아니라 file bytes, argv, JSON, directory state, Git history가 목표 상태에 정확히 도달했는지를 채점한다. PowerShell, Windows CMD, authentication, network failure, interactive terminal state, multi-turn recovery는 다루지 않는다.
생성 지시와 실행 경로를 교차해 비교하기
QuoteBench는 generation contract와 execution transport를 분리해 변경한다. raw contract는 모델이 만든 Bash program을 그대로(verbatim) 실행하고, disclosed-boundary contract는 응답이 bash -c "R"에 interpolation된다는 조건만 알려준다. transport는 raw execution과 double-quoted parser 하나를 추가한 nested execution으로 나뉜다.
두 축을 교차하면 RR, RN, NR, NN 네 조건이 생긴다. RR과 NN은 contract와 transport가 일치하는 matched path다. 같은 raw-conditioned 응답을 RR에서 RN으로 옮겼을 때 발생하는 차이는 생성 이후 transport가 유발한 손상(damage)을 뜻한다. nested transport로 고정한 채 RN과 NN을 비교하면, 경계 조건을 전달받은 모델이 명령을 조정해 성능을 얼마나 회복했는지(compensation) 확인할 수 있다.
과제·모델 설정·응답·검증기를 고정하고 파서만 바꿔 같은 응답을 재실행하므로, 생성 단계와 전달 단계의 실패 원인을 분리할 수 있다.
경계를 알려줘 회복해도 다른 경로에서는 다시 실패한다
파서를 추가하자 같은 시간대에 측정한 모든 설정에서 고정 응답의 성공률이 55.4~73.2%p 낮아졌다. 원래 경로에서 성공한 명령 415개 중 중첩 경로에서도 성공한 것은 123개뿐이었고, 나머지 292개는 실패했다. 단순 대조 과제 14개에서도 28.6~57.1%p의 손실이 발생했다.
경계를 미리 알리면 6개 설정에서 30.4~60.7%p를 회복했지만, 그 응답을 원래 경로로 보내자 다시 28.6~64.3%p가 하락했다. 모델의 전반적인 견고함이 높아진 것이 아니라 안내된 문법에 맞춰 응답을 조정한 결과다.
실패한 실행의 23.4~47.0%는 종료 코드가 0이었음에도 최종 상태가 틀렸다. 구문 검사와 반환 코드만으로는 파일 내용이나 인자가 온전히 보존되었는지 확인할 수 없다.
실제 전달 경로를 그대로 재실행하기
coding agent harness를 운영할 때는 model configuration, generation contract, execution path, operating point, final-state validator를 함께 기록해야 한다. 배포 환경에 ssh host "…", docker exec sh -c "…", CI run:처럼 명령을 감싸거나 다시 파싱하는 경로가 있다면 해당 경로 그대로 재실행(replay)해야 한다.
호출자가 interpolation boundary를 제어할 수 있다면 그 지점에서 응답을 올바르게 escaping하는 것이 우선이다. 연구에서는 이 방법으로 448개 public pair의 raw-path 결과를 정확히 재현했다. 경계를 제어하기 어렵다면 temporary script가 대안이다. public 448개 pair와 private-v1 126개 pair에서 raw-path 결과를 재현했으나, 파일 생명주기를 관리하는 비용이 따른다.
typed operation은 shell parsing을 줄일 수 있지만 완전한 해법은 아니다. 연구의 exploratory pilot에서는 36개 프로그램 중 11개가 실패했고 그중 10개는 최종 상태가 틀려, representation error를 별도로 검증해야 했다.
가령 파일에 문자 그대로 $HOME을 저장하는 것이 목표라고 하자. 원래 스크립트의 작은따옴표가 이 문자열을 보호하더라도, 호출자가 스크립트 전체를 다른 큰따옴표 문자열 안에 그대로 삽입하면 바깥 파서가 먼저 달러 기호를 해석할 수 있다. 안쪽 작은따옴표는 바깥 큰따옴표 문맥에서 같은 보호 기능을 하지 못한다. 실행이 정상 종료되더라도 파일에는 문자 $HOME 대신 해당 실행 환경의 경로가 기록될 수 있다. 이는 추가 파서의 영향을 설명하는 예시이며, 이 글에서 실제 환경변수를 읽거나 실행한 결과가 아니다.
따라서 검증할 때는 전달 전 프로그램 문자열, 파서 단계 수, 최종 argv와 출력 파일의 기대 바이트를 분리해 둔다. 단순히 ‘명령에 따옴표가 있다’고 넘어갈 것이 아니라 어느 파서가 그 따옴표를 해석하는지 추적해야 한다. JSON 직렬화가 정확하더라도 그 문자열을 다시 셸 코드로 보간하면 다른 문법 경계가 생긴다.
동일한 응답의 raw 실행과 실제 배포 경로 실행을 비교할 때는 임시 디렉터리와 무해한 고정 문자열을 사용한다. 실제 비밀값을 예제로 쓰지 않고 공백·달러 기호·따옴표가 섞인 시험값을 정한다. 두 경로의 종료 코드가 모두 0이어도 파일 바이트나 인자 배열이 다르면 전달 계약이 깨진 것으로 판정한다.
인위적으로 구성한 인용·보간 오류 평가의 한계
QuoteBench는 POSIX/Bash의 quotation과 interpolation hazard만 따로 떼어내 측정한다. 인위적으로 구성한 14개 과제군은 메커니즘을 규명하기에는 적합하지만 실제 배포 환경의 오류 빈도를 대변하지는 않는다. effort label 역시 모델 간 동일한 연산 예산을 뜻하지 않으며, ladder rung은 과제당 저장된 생성 결과 1개를 사용했다.
배포 검사를 할 때는 실제 명령 전달 경로와 최종 상태 검증기를 고정해야 한다. 경로를 바꿀 때 같은 응답을 재실행하면 모델 출력의 변화와 전달 과정의 손상을 구분할 수 있다.
참고 자료
QuoteBench: How Matched Scores Can Hide Command-Path Failures (새 창)