AI 코딩으로 구현을 줄여도 출시가 늦어질 수 있는 이유: 검토·재작업 비용
명세·구현·검토·재작업 시간을 합쳐 생산성을 비교하고, 테스트 통과가 요구사항 누락을 감추는 경우를 살펴본다.
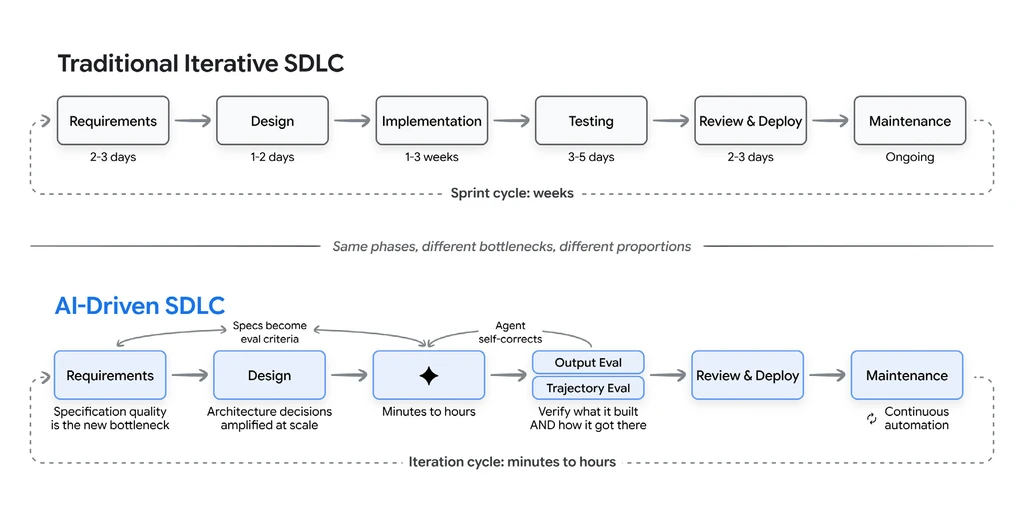
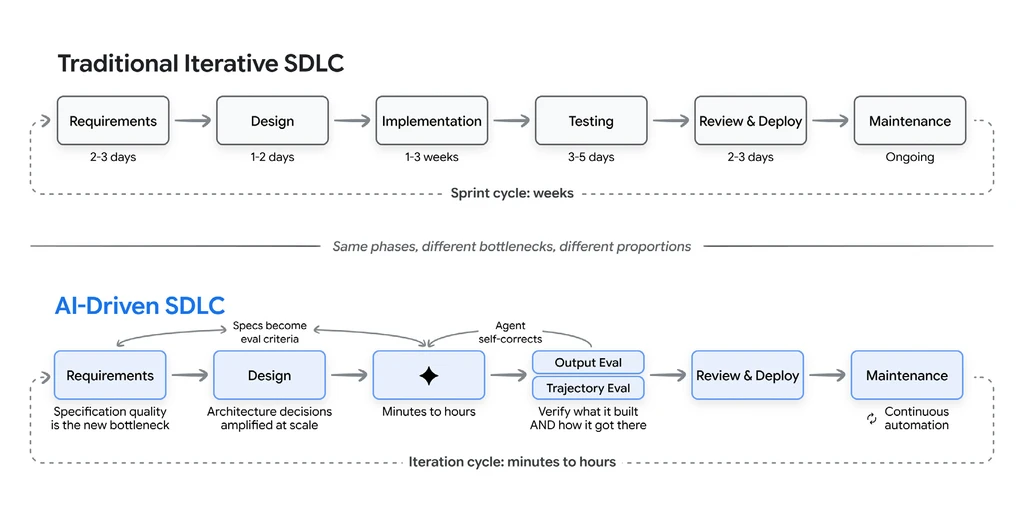
AI 코딩의 작업 범위가 넓어져도 구현 속도만으로 생산성을 판단할 수는 없다. 명세·컨텍스트·테스트·검토 비용을 함께 관리하자는 Google 화이트페이퍼와 공동 저자 해설을 살펴본다.
Google 화이트페이퍼 "The New SDLC With Vibe Coding"과 공동 저자가 2026년 6월 16일 공개한 해설을 정리한다. 저자는 Addy Osmani, Shubham Saboo, Sokratis Kartakis다.
저자들은 자연어 의도를 코드로 옮기는 도구가 보편화될수록 개발 과정의 명세와 검증을 더 체계적으로 다뤄야 한다고 주장한다. 코드 작성이 사라진다는 측정 결과가 아니라 개발 방식에 관한 관점이다.
공동 저자 해설은 2026년 초 기준 AI 코딩 에이전트 정기 사용 85%, 매일 사용 51%, 신규 코드 중 AI 생성 비중 약 41%라는 수치를 제시한다. 다만 해당 해설만으로는 각 수치의 원조사 표본과 분모를 확인할 수 없어 전체 개발자 집단의 확정 통계로 일반화하지 않는다.
| 수준 | 맡기는 단위 |
|---|---|
| 자동완성 | 다음 토큰 제안 |
| 코드 제안 | 문맥에 맞는 코드 블록 |
| 대화형 생성 | 자연어로 요청한 구현 |
| 코딩 에이전트 | 파일 수정·실행·테스트 |
| 자율 에이전트 | 작업 단위 위임·검토 |
바이브 코딩의 개념
2025년 2월, Andrej Karpathy가 새로운 프로그래밍 방식을 묘사하는 글을 올렸다. 바이브에 완전히 몸을 맡기고 코드가 존재한다는 사실조차 잊는 방식이다. 자연어로 원하는 바를 설명하고 AI 출력을 받아들이며 에러 메시지를 복사해 다시 AI에게 전달하는 워크플로다.
이 용어가 널리 퍼진 이유는 많은 개발자가 이미 이렇게 일하고 있었기 때문이다. 하지만 용어가 광범위하게 쓰이면서 의미가 희석됐고, 2026년 초 Karpathy 본인이 원래 틀이 너무 좁았다고 인정하며 더 규율 있는 방식을 가리키는 에이전틱 엔지니어링이라는 용어를 도입했다.
바이브 코딩에서 에이전틱 엔지니어링으로
이 둘은 이분법으로 나누기보다 스펙트럼의 양 끝으로 보는 편이 유용하다. 핵심 차별점은 AI 사용 여부가 아니라 AI 출력을 둘러싼 구조, 검증, 인간의 판단 유무다.
저자들이 강조하는 차이는 검증 절차다. 결정적인 동작은 테스트로, 열린 품질이나 반복 실행의 변동성은 eval로 확인한다. 특정 도구의 사용 여부보다 출력과 실행을 어떻게 검사하는지가 판단 기준이다.
| 차원 | 바이브 코딩 | 구조화된 AI 보조 코딩 | 에이전틱 엔지니어링 |
|---|---|---|---|
| 의도 명세 | 캐주얼한 자연어 프롬프트 | 예시와 제약 조건이 있는 상세 프롬프트 | 공식 스펙, 아키텍처 문서, 메모리 파일 |
| 검증 | "동작하는 것 같은가?" | 수동 테스트, 스팟체킹 | 자동화 테스트 스위트, CI/CD 게이트, LM 판사 |
| 적합한 범위 | 프로토타입, 스크립트, 해커톤 | 기존 코드베이스 내 기능 | 프로덕션 시스템, 팀 규모 개발 |
| 리스크 프로파일 | 높음; 버려도 되는 코드에서는 허용 가능 | 중간; 핵심 체크포인트에서 인간 판단 | 체계적 검증으로 줄이되 잔여 위험은 존재 |
컨텍스트 규칙과 자료 분리
해설은 컨텍스트의 질을 주요 설계 요소로 제시하며 여섯 가지 유형으로 나눈다. 프롬프트 표현과 컨텍스트 중 어느 쪽이 더 중요하다는 보편적인 효과 크기를 측정한 결과는 아니다.
지침(Instructions): 에이전트의 핵심 역할, 목표, 운영 경계. 지식(Knowledge): 검색된 문서, 아키텍처 다이어그램, 도메인 특화 데이터. 메모리(Memory): 단기 세션 로그와 장기 영속 상태. 예시(Examples): 퓨샷 행동 데모와 코드베이스 참조 패턴. 도구(Tools): 에이전트가 호출할 수 있는 API, 스크립트, 외부 서비스의 정밀 정의. 가드레일(Guardrails): 하드 제약, 포맷 규칙, 안전 검증.
핵심 설계 결정은 정적 컨텍스트와 동적 컨텍스트의 경계를 나누는 일이다.
정적 컨텍스트는 항상 로드된다. 시스템 지침, 규칙 파일(AGENTS.md, CLAUDE.md, GEMINI.md), 글로벌 메모리가 여기에 해당하며 모든 상호작용에서 토큰 비용이 발생한다. 동적 컨텍스트는 필요할 때만 로드된다. 태스크 매칭으로 트리거되는 스킬 지침, 실행 중 검색된 툴 결과, RAG 파이프라인 문서 등이며 정보가 필요할 때만 토큰 비용을 지불한다.
정적과 동적의 경계를 어디에 두느냐는 엔지니어링 트레이드오프다. 정적 컨텍스트가 너무 많으면 토큰을 낭비하고 신호가 희석된다. 너무 적으면 에이전트가 중요한 규칙을 잊는다.
AI가 바꾸는 SDLC 단계
해설은 구현 단계가 빨라질 때 요구사항·아키텍처·검증이 상대적으로 큰 부담이 될 수 있다고 설명한다. 그림의 분·시간 단위는 개념적 비교이며 모든 팀의 개발 기간을 측정한 통계가 아니다.
원본 그림 크게 보기 (https://portfolio.ywsung.com/static/images/05511010-beec-4bf1-bb46-77a7d8c296e8.webp (새 창)) · 공식 원문 (https://addyosmani.com/blog/new-sdlc-vibe-coding/ (새 창))
요구사항과 기획: AI 도구는 제품 브리프에서 유저 스토리를 만들고, 인간이 놓치는 엣지 케이스를 찾아내며, 자연어 설명에서 API 스키마를 생성한다. 요구사항은 팀 간 문서를 넘어 인간과 AI가 나누는 대화가 된다.
아키텍처에서는 일관성과 가용성, 복잡성과 유연성, 직접 구축과 구매 사이의 선택이 남는다. AI가 구현을 보조하더라도 비즈니스 조건과 장기 운영 부담을 고려한 결정은 별도로 내려야 한다.
해설이 인용한 조사에는 25~39%의 생산성 향상이 나타나지만, METR의 특정 숙련 개발자 작업에서는 AI 도구를 사용했을 때 시간이 19% 더 걸렸다. 대상·과제·측정 방식이 다른 수치이므로 직접 우열을 계산할 수는 없다. 검토·디버깅·수정 시간을 포함해 각 작업 환경에서 다시 측정해야 한다.
테스트와 QA: AI 생성 코드를 테스트할 때는 에이전트가 무엇을 만들었는지와 함께 그 결과에 어떻게 도달했는지도 평가해야 한다. 출력 평가는 최종 산출물을 확인하고, 트레젝토리 평가는 툴 호출과 중간 추론의 전체 시퀀스를 확인한다. 검증 단계를 건너뛴 유창한 출력은 눈에 보이는 에러보다 더 위험한 실패다.
모델과 하네스로 구성되는 에이전트
모델 버전만으로 에이전트 전체 성능을 설명하기는 어렵다. 같은 모델이라도 도구·컨텍스트·실행 환경이 다르면 다른 결과를 낸다.
harness는 prompt, 도구, 컨텍스트 정책, 훅, sandbox, 작업 조율, 관측 기능을 포함하는 실행 주변 구조다. 해설은 모델과 이 구성을 함께 평가해야 한다고 본다.
Agent = Model + Harness
하네스를 구성하는 요소:
지침 및 규칙 파일: 에이전트의 정체성과 규칙을 정의하는 텍스트. AGENTS.md, CLAUDE.md, GEMINI.md, 스킬 파일, 서브에이전트 프롬프트를 포함한다.
툴: 에이전트가 호출할 수 있는 함수, MCP 서버, API와 모델 호출 설명.
샌드박스와 실행 환경: 에이전트 코드가 실행되는 공간과 접근 권한.
오케스트레이션 로직: 서브에이전트 생성, 모델 라우팅, 전문가 간 핸드오프.
가드레일 또는 훅: 특정 라이프사이클 지점에서 실행되는 결정론적 코드.
관측 가능성: 로그, 트레이스, 평가, 비용 및 레이턴시 측정.
Terminal Bench 2.0에서 한 팀은 모델 변경 없이 하네스만 교체해 코딩 에이전트 순위를 Top 30 밖에서 Top 5로 끌어올렸다. LangChain 연구에서는 고정된 모델 주변의 시스템 프롬프트, 툴, 미들웨어만 조정해 벤치마크 점수를 13.7점 높였다. 이를 근거로 에이전트가 실패할 때 모델 교체보다 하네스 설정을 먼저 점검하자고 권한다.
개발자의 역할: 방향 설정과 검증
AI가 구현 작업을 더 많이 맡으면서 개발자의 역할은 두 가지 모드를 오간다.
컨덕터(Conductor): AI 페어 프로그래머와 실시간으로 협업한다. IDE에서 코드가 생성되는 과정을 지켜보고 프롬프트와 수정으로 방향을 안내하며 작성 내용을 세밀하게 제어한다. 복잡한 로직 작업이나 까다로운 디버깅, 변경 내용에 대한 깊은 이해가 필요할 때 적합하다. GitHub Copilot, Cursor, Windsurf가 이를 지원한다.
오케스트레이터(Orchestrator): 더 높은 추상화 수준에서 작업한다. 목표를 정의해 에이전트에 할당하고 결과를 검토한다. 코드가 한 줄씩 작성되는 과정을 지켜보는 대신, 에이전트들이 백그라운드에서 코드베이스의 여러 부분을 병렬로 작업하게 한다. 잘 정의된 버그 수정, 기존 패턴을 따르는 기능 구현, 코드베이스 마이그레이션, 테스트 생성에 적합하다.
80% 문제
저자가 말하는 80% 문제는 초안 생성보다 마무리 검증이 더 어렵다는 비유다. 모든 기능에서 측정한 고정 비율은 아니다. 엣지 케이스, 에러 처리, 통합 지점과 미묘한 정확성 요구사항을 다루려면 깊은 맥락 지식이 필요하다.
AI 에러는 단순한 문법 실수에서 더 교묘한 개념적 실패로 진화했다. 비즈니스 로직에 대한 잘못된 가정, 모호한 요구사항 미확인, 누락된 엣지 케이스 등이 대표적이다. 이런 에러는 겉보기에 코드가 그럴듯하고 기본 테스트도 통과하기 때문에 감지하기 어렵다.
실무에 적용하려면 명세가 분명한 구현과 미확정 요구사항을 나눈다. 전자는 에이전트의 실행·검증 대상으로, 후자는 사람의 확인과 설계 판단 대상으로 둔다.
AI 개발의 경제학
속도 외에도 엔지니어링 리더에게 중요한 지표는 총 소유 비용(TCO)이다. 워크플로가 CapEx(구축 선행 투자)와 OpEx(운영 유지 비용) 사이의 부담을 어떻게 이동시키는지 살펴야 한다.
즉흥적인 생성은 초기 준비를 줄이는 대신 반복 수정과 코드 이해 비용을 뒤로 미룰 수 있다. 저자가 낮은 CapEx·높은 OpEx로 설명한 부분이다. 실제 비용은 작업과 검토 방식에 따라 달라진다.
스키마·테스트·컨텍스트 구조에 선행 투자하면 반복 작업과 유지보수 비용을 줄일 수 있다. 높은 CapEx·낮은 OpEx는 이 효과를 설명하는 관점이며, 모든 프로젝트에서 한계 비용이 줄었다는 실측 결과는 아니다.
작업 난이도에 따른 모델 선택도 비용 절감 요소다. 복잡한 작업과 단순한 검사를 나눠 더 작은 모델이 기준을 만족하는지 비교할 수 있다.
가상의 작업에서 사람이 구현에 60분, 검토와 수정에 20분을 썼다고 하자. AI로 구현 시간이 30분으로 줄어도 요구사항 확인과 검토·재작업에 60분이 걸리면 총시간은 80분에서 90분으로 늘어난다. 구현 구간의 50% 단축과 전체 작업 시간의 12.5% 증가는 동시에 참이다. 이 계산은 특정 제품의 생산성 측정이 아니라 측정 범위의 차이를 드러내는 예시다.
비교 단위는 생성한 코드 줄 수보다 동일한 합격 조건을 충족한 변경이다. 예를 들어 할인 기능에서 정상 할인만 테스트하면 환불·중복 적용·기존 가격과의 호환 요구가 누락된 구현도 빠르게 통과할 수 있다. 에이전트가 자기 구현만 설명하는 테스트를 더 만든다고 해서 이 공백이 메워지지는 않는다. 변경 전 명세와 실제 실패 가능성을 바탕으로 합격 조건을 정해야 한다.
같은 개발자가 같은 문제를 두 번 풀면 두 번째에는 문제를 이미 안다는 학습 효과가 섞인다. 비교 작업의 난이도와 기존 코드 이해도를 맞추고, 구현뿐 아니라 대기·검토·재작업 시간을 함께 기록한다. 작은 표본에서 나온 차이는 해당 작업군의 관찰로 남기고 조직 전체의 생산성 향상으로 확대하지 않는다.
시작하는 법
개인 개발자라면 프로젝트에 AGENTS.md를 설정한다. 스택, 컨벤션, 규칙, 워크플로를 10줄로 시작하고 에이전트가 반복하는 실수를 교정할 때마다 규칙을 추가한다. 코드를 생성하기 전에 테스트와 eval을 작성하고, 출시할 코드라면 에이전트가 생성한 모든 줄을 검토한다.
팀에서는 규칙 파일·시스템 prompt·평가셋·skill 라이브러리를 변경 이력이 남는 코드처럼 관리한다. 평가를 통과했다고 해서 실제 분포의 모든 실패를 막을 수 없다는 한계도 염두에 둔다.
조직에서는 에이전트 수를 늘리기 전에 도구 권한, 위임 책임, 평가와 검토 절차를 정한다. MCP나 A2A 같은 표준은 실제 연결·위임 경계가 있을 때 검토하고, 구현 단축이 검토 병목으로 이어졌는지 측정한다.
구현 시간과 검토 비용의 비교
적용의 출발점은 다음 세 가지다.
탐색용 초안과 조직이 유지할 코드를 구분한다. 후자에는 명세·테스트·실행 제약·아키텍처 검토가 필요하다.
기존 테스트와 코드 리뷰를 기준선으로 두고 AI 도입 후 실패 증감을 기록한다.
개발자의 검토 시간도 비용에 포함한다. 구현이 빨라져도 요구사항 확인과 통합 검증이 늘었다면 전체 작업 기간은 다르게 변할 수 있다.
출처: Addy Osmani, Shubham Saboo, Sokratis Kartakis, "The New SDLC With Vibe Coding: From ad-hoc prompting to Agentic Engineering" (Google; 공동 저자 해설 2026. 6. 16.)
참고 자료
The New Software Lifecycle — Addy Osmani (https://www.oreilly.com/radar/the-new-software-lifecycle/ (새 창))
Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity — METR (https://metr.org/Early_2025_AI_Experienced_OS_Devs_Study-paper.pdf (새 창))