Mistral Large 4는 100만 토큰에서 무엇을 읽나: 위치 선택과 KV 압축
Mistral Large 4의 top-k 위치 선택을 작은 점수 예제로 풀고, Transformers의 마스크·커널 경로를 따라간다. KV 압축과 전문가 선택이 서로 다른 비용을 줄이는 이유를 설명한다.
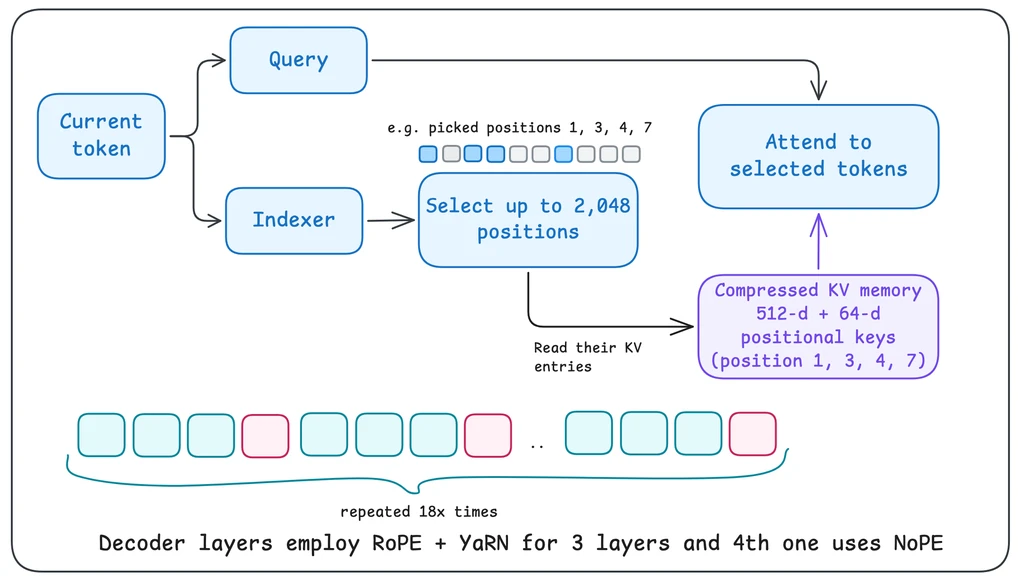
100만 토큰을 입력받는 모델이 쿼리마다 최대 2,048개 위치만 참조한다면 나머지 문서는 버리는 것일까? Mistral Large 4를 이해하려면 문맥을 보관하는 일, 읽을 위치를 고르는 일, 선택한 위치로 답을 계산하는 일을 구분해 봐야 한다. 선택에서 빠진 위치가 곧 캐시에서 삭제된 위치는 아니다.
작은 문서에서 위치를 고르는 예제부터 시작해 실제 Transformers 구현까지 따라가 보자. 아래 점수와 저장량 예제는 원리를 설명하기 위한 가정이며, 모델을 직접 실행해 속도나 한국어 장문 정확도를 측정한 결과는 아니다.
먼저 위치를 고르고, 고른 위치로 어텐션을 계산한다
Hugging Face 구조 해설 (새 창)에 따르면 DSA 인덱서는 쿼리마다 최대 2,048개 키 위치를 선택한다. 이는 문서 끝에서 2,048개만 남기는 고정 창 방식과 다르다. 아래 그림의 1·3·4·7도 선택된 위치의 예시일 뿐, 항상 고정되어 남는 위치가 아니다.
참조 가능한 위치가 1부터 8까지인 가상 문서에서, 설명을 위해 선택 한도를 3으로 줄여 보자. 인덱서 점수가 [0.2, 0.9, 0.1, 0.8, 0.3, 0.4, 0.7, 0.0]이라면 상위 위치는 2·4·7이다. 현재 쿼리는 이 집합을 대상으로 본 어텐션을 계산한다. 다음 쿼리에서는 점수가 달라져 1·5·8을 선택할 수도 있다. 이는 실제 모델의 선택 결과가 아니라 top-k 연산 과정을 보여 주는 예제다.
여기서 인덱서 점수 0.9를 최종 답변에서 위치 2가 차지하는 확률 90%로 해석하면 안 된다. 후보 위치를 고르는 점수와 선택한 키·값으로 계산하는 어텐션 가중치는 서로 다른 단계다. 위치를 골랐다는 사실만으로 그 근거가 최종 답에 올바르게 쓰였다고 단정할 수도 없다.
코드에서는 인덱스와 마스크가 서로 다른 경로를 탄다
Transformers의 고정 리비전 구현 (새 창)을 보면, MistralLarge4TextIndexer는 쿼리와 키로 점수를 만들고 ReLU와 헤드별 가중합을 거쳐 위치 점수를 구한다. 여기에 인과 마스크를 적용한 뒤 topk로 위치 인덱스를 반환한다. 쿼리보다 미래에 있는 토큰을 정상적인 참조 대상으로 고르지 않도록 막는 조건이다.
선택 한도는 min(index_topk, 현재 키 길이)로 정한다. 문맥이 8개뿐인데 2,048개 위치를 새로 만들어 읽는 것은 아니다. 일부 공유 인덱서 층은 앞선 층의 top-k 위치를 재사용한다. 따라서 모든 층이 독립적으로 새 위치를 고른다는 설명도 정확하지 않다.
같은 구현 안에서도 실행 경로는 나뉜다. eager·SDPA 경로는 top-k 결과로 희소 마스크를 만들고, flash-mla 경로는 선택한 인덱스를 커널에 넘긴다. 모델 구조가 희소하다는 말과 실제 커널이 그만큼의 연산을 생략한다는 말은 같지 않다. 선택 개수의 비율만으로 GPU 가속 배수를 계산할 수 없는 이유가 여기에 있다.
예를 들어 참조 후보가 100만 개일 때 2,048개는 약 0.205%다. 이는 선택된 위치 수의 비율일 뿐, 전체 실행 시간이 488배 짧아진다는 뜻은 아니다. 위치를 고르는 계산, KV 접근, 다른 층의 연산과 커널 구현이 여전히 남기 때문이다. 위 코드는 직접 읽어 대조했으며, 해당 모델의 실행 시간을 따로 측정하지는 않았다.
읽지 않은 위치도 압축 KV에는 남을 수 있다
MLA는 이전 토큰의 키·값 표현을 압축해 보관하는 방식이다. 앞선 코드에서는 압축된 latent KV 상태를 캐시에 갱신한 뒤 top-k를 적용한다. 실제 실행 순서에서도 위치 선택과 저장 표현의 압축이 별도 단계라는 점이 드러난다.
단순한 가정으로 토큰마다 압축 상태를 1KiB씩 보관한다고 해 보자. 10만 토큰이면 약 97.7MiB, 100만 토큰이면 약 976.6MiB가 된다. 선택 한도가 같더라도 저장해야 할 토큰 수가 늘어나면 이 상태량도 함께 커진다. 이는 실제 Mistral Large 4의 메모리 추정치가 아니며, 층 수·공유 구조·추가 인덱서 상태·가중치·임시 버퍼를 제외하고 비례 관계만 보여 준 계산이다.
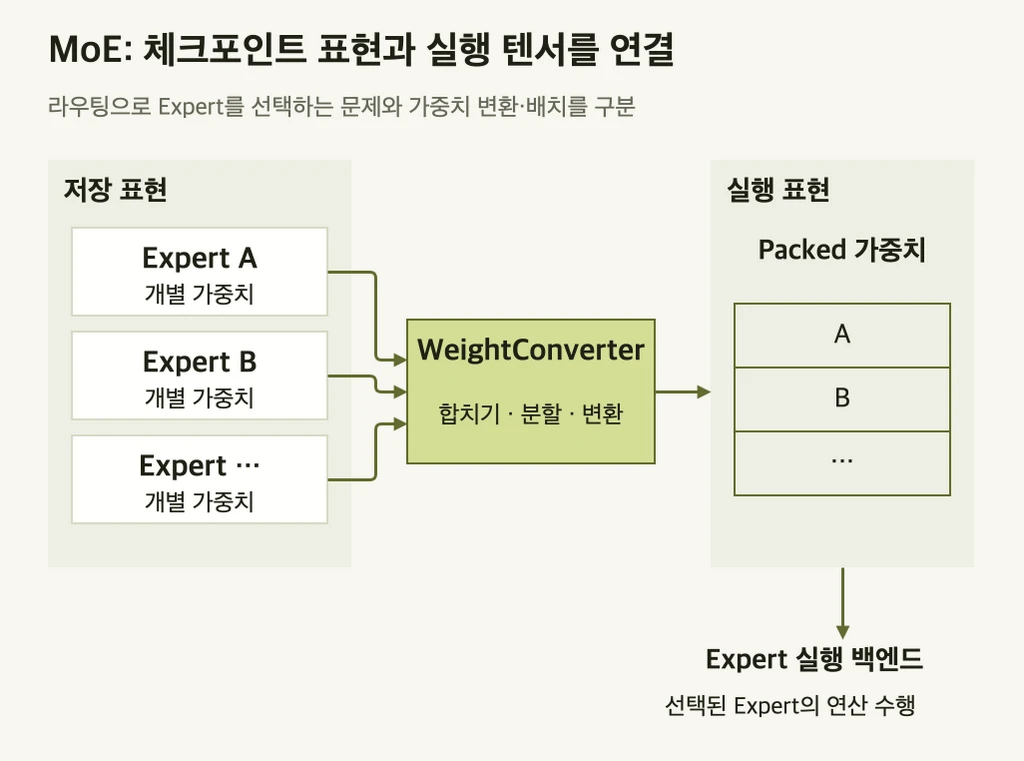
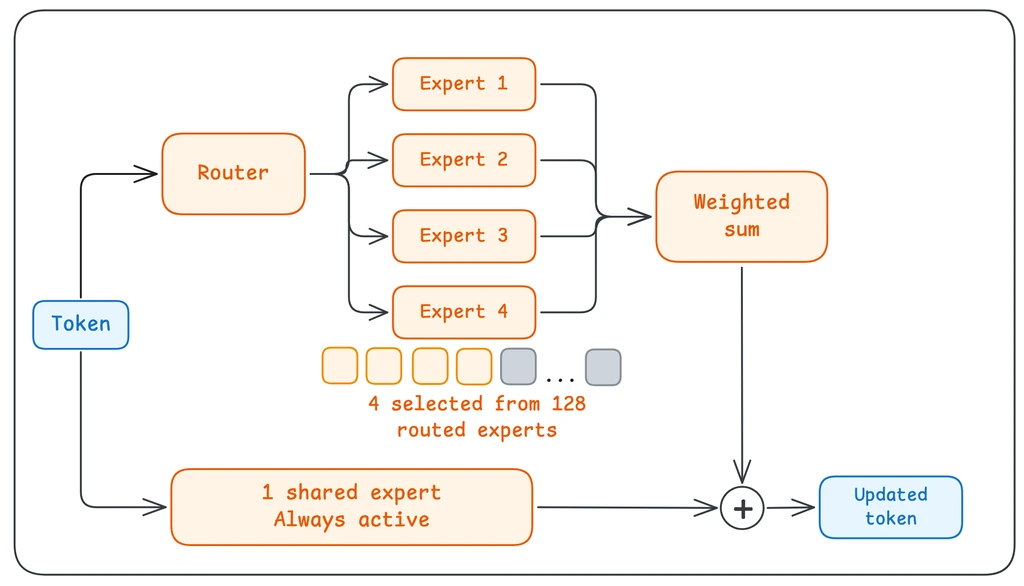
MoE가 고르는 대상은 또 다르다. 공식 모델 카드 (새 창)는 라우팅 전문가 128개 중 4개와 공유 전문가 1개를 사용한다고 설명한다. 이는 문서 내 위치가 아니라 실행할 연산망을 선택하는 과정이다. 전문가를 적게 실행한다고 해서 나머지 전문가의 가중치가 메모리에서 자동으로 사라지는 것도 아니다. 위치 선택, KV 압축, 전문가 라우팅을 하나의 절감률로 곱해서는 안 된다.
문맥 길이는 서버가 허용하는 조건 안에서 쓰인다
모델 카드 (새 창)에 명시된 100만 토큰 문맥 지원은 모델의 능력 범위를 뜻한다. 실제 서버에서는 --max-model-len으로 길이를, --max-num-seqs로 동시 요청 수를 제한할 수 있다. 메모리가 부족해 이 설정값을 낮추면 서버가 구동되더라도 원래 서비스 요구사항을 충족하지 못할 수 있다.
가상 서비스가 20만 토큰짜리 문서를 처리해야 하는데 서버의 최대 길이를 그보다 작게 설정했다면, 모델이 100만 토큰을 지원한다는 사실만으로는 이 간극이 해결되지 않는다. 전처리 단계에서 문서가 잘려 나갔다면 인덱서가 살펴볼 후보 자체가 사라진다. 이때 답을 놓친 원인을 희소 선택의 실패로 돌리기 전에, 실제 입력 길이와 문서 잘림 여부부터 확인해야 한다.
근거를 보존했는지와 활용했는지를 따로 확인한다
사내 문서 질의를 가정한다면, 같은 답의 근거를 문서의 앞·중간·뒤로 옮겨 보고 비슷하지만 틀린 문장도 함께 넣어 볼 수 있다. 먼저 문서 길이를 고정해 위치에 따른 영향을 살피고, 이후 길이만 바꾸어 다시 비교한다. 입력 전처리와 서버 설정이 동일해야 두 결과의 차이를 명확히 해석할 수 있다.
점검할 경로는 세 단계다. 근거가 실제 입력에 포함되었는지, 모델이 그 근거를 찾아내 답했는지, 답변과 인용이 원문을 뒷받침하는지다. 내부 인덱스 로그를 확인하지 못했다면 실패 원인을 인덱서 탓으로 단정할 수 없다. 반대로 정답을 맞혔더라도 관련 위치를 모두 충분히 참조했다고 보장할 수는 없다.
100만 토큰은 후보 문맥의 범위이고, 2,048개는 특정 쿼리의 참조 선택 한도다. 실제 필요한 문서 크기와 동시 요청 조건에서 정답·인용·지연·최대 메모리를 함께 확인해야 두 숫자가 서비스에 갖는 의미를 알 수 있다. 구조 설명은 시험할 지점을 짚어 주며, 실제 도입 여부는 해당 조건에서 얻은 결과로 판단한다.