Diffusion Controller를 붙일 수 없는 API: 중간값 접근과 보정 개입의 차이
가중치를 고정해도 생성 과정에 접근할 인터페이스는 필요하다. 단계별 출력만 읽는 API와 보정값으로 다음 상태를 바꾸는 API를 구분하고 전체 비용을 계산한다.
Google Research의 Chih-wei Hsu와 Moonkyung Ryu는 Tong Yang 외 저자들이 2026년 3월 7일 제출한 논문 (https://arxiv.org/abs/2603.06981 (새 창))을 바탕으로, 2026년 9월 29일 Diffusion Controller 해설 (https://research.google/blog/how-diffusion-controller-unifies-and-simplifies-ai-image-generation/ (새 창))을 공개했다.
고정한 모델 옆에서 생성 방향을 보정한다
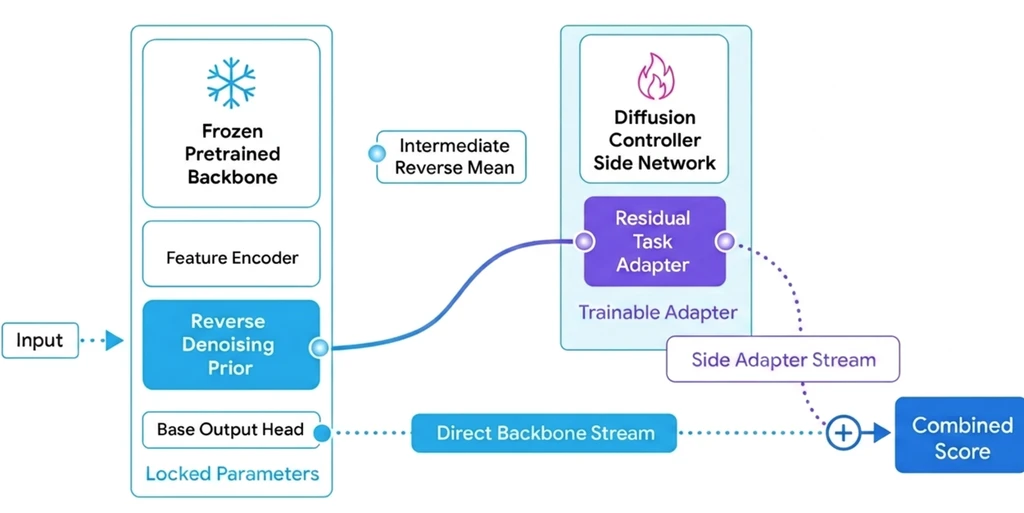
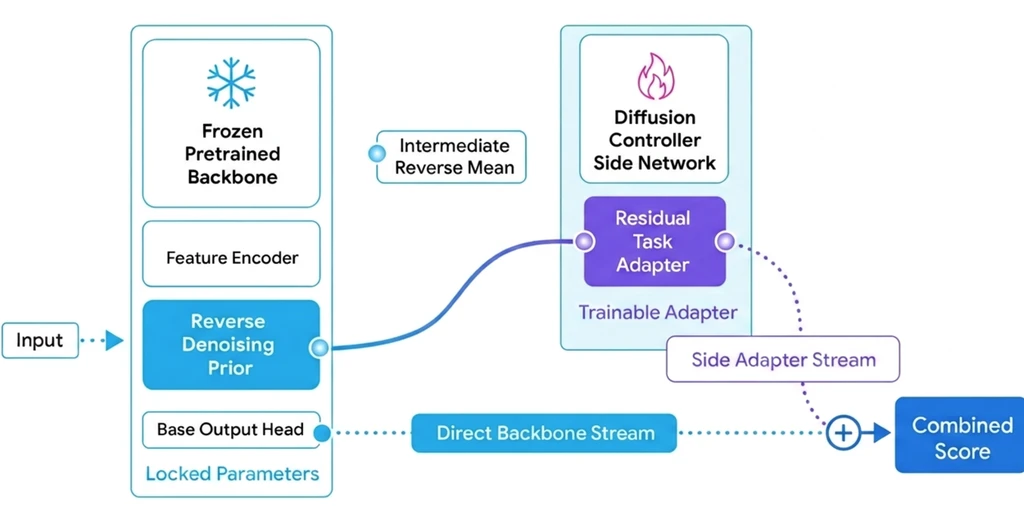
확산 모델은 노이즈에서 출발해 여러 단계를 거치며 이미지를 복원한다. Diffusion Controller는 사전 학습 모델의 가중치를 고정한 채 별도 제어망이 계산한 보정값을 기존 생성 경로에 더하는 방식이다. 공식 구조도를 보면 왼쪽의 동결된 본체와 오른쪽의 학습 가능한 제어망에서 나온 두 출력이 합쳐지는 지점을 확인할 수 있다.
제어망은 완성된 이미지에 필터를 씌우는 후처리기가 아니다. 논문에서는 각 단계마다 노출되는 노이즈 예측이나 역과정 평균 같은 중간 출력에 조건을 걸어 제어망을 학습한다. 원본 모델의 가중치를 고정한다는 조건과 생성 과정에 전혀 접근하지 않는다는 조건은 다르다.
원본 망 내부에 학습 가능한 어댑터를 삽입하는 LoRA와 달리, 제어망은 본체 바깥에서 보정값을 계산한다. 이 구조는 모델 수정 권한이 제한된 환경에서 유용할 수 있지만, 본체를 건드리지 않는 대신 필요한 중간 출력과 제어 지점이 인터페이스로 열려 있어야 한다.
가중치 비공개와 생성 과정 비공개는 다르다
논문이 가정하는 gray-box는 내부 구조를 전부 알지는 못해도 일부 중간 출력에는 접근할 수 있는 환경이다. 반면 프롬프트를 보내고 완성된 이미지 파일만 돌려받는 일반 API는 접근 범위가 좁다. 따라서 모델 가중치가 비공개라는 사실만으로는 이 방식의 적용 가능성을 판단할 수 없다.
외부 API에 적용하려면 단계별 출력이 노출되는지, 외부에서 계산한 보정값으로 다음 단계를 바꿀 수 있는지부터 확인해야 한다. 이런 인터페이스가 없다면 프롬프트를 조정하거나 생성된 후보 중에서 결과를 고르는 등 기존 API가 지원하는 방법을 쓰는 편이 현실적이다.
자체 모델을 운영하는 환경이라면 본체를 고정한 제어망과 LoRA를 동일한 데이터와 평가 조건에 놓고 비교할 수 있다. 본체 가중치를 보존하는 방식이 언제나 더 저렴하거나 빠른 것은 아니다. 별도 망을 운영하면 메모리와 연산이 추가로 들고, 모델 버전이 바뀔 때 호환성도 다시 검토해야 한다.
이해를 돕기 위해 세 가지 인터페이스를 비교해 보자. A는 프롬프트를 받아 PNG만 반환한다. B는 단계별 노이즈 예측을 읽을 수 있지만 다음 상태를 수정할 수는 없다. C는 현재 상태와 단계별 예측을 읽고, 외부 보정을 반영한 다음 상태로 샘플링을 이어갈 수 있다. A에는 제어망에 넣을 입력이 없고, B에는 보정 결과를 되돌려 넣을 경로가 없다. C에 이르러서야 필요한 접근 조건을 검토할 수 있다. 이는 특정 상용 API의 기능을 설명하는 예시가 아니라, 읽기 권한과 개입 권한을 구분하기 위한 가상 계약이다.
간단한 한 차원 예시로 기본 갱신 방향이 0.8이고 외부 보정이 −0.2라면, 둘을 합친 방향은 0.6이 된다. 읽기만 허용된 B는 0.8을 관찰하더라도 실제 생성 과정에 0.6을 반영하지 못한다. 이 수치는 논문의 확산 방정식이나 실제 모델 출력을 재현한 것이 아니며, 보정값을 계산하는 일과 실제로 적용하는 일의 차이를 보여준다.
선호도 개선을 제품 품질로 옮길 때
논문 실험 절 (https://arxiv.org/html/2603.06981v1#S5 (새 창))에서 사용한 기반 모델은 Stable Diffusion v1.4다. 지도 학습에는 HPD v2의 선호 이미지와 프롬프트를 쓰고, 보상 기반 학습에는 HPS-v2 평가 모델을 활용한다. 이 조건에서 얻은 선호도 개선 폭을 최신 상용 이미지 모델의 성능이나 실제 서비스의 지연 시간으로 그대로 치환할 수는 없다.
특히 공식 해설에 실린 비교 그래프는 막대마다 대조군이 다르다. 기본 제어망과 단순화한 제어망의 비교가 섞여 있고, 본체 내부에 접근하는 변형과 LoRA의 비교도 함께 들어 있다. 막대 높이만 보고 기본 제어망이 LoRA를 그 차이만큼 앞선다고 해석하면 서로 다른 비교 조건을 뒤섞게 된다.
또한 선호도 점수는 실무 요구사항의 일부만 반영한다. 예를 들어 상품 이미지를 제작할 때는 시각적 선호도 외에도 색상 일치, 로고 보존, 프롬프트에 없는 요소의 임의 추가 여부를 별도로 검증해야 한다. 선호도 점수가 아무리 높아도 필수 속성이 틀리면 실무에 쓸 수 없다.
상품 이미지 작업이라면 무엇을 비교할까
상품 이미지 제작에 쓰는 API가 완성된 이미지만 반환한다면 제어망 도입은 보류하고, 같은 프롬프트로 생성한 후보들을 고르는 기준부터 정리해야 한다. 색상이나 문구가 정확해야 하는 작업과 분위기만 맞추면 되는 작업을 나누면 후보 선택만으로도 충분한 영역이 드러난다.
중간값에 접근할 수 있는 자체 모델을 운영한다면 기본 모델, LoRA, 본체 고정 제어망에 동일한 평가 프롬프트와 생성 예산을 배정하고, 학습에 쓰지 않은 상품군으로 비교 실험을 구성한다. 학습 방식별로 접근 가능한 내부 정보의 범위도 함께 기록해야 결과를 정확히 해석할 수 있다.
평가할 때는 선호도 점수, 필수 속성 충족률, 실패 이미지 비율을 따로 집계하고, 이미지당 생성 시간과 메모리 사용량도 함께 비교한다. 반복 생성 횟수나 합격 임계값은 업무에서 허용하는 오류 수준과 비용에 맞춰 미리 설정해 둔다.
비용 역시 본체와 제어망을 합산해 계산한다. 가령 30단계 생성 과정에서 본체가 단계당 20ms, 제어망이 5ms를 쓴다면 전체 계산 시간은 600ms에서 750ms로 늘어난다. 통신 및 전후 처리는 제외한 가상 예시다. 만약 합격 이미지 비율이 0.50에서 0.75로 오르고 각 후보가 독립적이라고 가정하면, 합격 이미지 하나를 얻는 데 드는 기대 계산 시간은 600/0.50=1200ms에서 750/0.75=1000ms로 줄어들 수 있다. 반대로 합격 비율이 그대로라면 비용만 늘어난다. 실제 측정에서는 후보 간 상관관계와 재시도 한도까지 반영해 최종 채택된 이미지당 비용으로 비교한다.
성능 비교에 앞서 확인할 인터페이스
도입 여부는 사용할 모델의 인터페이스 명세와 비교 실험 결과를 바탕으로 판단한다. 중간 출력에 접근하고 보정에 개입할 지점이 없다면 제어망 검토를 멈추고 기존 API에서 가능한 후보 선택 방식을 평가한다. 두 인터페이스가 모두 확보됐다면 업무 실패율과 전체 생성 비용을 기준선과 비교해 최종 채택을 결정한다.
참고자료
Google Research — How Diffusion Controller unifies and simplifies AI image generation (https://research.google/blog/how-diffusion-controller-unifies-and-simplifies-ai-image-generation/ (새 창)) · 2026년 9월 29일 해설
Diffusion Controller: Framework, Algorithms and Parameterization (https://arxiv.org/abs/2603.06981 (새 창)) · 2026년 3월 7일 제출 · 논문 본문 (https://arxiv.org/html/2603.06981v1 (새 창))