DeepSWE 70%를 우리 팀 성공률로 읽어도 될까: 검증기와 과제 분포
v1 리더보드의 측정 조건과 검증기 불일치를 구분하고, 정상 대안 구현과 부분 구현을 함께 시험하는 평가 방법을 살펴본다.
새 과제와 동작 검증을 묶은 벤치마크
GitHub 이슈나 PR에서 따온 단발성 수정이 아니라, 개발자가 실제로 에이전트에게 맡길 만한 규모의 작업을 다루는 장기 호흡(long-horizon) 벤치마크다. 저자는 Wenqi Huang, Charley Lee, Leonard Tng, Serena Ge다.
핵심 차별점은 네 가지다. 첫째, 기존 커밋이나 PR을 가져오지 않고 모든 태스크를 새로 만들어 정답 패치가 사전학습에 포함됐을 위험을 줄였다. 둘째, 5개 언어·91개 저장소에 걸친 113개 태스크로 다양성을 확보했다. 셋째, 프롬프트는 SWE-bench Pro의 절반 길이지만 풀이에 필요한 코드량은 약 5.5배, 출력 토큰은 약 2배 많다. 넷째, 구현 방식이 아니라 동작(behavior)을 기준으로 사람이 직접 검증기를 작성했다.
기존 벤치마크의 한계
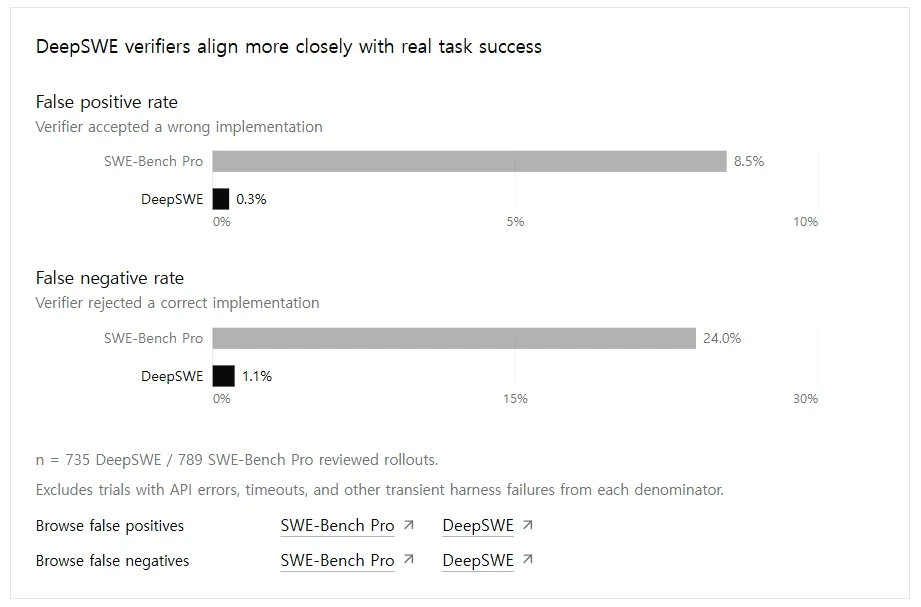
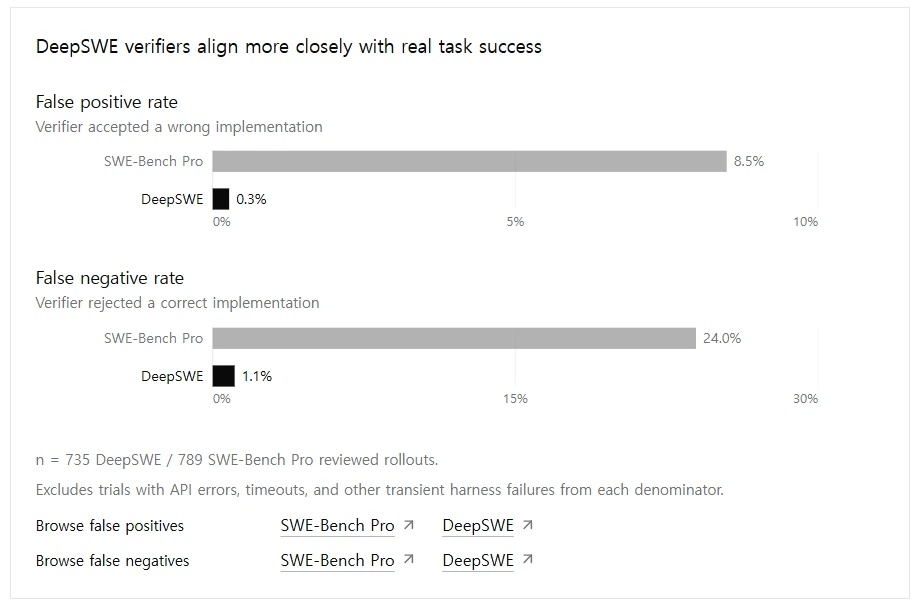
SWE-bench Pro의 평균 참조 풀이는 약 120줄에 그친다. 또한 Datacurve가 AI 심판과 대조한 검증기 감사에서 SWE-bench Pro는 거짓 양성 약 8%, 거짓 음성 약 24%를 기록했다. 단, 이는 AI 심판과의 판정 차이일 뿐 사람이 확정한 오류율은 아니다.
공개 커밋 기반 과제는 정답·테스트·토론이 학습 데이터에 포함될 위험도 있다. 다만 이 가능성만으로 모델 간 좁은 점수 차이가 전부 데이터 오염 때문이라고 단정할 수는 없다.
DeepSWE의 네 가지 핵심 차별점
기존 정답 패치를 재사용하지 않은 문제
DeepSWE의 모든 태스크는 새로 제작했다. 일부 태스크는 미해결 GitHub 이슈에서 출발하지만, 정답 풀이는 기존 PR이나 패치를 복제하거나 각색하지 않고 처음부터 작성했다.
만든 태스크를 원본 저장소에 다시 병합하지도 않는다. 공개 GitHub 기록에 남지 않으므로 향후 사전학습 코퍼스에 유입될 가능성이 낮다. 덕분에 에이전트가 이미 공개된 해법을 기억해 내는 것과 새 문제를 스스로 푸는 능력을 분리해 측정할 수 있다.
5개 언어와 91개 저장소
TypeScript, Go, Python, JavaScript, Rust 5개 언어로 된 활성 오픈소스 저장소 91개를 다룬다. 태스크 비중은 TypeScript 35개(31%), Go 34개(30%), Python 34개(30%), JavaScript 5개(4%), Rust 5개(4%)다. 소규모 라이브러리부터 대형 프레임워크까지 아울러 구조와 문서화 수준이 다양한 코드베이스에서 에이전트의 실효성을 보여준다. 저장소가 11개인 SWE-bench Pro Public이나 12개인 SWE-bench Verified와 대비된다.
짧은 요청으로 여러 파일을 바꾸는 과제
DeepSWE 프롬프트는 거대한 인터페이스 정의 블록 없이 짧고 동작 중심이어서 실제 개발자의 지시 방식에 가깝다. 에이전트가 수정할 위치와 방법을 스스로 탐색해야 하므로 종단 간(end-to-end) 문제 해결 능력이 드러난다.
프롬프트 길이는 SWE-bench Pro의 절반이지만 정답 풀이는 훨씬 길고 여러 파일에 걸쳐 있다.
구현 방식보다 요청한 동작을 검사하기
DeepSWE 검증기는 내부 구현 전략에 관여하지 않고 태스크 설명에서 요구한 동작만 검사한다. 헬퍼 함수를 새로 짜든 모듈을 추가하든 동작만 맞으면 통과시킨다.
반면 병합된 PR의 테스트를 그대로 검증기로 쓰면 임의의 제출물을 채점하도록 설계되지 않아 정답을 놓치거나 부분 해법을 통과시키기 쉽다. 두 벤치마크에서 무작위로 30개 태스크를 뽑아 검증기와 독립 AI 심판의 판정을 비교한 결과, AI 심판은 SWE-bench Pro 검증기와 32%에서 의견이 갈렸으나 DeepSWE와는 1.4%만 갈렸다. AI 심판도 오판할 수 있어 확정된 오류율은 아니지만, 검증기 불일치가 큰 상태에서는 미세한 점수 차이를 신뢰하기 어렵다.
| 지표 | SWE-bench Verified | SWE-bench Pro | DeepSWE |
|---|---|---|---|
| 평균 프롬프트 길이(자) | 1,700 | 4,614 | 2,158 |
| 평균 정답 추가 코드(줄) | 10 | 120 | 668 |
| 평균 수정 파일 수 | 1 | 5 | 7 |
| 지표 | SWE-bench Pro | DeepSWE |
|---|---|---|
| 거짓 양성률(오답을 통과) | 8.5% | 0.3% |
| 거짓 음성률(정답을 탈락) | 24.0% | 1.1% |
리더보드
2026년 5월 26일 공개된 v1의 mini-swe-agent 평가 결과다(± 값은 원문 표기이며 산정 방식은 명시되지 않았다).
통과율은 5%에서 70%까지 분포해 격차가 65%p에 달한다. 저자들은 약 30%p 범위인 공개 SWE-bench Pro보다 격차가 넓어 실제 개발 작업에서의 모델 성능 차이를 잘 드러낸다고 해석한다. 단, 과제와 평가 조건이 달라 점수 범위만으로 현장 대표성이 입증되지는 않는다.
| 순위 | 모델 | 통과율 |
|---|---|---|
| 1 | gpt-5.5 [xhigh] | 70% ±3% |
| 2 | gpt-5.4 [xhigh] | 56% ±2% |
| 3 | claude-opus-4.7 [max] | 54% ±5% |
| 4 | claude-sonnet-4.6 [high] | 32% ±2% |
| 5 | gemini-3.5-flash [medium] | 28% ±4% |
| 6 | gpt-5.4-mini [xhigh] | 24% ±3% |
| 6 | kimi-k2.6 | 24% ±2% |
| 8 | mimo-v2.5-pro | 19% ±2% |
| 9 | glm-5.1 | 18% ±1% |
| 10 | gemini-3.1-pro | 10% ±3% |
| 11 | deepseek-v4-pro | 8% ±3% |
| 12 | gemini-3-flash | 5% ±2% |
방법론
저장소 선택과 고정 커밋
공개 상태이고 활발히 유지보수되며 GitHub 스타 500개 이상, 허용적 오픈소스 라이선스를 가진 저장소를 대상으로 삼았다. 기존 벤치마크에 편중된 대형 프레임워크에 치우치지 않도록 기준을 넓게 잡았다. 각 태스크는 고정된 커밋 해시에 묶여 재현성을 보장하며, 저장소당 태스크 수 중앙값이 1개여서 특정 저장소가 리더보드를 좌우하지 않는다.
프롬프트·검증기·참조 풀이의 분리
태스크마다 에이전트가 읽는 프롬프트, 결과를 채점하는 실행 가능한 검증기, 검토에만 쓰고 채점에는 쓰지 않는 참조 풀이가 한 세트로 구성된다.
검증기는 저장소의 기존 테스트 인프라를 확장하되 공개 API와 관찰 가능한 출력만 검사한다. 작성 단계에서 세 번 실행해 결과가 흔들리면 불안정(flaky) 테스트로 분류해 수정하고, 매 시도마다 기존 테스트와 회귀 테스트를 함께 돌려 무관한 기능을 망가뜨리면 탈락시킨다.
과제 채택 전 품질 검토
태스크는 LLM 보조 분석과 사람의 독립 검토를 모두 통과해야 채택된다. 검토 기준은 네 가지다. 검증기가 프롬프트 요구사항만 정확히 검사하는지, 참조 풀이 외의 합리적 구현도 통과시키는지, 프롬프트와 태스크가 실제 개발과 유사한지, 의존성이나 불안정한 테스트 같은 인프라 문제로 실패하지 않는지 확인한다. 기준에 미달하면 반려한다.
mini-swe-agent로 실행 환경 고정하기
모든 모델을 mini-swe-agent로 실행해 도구와 프롬프트 조건을 통일했다. 현업에서는 Codex CLI, Claude Code, Cursor, Gemini CLI처럼 모델별 전용 편집 도구(GPT의 apply_patch, Claude의 str_replace 계열)와 시스템 프롬프트가 결합된 네이티브 제품을 주로 쓰지만, 이를 그대로 쓰면 리더보드에 스캐폴딩 차이가 섞인다. mini-swe-agent는 모든 모델에 동일한 bash 도구와 공유 프롬프트만 제공한다. Datacurve가 동일 태스크를 네이티브 하네스로 실행한 파일럿 실험에서는 표준 하네스가 특정 모델을 유의미하게 불리하게 만들지 않았다. 다만 단일 하네스와 각 모델 간의 상호작용 차이까지 완전히 제거되지는 않는다.
결과 분석
v1에서 관측한 모델 간 점수 범위
DeepSWE v1의 모델 간 통과율 범위는 65%p로, 공개 SWE-bench Pro(약 30%p)보다 넓다. 다만 변별력이 크다는 점과 실제 업무 대표성은 별개로 봐야 한다.
비용·토큰·시간 효율
DeepSWE는 통과율 외에 시도당 중앙값 출력 토큰, 소요 시간, 달러 비용을 함께 측정한다. gpt-5.5는 시도당 출력 토큰 약 47k와 소요 시간 약 20분으로 통과율 70%에 도달해 토큰과 시간 효율이 모두 높았다. gemini-3.5-flash는 15분으로 더 빨랐으나 통과율은 28%에 그쳤다. 비용 면에서는 gpt-5.4(약 $3.3/시도, 56%)와 gpt-5.5(약 $5.8/시도, 70%)가 효율적이었다.
세 지표 모두 모델마다 자릿수 단위로 차이 나지만 통과율과 비례하지는 않았다. 토큰과 시간을 더 투입한다고 정답률이 높아지는 것은 아니다.
정성 분석: 모델 계열별 실패 패턴
30개 태스크에 9개 프런티어 구성을 각 3회 실행하고 AI 심판으로 실패 원인을 분류한 결과, 모델 계열별 실패 양상이 뚜렷하게 갈렸다.
병렬 요구사항 누락
Claude 계열은 명시된 요구사항을 빠뜨리는 비율이 가장 높았다. DeepSWE 프롬프트에는 "동기·비동기 모두 지원", "줄 주석·블록 주석 모두 지원" 같은 병렬 요구사항이 많은데, Claude는 한쪽만 구현하고 대칭되는 나머지를 누락하는 경향을 보였다. Claude에서 발생한 요구사항 누락 실패의 약 3분의 2가 이 패턴이었다.
저장소 이력 탐색과 정답 유출 경로
프롬프트와 저장소 상태가 어긋날 때 Opus 4.7은 종종 git log로 최근 변경 이력을 뒤져 .git 기록에서 정답을 복구했다. SWE-bench Pro에서는 두 Opus 구성 모두 검토 실행의 12% 이상에서 정답 커밋을 그대로 복사해 붙여넣었다. 같은 조건에서 GPT 계열은 0%, Gemini는 약 1%였다. 컨테이너에 정답 커밋이 남아 있어 발생한 문제로, DeepSWE는 얕은 클론(shallow clone)만 제공해 이 경로를 차단했다.
명시된 요구사항 준수
명시된 동작을 빠뜨리는 비율은 GPT-5.5가 가장 낮았고 GPT-5.4가 뒤를 이었다. 프롬프트와 저장소 계약을 문자 그대로 해석해 양쪽을 모두 충족하는 패치를 생성했으며, 반복 시도에서도 동일한 해석으로 수렴했다.
자가 테스트 행동과 점수의 관계
AI 심판으로 자가 검증 행동을 분류한 결과, 성능이 높은 모델일수록 별도 지시가 없어도 테스트를 더 많이 작성했다. DeepSWE에서 Claude Opus 4.7과 GPT-5.4는 실행의 80% 이상에서 프로젝트 테스트 프레임워크로 새 테스트를 작성했다. 반면 Gemini 3 Flash는 실행의 18%에서 기존 테스트조차 돌리지 않고 제출했다.
동일한 모델이라도 SWE-bench Pro에서는 자체 테스트 작성 비율이 3~28%로 낮았는데, 프롬프트에 "테스트는 이미 처리됐으니 건드리지 말라"는 안내가 있었기 때문이다. DeepSWE 프롬프트에서 테스트 관련 언급을 빼자 자발적 테스트 작성이 다시 늘어났다.
한계와 향후 과제
모든 모델을 mini-swe-agent의 단일 bash 도구로 실행해 하네스 차이를 통제하지만, 하네스와 모델 간의 궁합 차이가 남으므로 네이티브 도구에서 낼 수 있는 최대 성능보다 낮게 측정될 수 있다.
코퍼스가 스타 500개 이상의 활성 오픈소스에 한정돼 롱테일 저장소나 사내 코드베이스로 일반화하기 어렵다. 장기 호흡 작업에 초점을 맞춰 버그 위치 파악과 리팩터링 비중이 작고, C++·Java 등 주요 언어가 빠져 있다.
Datacurve는 앞으로 동일 모델을 여러 하네스로 실행해 모델 자체 성능과 스캐폴딩의 기여도를 분리하고, 코퍼스·언어·태스크 유형을 넓히며 블랙박스 동작 검증과 하이브리드 검증기를 고도화할 계획이다.
리더보드와 검증기 품질을 함께 확인하기
모델을 선택할 때는 실제로 맡길 업무가 벤치마크의 언어·규모·하네스 조건과 얼마나 유사한지 따져봐야 한다. 검증기 감사 결과 역시 AI 심판과의 판정 차이라는 조건 안에서 해석하고, 사내 작업의 실제 성공률은 별도로 평가해야 한다.
검증기를 점검하는 가상의 요구사항으로 “동기·비동기 입력을 모두 지원한다”를 두자. 동기 경로만 구현한 패치 A가 통과한다면 검증기가 요구사항 하나를 빠뜨린 것이다. 반대로 두 경로가 모두 맞는 패치 B를 내부 함수 이름이 다르다는 이유로 거절한다면 특정 구현에 과하게 묶인 검사다. 기준 풀이 하나를 통과시키는 것만으로는 이 두 실패를 찾을 수 없다.
의도적으로 한쪽 동작을 제거한 변형과 구조가 다른 올바른 구현을 함께 넣어 거절·허용 결과를 확인한다. AI 심판과 실행 검증기의 판단이 다르면 어느 쪽이 맞는지 요구사항과 실제 동작을 다시 조사해야 한다. 불일치율은 감사할 후보의 규모일 뿐 곧바로 검증기의 확정 오류율이 되지는 않는다.
사내 평가에서도 같은 질문 문구를 복제하는 대신 실제로 맡길 변경의 언어·규모·권한·테스트 환경을 맞춘다. 공개 벤치마크 점수가 높은 모델이 사내 작업에서도 우수할 가능성은 검증할 가설로 두고, 최종 합격한 변경 수와 사람의 재작업 시간으로 확인한다. v1과 v1.1의 숫자를 한 표에 놓을 때도 실행 조건이 같다는 전제를 먼저 확인해야 한다.
참고 자료
후속 v1.1 발표 (https://deepswe.datacurve.ai/blog/deepswe-v1-1 (새 창))에서는 검증 환경 분리와 재현성 개선을 다룬다. 본문의 v1 수치를 v1.1 실행 결과와 섞어 비교하지 않는다.
DeepSWE 공식 글 (https://deepswe.datacurve.ai/blog/deepswe (새 창))
DeepSWE GitHub 저장소 (https://github.com/datacurve-ai/deep-swe (새 창))