임베딩을 보냈는데 이미지를 왜 또 처리할까: vLLM EPD의 메타데이터 전달
인코더를 분리해도 소비자의 이미지 전처리는 남을 수 있다. 임베딩과 배치 정보의 전달 경로를 따라가며 중복 처리의 비용과 원본 없는 복구의 한계를 설명한다.
임베딩과 입력의 배치는 서로 다른 정보다
이미지를 벡터로 바꾸는 서버를 따로 두었는데도, 답변을 만드는 서버에서 같은 이미지를 다시 처리한다. 인코더 분리가 실패한 것일까? 임베딩을 재사용하더라도 그 임베딩이 프롬프트의 어느 자리에 들어갈지 알아내는 작업은 남을 수 있다.
vLLM의 2026년 11월 11일 EPD 설명 (새 창)과 구현 PR을 바탕으로 이미지 한 장이 전달되는 과정을 따라가 본다. 아래의 요청과 시간 계산은 이해를 돕기 위한 가상 예시이며, 실제 GPU 서버에서 직접 측정한 결과는 아니다. 다룰 범위는 인코더 출력과 입력 배치 정보를 함께 넘기는 방식이다.
이미지 벡터를 보내는 구간과 KV를 보내는 구간
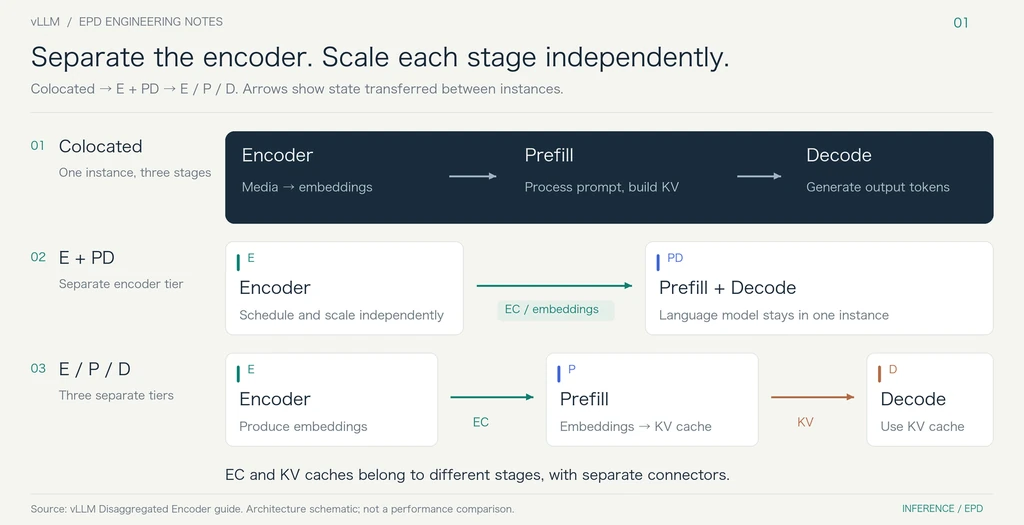
사용자가 이미지 A와 “이 장면을 설명해 줘”라는 문장을 보냈다고 하자. Encoder(E)는 이미지를 전처리해 임베딩을 만든다. Prefill(P)은 문장과 임베딩을 읽고 생성에 쓸 KV 상태를 만든다. Decode(D)는 그 상태를 바탕으로 답변 토큰을 생성한다. 분리 인코더 문서 (새 창)에서 E+PD는 인코더만 따로 떼어낸 구성이고, E/P/D는 세 단계를 모두 분리한 구성이다.
아래 그림에서 가운데 초록 화살표는 이미지 임베딩을 전달하는 구간이고, 맨 아래 주황 화살표는 P가 만든 KV를 전달하는 구간이다. 두 화살표가 실어 나르는 대상은 서로 다르다. 이 글에서 다루는 문제는 앞쪽 초록 구간에서 생긴다. 이미지 A의 벡터가 도착했다는 사실만으로는 소비자 P/PD가 텍스트 사이에 이미지 토큰을 어떻게 배치할지 알 수 없다.
그림 출처: vLLM 공식 EPD 설명 (새 창).
픽셀에서 다시 찾던 배치 정보를 인코더가 돌려준다
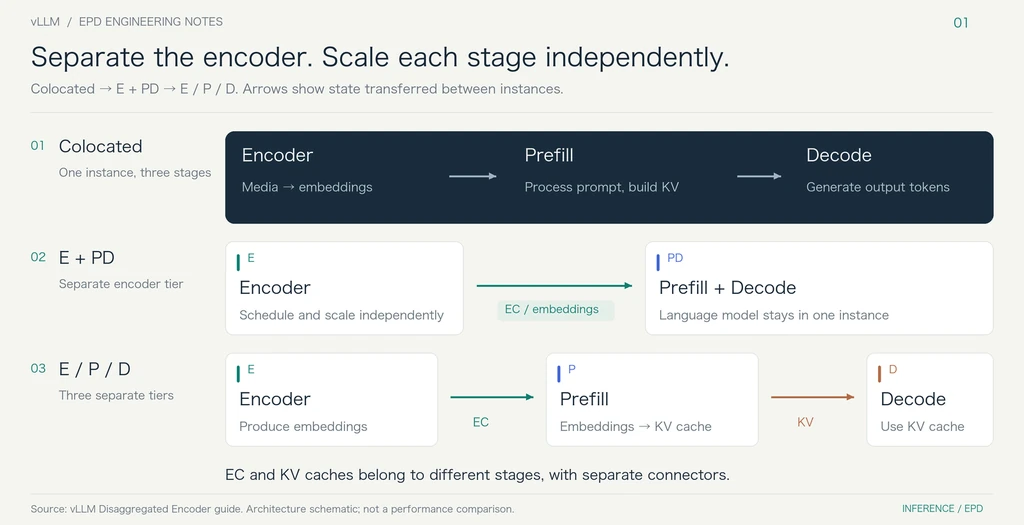
이미지 전처리 중복 제거 PR (새 창)은 이 차이를 구체적으로 보여 준다. E가 이미지 A를 처리하면서 패치 격자 정보를 이미 계산했더라도, 원본 이미지가 P/PD에 그대로 넘어가면 소비자는 배치를 복원하려고 픽셀을 다시 전처리할 수 있다. 물론 원격 임베딩이 이미 있으므로 인코더 순전파까지 반드시 두 번 실행하는 것은 아니다.
메타데이터만 전달하는 경로에서는 E가 계산한 격자와 입력 식별 정보를 라우터로 돌려준다. 라우터는 요청에 담긴 이미지 항목을 메타데이터 참조로 바꾼다. 문장과 생성 설정은 그대로 두고, 실제 임베딩은 EC connector라는 별도 통로로 보낸다. Qwen 계열의 image_grid_thw가 이런 입력 배치 정보의 한 예다. 소비자는 이 정보로 이미지가 들어갈 placeholder 구간을 만들고, 따로 받은 임베딩을 여기에 연결한다.
공식 전달 경로 그림 (새 창)의 위쪽 A와 아래쪽 B에는 모두 파란 임베딩 화살표가 있다. B에 추가된 초록 점선은 임베딩을 대체하는 벡터가 아니라 배치 정보를 돌려주는 경로다. 따라서 메타데이터만 보낸다는 말은 이미지 벡터를 보내지 않는다는 뜻이 아니다. 그림의 화살표는 논리적 흐름을 나타낼 뿐, 처리 시간표는 아니다.
전처리를 없앤 만큼 전체 응답이 빨라지지는 않는다
가상 요청 A에서 소비자의 중복 전처리에 20ms, 메타데이터 해석에 2ms가 걸린다고 하자. 두 비용이 다른 처리와 겹치지 않고 전체 경로가 원래 100ms였다면, 방식을 바꾼 뒤에는 100−20+2=82ms가 되어 18ms가 줄어든다. 전체 응답이 열 배 빨라지는 것은 아니다. 반대로 그 20ms가 원격 임베딩을 기다리는 시간에 전부 가려져 있었다면, CPU 사용량은 줄어들지언정 응답 완료 시각은 거의 그대로일 수 있다. 이는 단순한 시간의 합과 임계 경로를 구분해 계산한 결과다.
PR의 이미지 실험 (새 창)에서도 메타데이터 전달과 GPU 전처리는 별개의 변경 사항으로 두고 비교했다. 전자는 소비자의 중복 처리를 없애고, 후자는 E에 남아 있는 처리를 가속한다. 두 기능을 동시에 켠 결과를 모두 인코더 분리의 효과로 해석하면 실제로 어떤 비용이 줄었는지 놓치게 된다.
운영 환경에서는 같은 이미지·모델·동시 요청 수 조건을 기준으로 원본 전달과 메타데이터 전달을 비교한다. 이미지 전처리 캐시가 이미 적중하는 경우도 따로 떼어 살펴보는 편이 좋다. 이 경우에는 제거할 중복 비용 자체가 작기 때문이다. E 계산, 요청 변환, 임베딩 전송, P/PD 대기를 나눠 보아야 다음에 늘릴 자원을 판단할 수 있다.
원본을 보내지 않으면 복구에 쓸 픽셀도 없다
요청 A의 배치 정보는 도착했지만 원격 임베딩 전송이 실패했다고 하자. P/PD가 원본 이미지를 가지고 있고 로컬 인코딩을 지원한다면 직접 다시 계산할 여지가 있다. 반면 메타데이터만 받은 소비자는 같은 방식으로 복구할 수 없다. 격자 크기는 이미지의 내용이 아니므로 누락된 벡터를 복원하지 못한다.
실패 격리 PR (새 창)은 실제 모델 입력이 있으면 로컬 복구를 유지하고, 없으면 해당 요청을 unavailable로 보고하도록 구분한다. 무리하게 로컬 인코딩을 시도하다가 assertion이 발생해 EngineCore 전체가 종료되는 상황을 막는 수정이다. PR은 정상 부하 실험에서 과거의 충돌이 재현되지 않았다고 명시한다. 하지만 정상 요청이 모두 성공했다는 사실이 장애 주입 검증을 대신할 수는 없다.
따라서 메타데이터 전달을 도입할 때는 정상 답변 비교와 더불어 “배치 정보만 도착하고 임베딩은 끝내 오지 않는 요청”을 별도로 검증할 필요가 있다. 이는 여기서 직접 실행한 시험이 아니라 앞서 살펴본 실패 조건에서 도출한 검증 제안이다. 중복 처리를 줄이는 선택은 전송에 실패했을 때 소비자가 쥐고 있는 정보까지 바꾼다. 속도와 복구를 함께 설계해야 하는 이유가 바로 여기에 있다.