ORL은 어떤 중간 상태로 학습할까: 잔여 임베딩과 엔트로피 수축 계산
ORL의 잔여 입력을 작은 벡터로 계산하고, 엔트로피 수축 손실과 미확정 위치 평균의 함정을 짚는다. 순전파 감소가 실제 속도로 이어지는 조건도 구분한다.
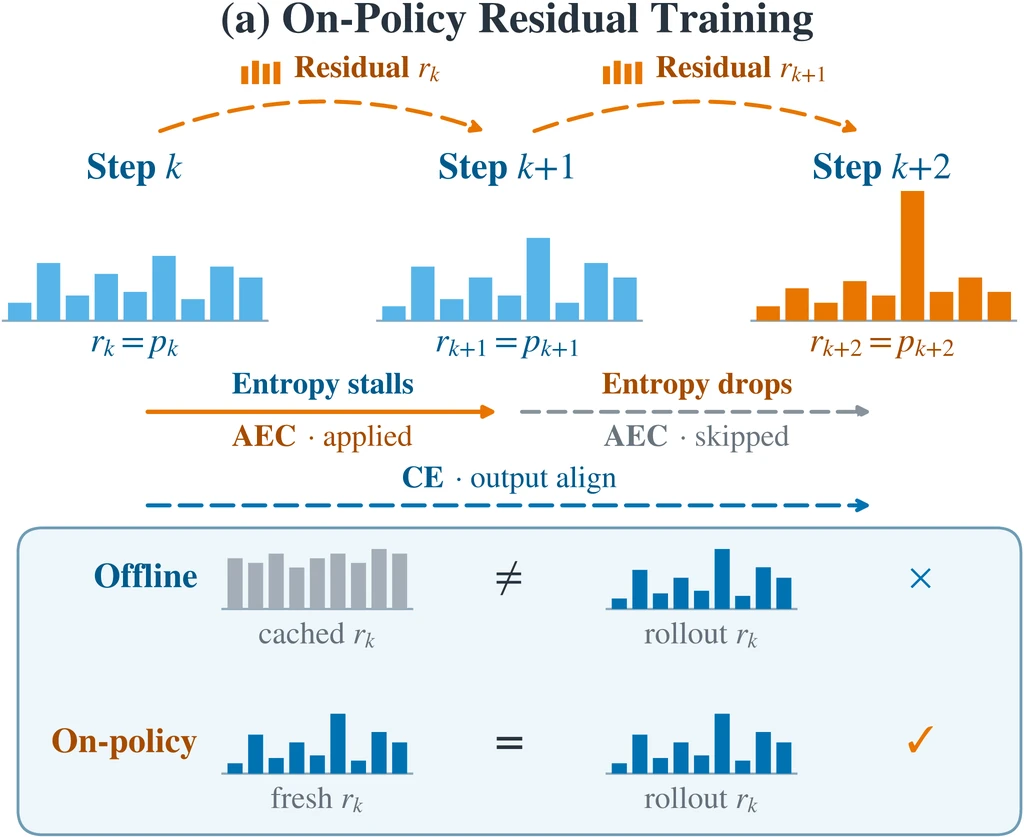
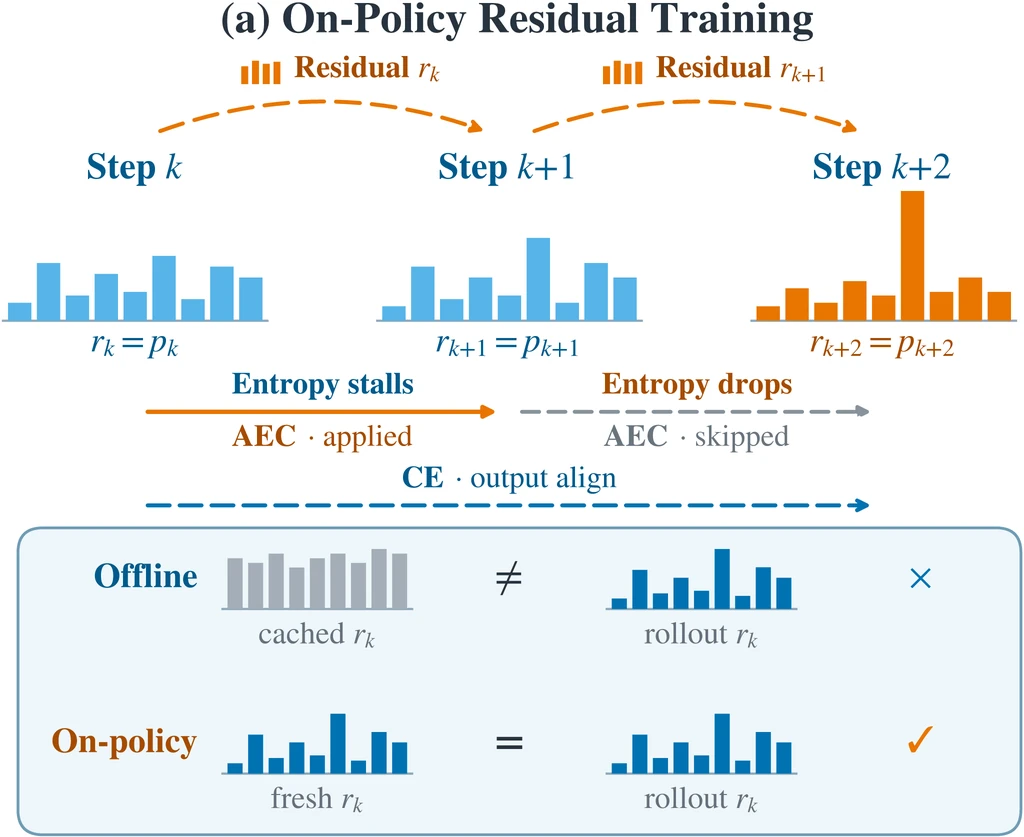
가려진 토큰 배열이 같더라도 확산 언어 모델이 받는 입력은 다를 수 있다. 이전 단계에서 A를 유력하게 봤는지, B를 거의 확신했는지가 다음 단계에 연속적인 잔여 입력으로 전달되기 때문이다. 토큰 화면만 저장하면 실제 계산 조건의 일부를 잃게 된다.
ORL이 보존하는 상태와 엔트로피 수축 목표를 작은 벡터·손실 계산으로 따라가 보자. 여기 쓰인 수치는 설명을 위한 가정이며, 모델 학습이나 추론 벤치마크를 실행한 결과는 아니다.
같은 마스크에 다른 확률을 더하면 입력이 달라진다
ORL 방법 (새 창)은 이전 예측 분포로 토큰 임베딩의 가중 평균을 구하고, 어댑터를 거쳐 현재 토큰 입력에 더한다. 따라서 마스크 배열과 실제로 받은 잔여 입력을 함께 알아야 상태를 구별할 수 있다.
가상 어휘가 A와 B뿐이고 임베딩이 A=(1,0), B=(0,2)라고 하자. 이전 분포가 (0.5,0.5)이면 평균 임베딩 z는 (0.5,1)이고, 분포가 (0.1,0.9)이면 z는 (0.1,1.8)이다. 현재 위치가 똑같이 마스크여도 더해지는 정보는 달라진다. 설명을 위해 어댑터를 항등 함수로, 주입 강도를 1로 두면 이 차이가 입력에 그대로 나타난다.
실제 모델은 학습된 어댑터와 모델별 정렬을 사용하므로, 이 두 차원 예제가 실제 구현을 그대로 재현하지는 않는다. 다만 토큰 배열만으로 상태가 정해지지 않는 이유는 잘 보여 준다. 현재 모델이 달라지면 이 분포도 바뀌고, 뒤이어 확정되는 위치와 다음 상태도 달라질 수 있다.
현재 경로를 한 번 재평가하고 다음 경로를 새로 만든다
ORL은 현재 모델이 만든 경로 중 검증을 통과한 출력의 상태를 학습에 사용한다. 토큰 배열과 어댑터 이전의 잔여 입력을 보존해 같은 모델에서 재평가하고, 한 번 갱신한 뒤 경로를 버린다. 여기서 exact는 포착한 입력을 그대로 보존한다는 뜻이지, 재평가 출력이 비트 단위까지 동일하다는 의미는 아니다.
가상으로 이전 체크포인트가 같은 위치에 A 확률 0.8을 주고, 새 체크포인트는 0.2를 준다고 하자. 토큰 배열이 같다는 이유로 이전 잔여를 재사용하면, 새 모델이 실제 생성 중에 받았을 조건과 다른 입력으로 훈련하게 될 수 있다. 오래된 경로를 여러 번 재사용하면 데이터 활용도는 높아지지만, 현재 정책과의 어긋남도 함께 커질 수 있다.
원문에서는 어휘 전체 분포 대신 평균 임베딩 z를 저장하고, 이전 생성 단계로는 역전파하지 않는다고 설명한다. 가상 어휘 크기 100,000과 임베딩 차원 2,000을 같은 정밀도로 비교하면 한 위치에 저장할 원소 수는 50배 차이 난다. 이는 잔여 배열만 두고 계산한 산술이며, 캔버스·통계·전송 버퍼를 포함한 전체 메모리 절감률은 아니다.
엔트로피가 충분히 줄면 추가 벌점을 주지 않는다
인접 엔트로피 수축(AEC)의 한 쌍 손실은 max(0, 다음 엔트로피−(1−ρ)×이전 엔트로피)의 제곱이다. 여기서 ρ는 요구하는 감소 비율이다. 모든 분포를 무조건 더 뾰족하게 만드는 대신, 정해진 감소 폭에 미치지 못한 단계에만 벌점을 준다.
가상으로 이전 정규화 엔트로피가 0.8이고 ρ=0.25라면 목표 상한은 0.6이다. 다음 값이 0.7이면 손실은 (0.7−0.6)²=0.01이고, 0.5이면 0이다. 이때 계산의 단위와 정규화는 같은 기준을 따라야 한다. 확신이 이미 충분히 커졌을 때 엔트로피를 더 낮추라고 계속 압박하지 않는 경계가 생기는 셈이다.
그러나 확신이 곧 정답 판정은 아니다. 이진 분포 (0.5,0.5)의 엔트로피는 1비트지만 (0,1)은 0비트다. 정답이 A라면 후자는 확신에 찬 오답이다. 아래 표처럼 엔트로피 감소만으로는 품질을 보장할 수 없으므로, 검증된 출력에 대한 지도와는 별도로 해석한다.
| 예측 분포 | 불확실성과 정답 |
|---|---|
| A 50% · B 50% | 퍼져 있으나 미확정 |
| A 0% · B 100% | 엔트로피 0 · 확신한 오답 |
미확정 위치의 평균은 구성원이 바뀌는 평균이다
AEC에서 각 단계의 엔트로피는 그 단계에 아직 미확정으로 남은 위치들의 평균으로 구한다. 가상으로 두 위치의 엔트로피가 0.2와 0.8이면 평균은 0.5다. 이후 값이 낮았던 위치가 확정되어 빠지고 나머지 위치가 0.7로 개선되더라도 새 평균은 0.7이 된다. 개별 미확정 위치는 나아졌는데도 평균은 오히려 올라가는 것이다.
반대로 높은 값의 위치가 집합에서 빠지면 나머지가 그대로여도 평균은 낮아질 수 있다. 따라서 같은 위치를 짝지은 변화, 확정된 위치의 정오, 남은 위치 수를 함께 살펴보면 평균만으로는 놓치기 쉬운 구성을 파악할 수 있다. 이 가상 예제는 논문에서 실제로 관찰한 수치가 아니라 지표를 해석할 때 유의할 경계를 보여 준다.
검증된 출력만 남기는 학습에서는 어떤 질문의 경로가 버려졌는지도 기록할 필요가 있다. 쉬운 질문의 성공 경로가 많고 어려운 질문은 거의 남지 않는다면, 수집한 토큰 수만으로 학습 범위를 설명할 수 없다. 잘못된 출력을 검증기가 통과시키는 경우도 별도의 오류 원인이 된다.
순전파당 토큰이 늘어도 초당 토큰은 따로 계산한다
추론 절 (새 창)에서는 순전파 횟수 감소와 실제 속도를 구분한다. TPF는 노이즈 제거 순전파당 완료 토큰 수이며 초당 토큰 수가 아니다. 잔여 계산, 입력 문맥 처리, 블록 캐시 기록 같은 비용도 여전히 남는다.
가상으로 100토큰을 20회 순전파로 만들면 TPF는 5다. 이를 10회로 줄이면 TPF는 10이 되지만, 회당 비용이 10ms에서 15ms로 늘고 고정 비용이 100ms라면 총시간은 300ms에서 250ms가 된다. TPF는 두 배가 되었지만 전체 속도는 1.2배에 그친다. 여기에는 품질과 출력 길이가 같다는 가정도 필요하다.
ORL을 읽을 때는 어떤 잔여 입력을 학습했는지, 확신이 정답과 함께 개선됐는지, 줄어든 단계가 실제 시간 단축으로 이어졌는지를 차례로 연결해 본다. 같은 토큰 배열이나 낮은 엔트로피, 큰 TPF 중 어느 하나만으로 그 연결을 대신할 수는 없다.