Maia 300의 7배는 어디서 나오나: 랙 처리량과 요청 지연의 계산
Maia 300의 랙 처리량과 전력 효율 주장을 요청 지연으로 바로 바꿀 수 없는 이유를 계산한다. 가속기 수, 배치 크기, 품질·지연 기준을 통과한 작업량을 나눠 비교한다.
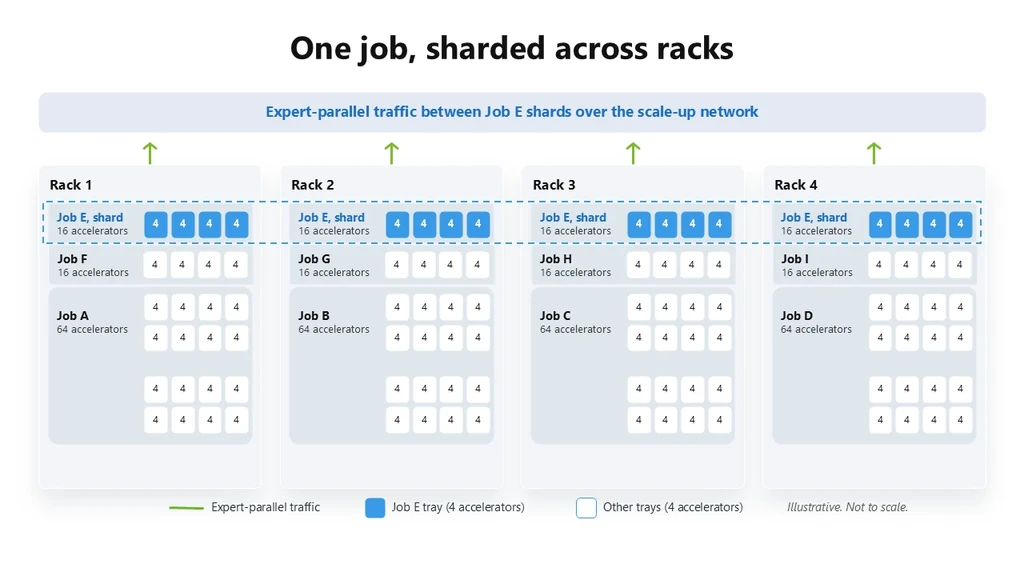
Maia 300의 토큰 처리량이 최대 7배라는 수치는 랙 전체를 기준으로 한 값이다. 개별 요청의 응답 속도나 API 요금이 같은 비율로 개선된다는 뜻은 아니다. 도입을 검토할 때는 비교 대상 시스템의 규모부터 맞추고, 사용자가 기다리는 시간과 전력당 처리량을 따로 확인해야 한다.
아래 수치 예제는 원리를 설명하기 위한 가정일 뿐, 해당 모델의 학습이나 하드웨어 성능을 직접 실험한 결과는 아니다.
7배와 40%는 비교 대상부터 다르다
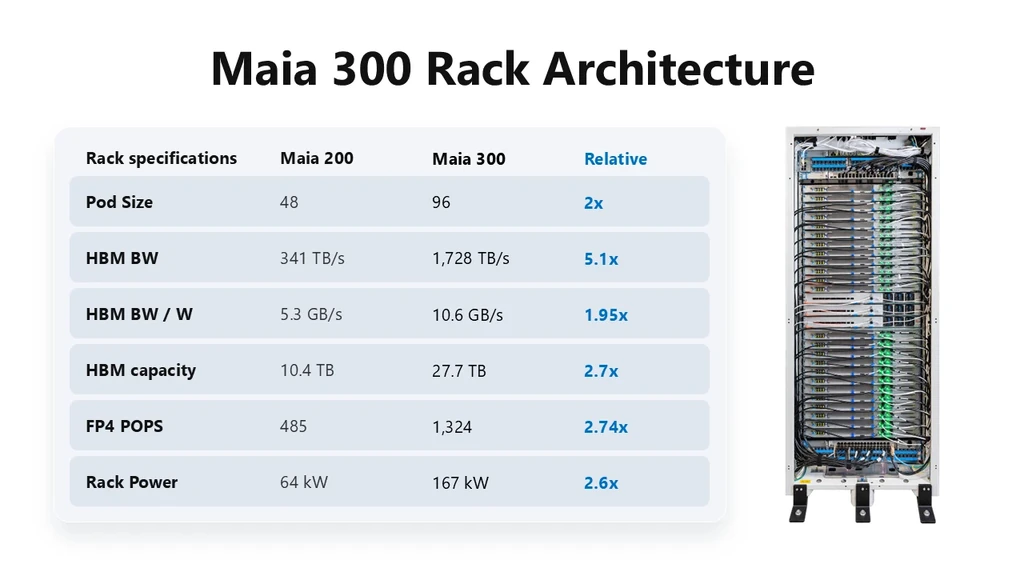
Microsoft는 2026년 10월 12일 Maia 300을 발표했다. 공식 발표 (새 창)에서는 가속기 96개로 구성한 랙의 토큰 처리량이 Maia 200 대비 최대 7배이며, 전력당 토큰은 선도 GPU 기반 시스템보다 40% 더 높을 것으로 예상한다. 앞의 수치는 이전 세대 랙과, 뒤의 수치는 GPU 시스템과 비교한 값이므로 두 숫자를 같은 기준으로 읽으면 안 된다.
발표 내용은 현재 운영 작업을 처리 중인 Maia 200과 2027년에 운영 배치를 시작할 Maia 300을 구분한다. 지금 선택할 수 있는 서비스 조건과 미래 시스템의 설계 목표는 나누어 봐야 하며, 발표 시점의 성능 주장만으로 도입 가능성이나 요금을 확정할 수 없다.
가속기가 두 배인 랙을 같은 크기로 볼 수 없다
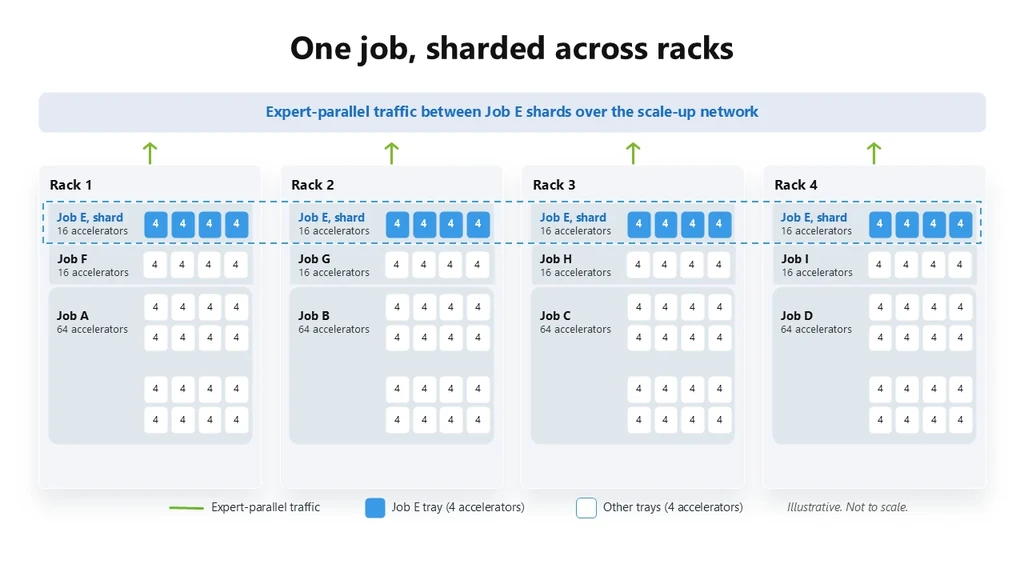
아키텍처 설명 (새 창)에 따르면 Maia 300 랙은 가속기 96개를 묶는 반면, Maia 200의 랙 밀도는 그 절반이다. 또한 데이터의 배치와 이동을 소프트웨어로 제어하는 SDLA를 확장하고, 메모리 대역폭과 저정밀 표현도 함께 개선한다. 연산 성능 한 항목만 바꾼 비교가 아니다.
단순히 7을 2로 나눠 칩 하나의 성능이 3.5배라고 단정하는 것도 부정확하다. 랙 처리량에는 모델을 분할 실행하는 방식, 통신, 메모리, 동시 처리 요청 수가 복합적으로 작용한다. 칩 단위로 비교하려면 같은 모델과 정밀도, 입력·출력 길이에서 각각 측정한 근거가 필요하다.
공식 문서의 최고 사양 표는 설계 차이를 설명할 뿐, 실제 서비스의 지연 분포나 품질까지 보여주지는 않는다.
가상으로 이전 랙이 초당 1,000토큰, 새 랙이 7,000토큰을 처리한다면 랙 처리량은 7배다. 이를 각각 가속기 48개와 96개로 단순 계산하면 가속기당 평균 기여량 비율은 3.5가 된다. 이 나눗셈은 시스템 평균을 정규화한 값일 뿐, 통신과 모델 배치를 분리해 측정한 단일 칩 벤치마크가 아니다.
토큰을 많이 내보내도 한 요청은 오래 기다릴 수 있다
처리량은 일정 시간 동안 시스템이 내보낸 총량이고, 응답 지연은 한 사용자의 요청이 들어온 뒤 결과를 받을 때까지 기다린 시간이다. 이 둘을 평가할 때는 요청을 묶어서 처리하는 조건을 함께 기록해야 한다. 사내 문서 질의 서비스에서 동시에 더 많은 요청을 묶어 처리하면 총 출력량은 늘어나도 개별 사용자는 다음 묶음 차례까지 기다릴 수 있다.
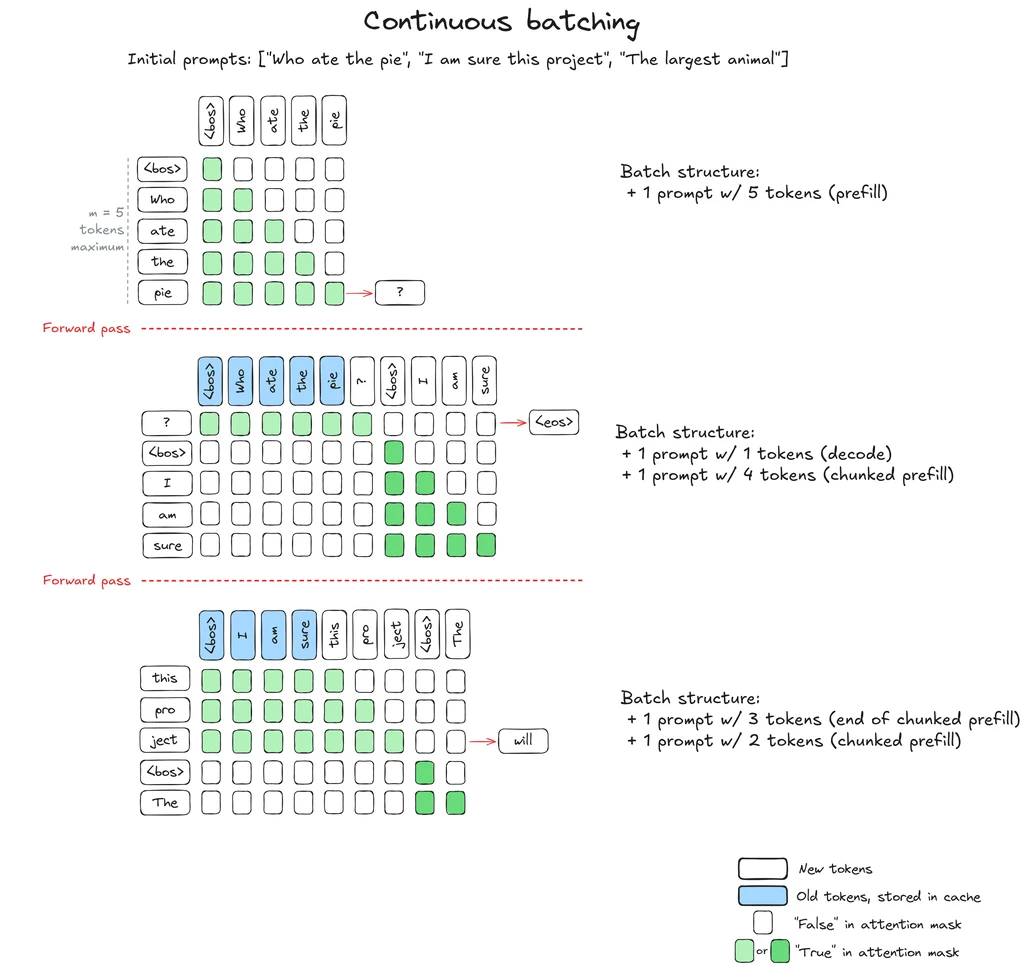
긴 문서를 먼저 처리하는 prefill 단계와 답변 토큰을 차례로 생성하는 decode 단계도 구분해야 한다. 첫 토큰이 나올 때까지 기다리는 시간과 이후 토큰이 생성되는 간격에서 서로 다른 병목이 드러날 수 있어, 랙 토큰 처리량만으로는 체감 속도를 판단하기 어렵다.
가상으로 요청 하나가 100토큰을 1초 동안 생성하면 초당 100토큰이다. 요청 10개를 묶어 처리해 각각 2초가 걸리면 시스템은 초당 500토큰을 내보내지만, 각 사용자가 체감하는 생성 시간은 두 배로 늘어난다. 처리량은 5배 좋아졌어도 지연은 오히려 나빠질 수 있다. 여기에 묶음 처리를 기다리는 대기 시간과 prefill 시간도 더해진다.
메모리 대역폭의 효과는 실행 단계에 따라 달라진다. 가중치를 다시 읽는 비용이 큰 작은 배치의 decode에서는 데이터 이동이 중요하고, 큰 배치로 가중치를 여러 요청에 재사용하면 연산이나 통신 비중이 더 커질 수 있다. 같은 하드웨어의 이론적 대역폭 증가율을 모든 요청의 속도 향상률로 그대로 치환할 수 없는 이유다.
같은 품질에서 제때 끝낸 요청을 비교하기
공개된 발표 자료만으로는 전체 성능 비교에 사용한 모델·정밀도·요청 분포·지연 한도를 확인할 수 없다. 도입을 검토할 때는 비교할 모델과 입력·출력 길이 분포를 고정한 뒤, 동시 요청 수를 바꿔 가며 측정해야 한다. 첫 토큰 지연과 전체 완료 시간은 평균뿐만 아니라 느린 요청의 비율도 함께 기록하고, 저정밀 실행을 비교할 때는 같은 질문에 대해 답변 품질이 유지되는지 먼저 확인한다.
전력 비교에도 측정 경계가 필요하다. 가속기만 따진 소비 전력과 랙·네트워크·냉각까지 포함한 소비 전력은 다른 값이다. 실무 지표로는 품질 기준과 응답 시간 한도를 모두 통과한 요청 수를 소비 에너지로 나눠 비교해야 한다. 실패한 출력까지 토큰 수에 포함하면 높은 처리량이 실제 업무 처리량을 과장할 수 있다.
전력 효율이 높아져도 고객 요금에는 계약 조건과 서비스 운영 비용이 반영된다. 모델 지원 범위와 배포 조건이 불분명한 단계에서는 기존 서비스의 병목을 먼저 측정해 두고 전환은 보류하는 편이 안전하다.
전력당 처리량이 40% 높다는 가정을 고정하면, 같은 토큰 수를 처리하는 데 필요한 에너지는 1/1.4=약 71.4%가 된다. 에너지 감소율은 약 28.6%로, 40%와는 다르다. 이는 동일한 품질과 측정 경계를 가정한 역수 계산일 뿐, Maia의 고객 요금 절감을 약속하는 수치가 아니다.
가상으로 시스템 A가 1kWh로 요청 1,000개를 처리하되 품질·지연 기준을 통과한 요청이 800개라면 유효 처리량은 800개/kWh다. 시스템 B가 같은 에너지로 1,200개를 처리하더라도 통과율이 60%라면 유효 처리량은 720개/kWh에 그친다. 출력 토큰이 많다는 사실과 업무를 제때 끝냈다는 사실은 구분해서 세어야 한다.
현재 병목을 먼저 기록해 두어야 한다
Maia 300 도입 여부를 판단하려면 현재 서비스가 메모리 때문에 멈추는지, 첫 토큰 생성까지 오래 기다리는지, 동시 요청이 몰릴 때 지연이 늘어나는지부터 기록해야 한다. 같은 품질과 응답 시간 기준으로 실제 처리한 업무량을 비교할 수 있을 때, 비로소 랙 규모의 성능 주장을 서비스 선택의 근거로 삼을 수 있다.