에이전트 24.8시간은 무엇을 남겼나: 실행량과 검증된 연구 결과
3.1 agent-workdays를 24.8시간으로 풀어 읽고 병렬 실행 시간·사람의 개입·채택된 결과를 구분한다. 같은 과제 묶음에서 검토와 재작업까지 비교하는 방법을 설명한다.
3.1 agent-workdays는 2026년 8월 중순 기준 수치다. OpenAI는 실행 시간, 코드량, 실험 수를 연구 진척을 가늠하는 대리 지표로 설명했다.
실행 시간은 성과의 직접 측정값이 아니다
실행 시간이 길어도 잘못된 방향으로 작업하거나 검토 부담을 늘렸다면 생산성이 좋아졌다고 볼 수 없다. 올바른 연구 판단과 검증된 결과가 실제로 늘었는지 따로 확인해야 한다.
내부 사용 로그를 관찰한 보고서
OpenAI가 2026년 9월 6일 공개한 분석은 독립 대조 실험이 아니라 내부 사용 로그를 관찰한 결과다. 여기서 researcher는 연구자뿐 아니라 연구 인프라·프로젝트 관리·지원 역할까지 포함한다.
agent-workday는 agent runtime을 표준 8시간 근무일로 환산한 값이다. 2026년 8월 중순 기준 연구자 중앙값은 API 가격으로 환산할 때 하루 600달러를 넘었고, 90백분위는 하루 7,000달러를 넘었다. 이는 사용 강도와 비용 규모를 보여주는 수치일 뿐 가치 창출액이나 시간 절감량을 뜻하지 않는다.
사용량에서 연구 진척까지 이어지는 네 단계
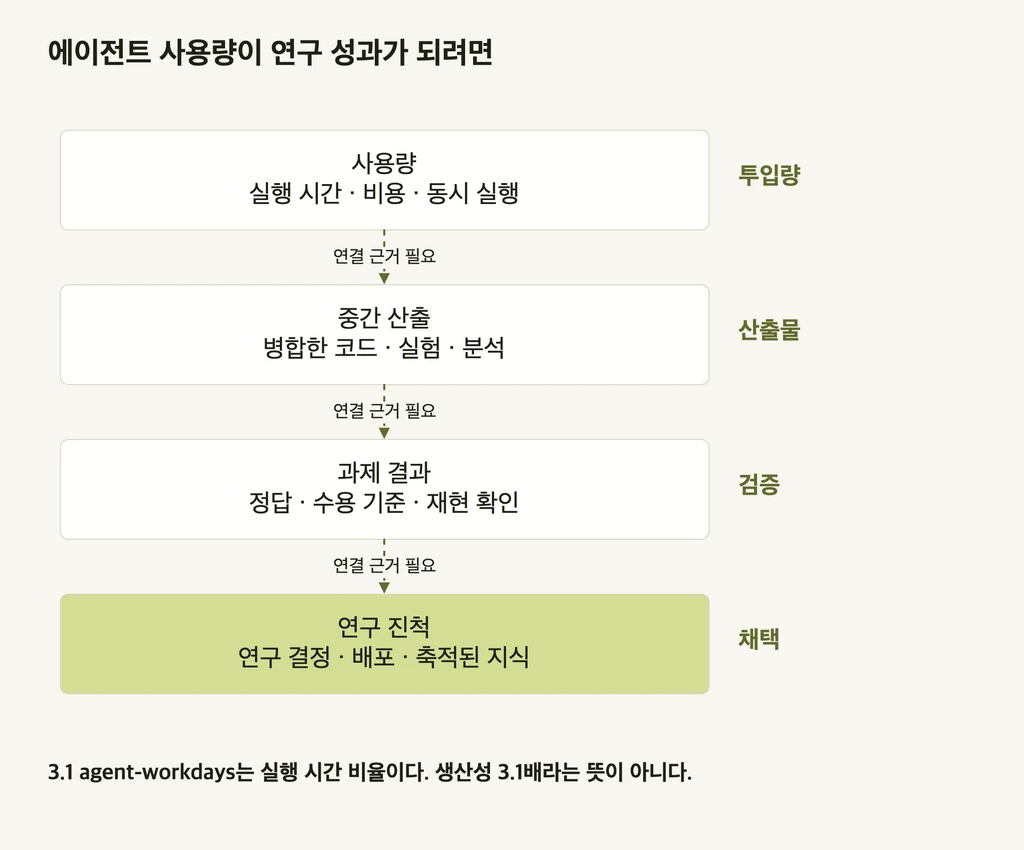
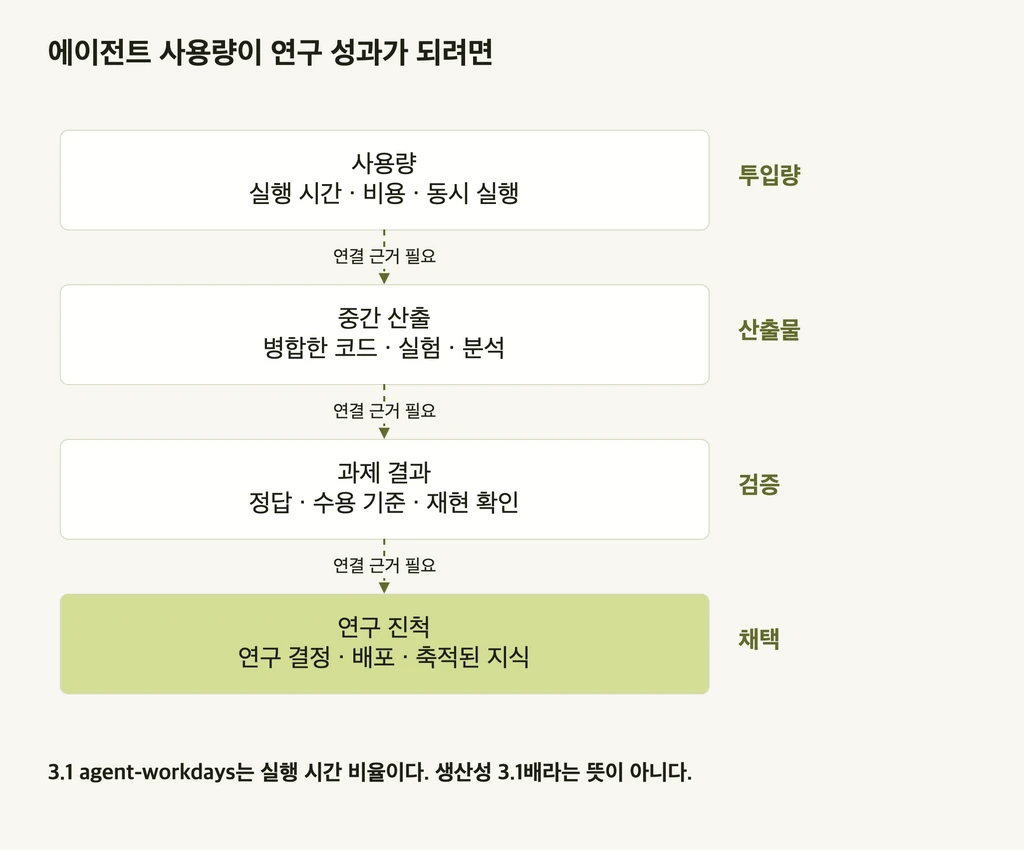
실행 시간은 투입량일 뿐 다음 단계의 성과로 자동 환산되지 않는다. 공식 자료 1 (https://openai.com/index/research-acceleration-view-inside-openai/ (새 창))
따라서 각 단계를 다음 단계와 연결해 기록해야 한다. 실행 시간이 어떤 산출물을 만들었는지, 그 산출물이 과제의 정답과 수용 기준을 만족했는지, 최종 결과가 실제 연구 결정이나 배포에 쓰였는지 차례로 확인한다.
앞 단계 수치가 늘었다고 해서 다음 단계가 같은 비율로 늘지는 않는다. 에이전트가 코드를 더 많이 작성하더라도 검토 병목이 커질 수 있다. 실험 수가 늘었더라도 가용 연산 자원이 늘어난 효과를 분리하지 않으면 Codex의 기여라고 단정할 수 없다. OpenAI 역시 이 인과 관계를 확정하지 않았다.
3.1 agent-workdays를 정의대로 풀면 3.1×8=24.8시간의 에이전트 실행량이다. 사람이 하루에 24.8시간을 절약했다는 뜻이 아니다. 예를 들어 가상의 에이전트 네 개가 각각 6.2시간 동안 동시에 돌아가면 합계는 24.8시간이지만 실제 걸린 벽시계 시간은 6.2시간이다. 그중 같은 분석을 중복 수행했다면 실행량은 모두 집계돼도 유용한 결과는 늘지 않을 수 있다. 이는 지표 단위를 설명하기 위한 계산이며 OpenAI의 개별 세션을 재현한 것이 아니다.
| 측정 대상 | 예시 | 해석 범위 |
|---|---|---|
| 사용량 | 실행 시간·비용·동시 실행 | 얼마나 사용했는가 |
| 중간 산출 | 코드·실험·분석 건수 | 무엇을 만들어 냈는가 |
| 과제 결과 | 정답·수용 기준·재현 확인 | 과제를 실제로 해결했는가 |
| 연구 진척 | 발견·판단·배포에 준 기여 | 연구가 얼마나 전진했는가 |
실험 증가의 교란 요인과 사람의 개입
2026년 8월 실제 실험을 수행한 사람당 실험 수는 2025년 1월 추적을 시작한 이후 최고치를 기록했다. Codex 도입과 함께 실험 수가 늘었지만 같은 기간 가용 연산 자원도 크게 증가했다. 비교군이 없으므로 Codex의 기여율은 계산할 수 없다.
과제 결과는 단순 사용량보다 생산성에 더 가까운 지표다. OpenAI는 ground-truth outcome이 있는 세션에서 2026년 1월부터 7월까지 난이도별 성공률이 대체로 올랐다고 설명한다. 다만 결과가 불확실하거나 세션 수 또는 고유 사용자 수가 50 미만인 지점은 그래프에서 제외했다.
사람의 개입도 함께 살펴봐야 한다. 성공한 4~8시간 과제의 절반 이상에서 한 번 이상 사람의 개입이 있었다. 높은 성공률이 곧 완전 자율성을 뜻하지는 않으며, 연구자가 방향을 교정한 시간과 검토 부담까지 함께 고려해야 한다.
과제별로 사용량과 검증 결과를 연결하기
사용량 대시보드에는 실행 시간·비용·동시 실행 수를 기록하고, 중간 산출에는 병합한 코드·실험·분석 완료 건수를 기록한다. 과제 결과는 사전에 정한 수용 기준과 재현 검사로 확인하며, 실제 진척은 연구 결정의 질·작업 주기·배포·지식 축적처럼 조직 목표와 연결해 평가한다.
연산 예산, 모델·도구 변경, 데이터 누락, 사람의 개입 횟수도 함께 남겨야 전후 비교가 가능하다. 초안 작성이 빨라지는 동안 검토와 연산 자원이 새로운 병목이 됐는지도 확인한다.
과제별로 에이전트 실행 시간, 사람의 개입, 채택된 결과, 재작업 여부를 묶어 기록하면 사용량이 실제 성과로 이어지는 지점을 찾을 수 있다.
가상으로 같은 난이도의 과제 10개를 사람이 직접 처리해 8개를 채택하고 총 20시간을 쓴 기준선을 가정해 보자. 보조 도구를 쓴 조건에서도 똑같이 8개를 채택했고, 사람의 지시·검토에 12시간, 재작업에 4시간이 걸렸다면 사람 투입 시간은 총 16시간이다. 이 조건에서 과제당 사람 시간은 2시간에서 1.6시간으로 줄지만, 별도로 돌아간 에이전트 실행 시간 30시간을 사람의 절약 시간에 더할 수는 없다. 비교군 배정이나 품질·난이도가 같은지 검증하지 않은 예시는 인과 효과의 증거가 될 수 없다.
채택 수만 같다고 해서 품질까지 같지는 않다. 나중에 발견된 오류와 취소된 결정을 추적하고, 실험을 더 많이 생성했더라도 검토되지 않은 결과는 완료 성과와 분리한다. 사용량은 투입 기록으로, 채택과 재현은 결과 기록으로 연결해야 다음 병목이 생성 단계인지 검토 단계인지 판단할 수 있다.
관찰 결과로 인과 효과를 확정할 수는 없다
OpenAI 보고서는 내부 데이터 일부만 다루며 모든 사용 사례를 포괄하지 않는다. API 가격으로 환산한 비용은 실제 내부 원가와 다를 수 있고, 도구와 사용 방식도 조사 기간 내내 바뀌었다. 관찰 연구이므로 Codex가 실험 증가나 연구 성과를 직접 이끌어냈다고 확정할 수 없다.
조직 보고서에서도 3.1 같은 사용량 수치와 검증된 과제 성과를 구분해 표시해야 한다. 과제별 기록을 연결해야 단순히 사용량만 늘었는지, 검토 부담을 포함한 연구 과정 전반이 실제로 개선됐는지 판단할 수 있다.
참고 자료
Research acceleration: The view inside OpenAI
· OpenAI, 2026-09-06