음성 에이전트는 어디서 기다릴까: 텍스트·녹음 캐시와 재생 버퍼
음성 안내 요청 하나로 텍스트·녹음 캐시가 생략하는 작업을 따라간다. 캐시 키와 가상 지연 계산, 재생 버퍼와 끼어들기 처리를 연결해 재사용이 유리한 조건을 설명한다.
음성 에이전트가 “오늘은 오후 6시에 닫습니다”라는 답을 이미 알고 있어도, 사용자가 그 소리를 듣기까지는 거쳐야 할 단계가 남는다. 사용자의 말이 끝났는지 판단하고, 답을 음성으로 변환해 재생 버퍼로 넘겨야 하기 때문이다. 텍스트를 저장해 두면 대사 생성을 건너뛸 수 있지만, 음성 합성까지 생략하려면 녹음 파일이 필요하다. 두 캐시가 줄여 주는 지연 구간은 서로 다르다.
가상의 매장 안내 요청 하나를 예로 들어 이 차이를 따라가 보자. 처리 경로는 NVIDIA의 공개 제작 사례와 Voice Agent 코드를 바탕으로 살펴보고, 캐시 키와 시간 계산은 설명을 돕기 위한 설계 예시로 구성한다. 아래 예시는 실제 매장에서 측정한 결과가 아니다.
답변 한 문장이 세 경로를 지난다
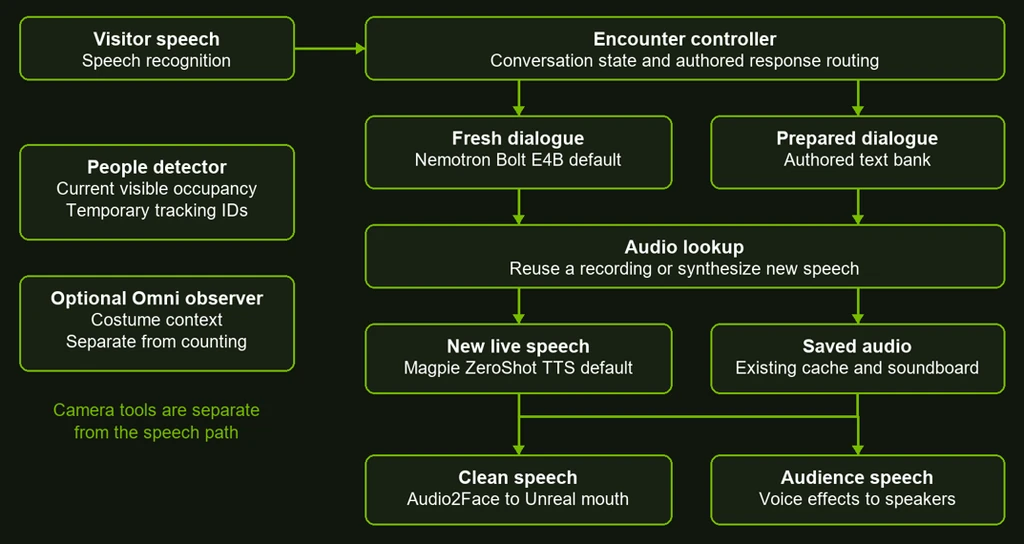
MonsterHouse 제작 사례 (새 창)의 도표를 보면, 새로 만든 대사와 미리 준비한 문장이 오디오 조회 단계로 모인 뒤 다시 음성 합성과 저장된 오디오 재생으로 나뉜다. 준비된 문장은 LLM 생성을 건너뛰고, 녹음 파일은 TTS 합성을 생략한다. 이후 깨끗한 원음은 얼굴 애니메이션에 쓰이고, 음향 효과를 입힌 음성은 관객에게 전달된다.
매장 안내에서 질문이 “오늘 몇 시에 닫나요?”로 들어왔다고 해 보자. 첫 번째 경로는 현재 영업시간을 확인해 문장을 생성한 뒤 음성으로 합성한다. 두 번째 경로는 현재 정책에 맞는 완성된 문장을 찾아 음성만 합성한다. 세 번째 경로는 그 문장에 해당하는 녹음 파일까지 찾아서 바로 재생한다. 여기서 캐시에 저장하는 대상은 완성된 응답 문장이나 오디오 파일이지, 모델 내부의 KV 캐시가 아니다.
세 번째 경로라고 해서 질문을 이해하고 오늘에 맞는 안내를 고르는 과정까지 생략할 수는 없다. “오늘”이 휴일인지 확인하지도 않고 평일 안내 녹음을 틀어 주면, 합성 비용은 아껴도 틀린 답을 즉시 들려주게 된다. 따라서 이 예시에서는 정답을 결정하는 절차 뒤에 캐시 조회를 두는 편이 맞다.
첫 소리가 날 때까지 무엇을 기다리는가
Voice Agent의 고정 커밋 (새 창)을 보면 입력, STT, 사용자 문맥 집계, LLM, TTS, 출력이 차례대로 이어진다. 사용자와 봇 사이의 지연을 추적하는 관찰기와 단계별 내역 이벤트도 별도로 연결된다. 이는 MonsterHouse의 캐시 구현 코드가 아니라 공개된 일반 파이프라인이다.
지연 시간을 이해하기 위해 단순한 직렬 모델을 가정해 보자. 사용자의 발화가 끝난 뒤 응답할 내용을 결정하기까지 400ms, 새 문장에서 첫 발화가 가능한 구간을 얻기까지 300ms, 첫 음성 조각을 합성하는 데 200ms, 재생 준비에 100ms가 걸린다고 둔다. 새로 생성하는 경로에서는 첫 소리가 나기까지 1,000ms가 걸린다. 문장 조회에 20ms가 걸린다면 텍스트 캐시 경로는 720ms로 줄어든다. 녹음 조회 역시 20ms라면 두 조회를 모두 거치는 녹음 캐시 경로는 540ms가 된다.
이 계산에서 녹음 캐시는 200ms짜리 음성 합성을 20ms짜리 조회로 대체한다. 하지만 모든 경로에 공통으로 남아 있는 400ms와 100ms는 줄이지 못한다. TTS가 아무리 빨라져도 이 조건에서는 전체 응답 시간이 그보다 짧아지지 않는다. 실제 스트리밍 환경에서는 인식·생성·합성이 일부 겹쳐서 돌아가므로 각 단계의 전체 처리 시간을 단순 합산하면 안 된다. 위 계산의 300ms도 답변 전체를 생성하는 시간이 아니라 첫 소리를 내는 데 필요한 만큼의 텍스트가 준비되는 시간이다.
MonsterHouse 작성자가 보고한 지연 시간 중앙값은 새 생성·TTS 경로가 1.70초, 캐시 응답이 0.72초다. 두 경로에서 생략되는 작업이 서로 다르므로 이 차이를 온전히 TTS 비용으로 해석할 수는 없다. 사례에 언급된 300ms의 침묵 대기와 측정 시작점 사이의 관계도 확인되지 않았으므로 임의로 더하거나 빼지 않는다.
| 경로 | 결정 뒤 거치는 작업 | 첫 소리까지 |
|---|---|---|
| 새 생성 | 첫 텍스트300ms + 합성200ms | 1,000ms |
| 텍스트 캐시 | 문장조회20ms + 합성200ms | 720ms |
| 녹음 적중 | 문장조회20ms + 녹음조회20ms | 540ms |
| 녹음 미적중 | 문장조회20ms + 녹음조회20ms + 합성200ms | 740ms |
문장 키와 녹음 키를 분리하는 이유
가상 안내 시스템의 문장 키를 (매장, 적용일, 언어, 안내 정책 버전)으로 구성해 보자. 이 키는 “오늘은 오후 6시에 닫습니다”라는 완성된 문장을 가리킨다. 녹음 키는 (완성 문장, 목소리 버전, 발화 스타일, 오디오 형식)으로 잡는다. 첫 번째 키는 안내 내용 자체가 유효한지 판별하고, 두 번째 키는 그 내용을 어떤 소리로 표현했는지를 구분한다.
마감 시간이 오후 7시로 바뀌면 문장 키의 정책 버전이 달라진다. 바뀐 문장에 맞는 녹음이 아직 없다면 텍스트 적중·오디오 미적중으로 분류해 음성을 새로 합성한다. 반대로 안내 문장은 그대로인데 목소리만 바뀌면 문장은 재사용하고 녹음만 새로 만든다. 하나의 “질문 유사도” 점수만으로 두 캐시를 묶어서 관리하면 이 두 가지 변경 상황을 구분하기 어렵다.
이러한 설계는 같은 내용이 반복되는 안내에 잘 맞는다. 주문번호나 사용자 이름이 들어가는 답변은 완성 문장이 달라져 재사용할 수 있는 범위가 좁아진다. 템플릿이 같다는 이유만으로 다른 사용자의 완성 녹음을 그대로 재생해서는 안 된다. 공통 인사와 개인별 응답을 쪼개는 방법도 있지만, 음성 조각을 이어 붙인 경계에서 억양과 호흡 간격이 어색해질 수 있다. 저장 단위는 캐시 적중률뿐만 아니라 사람이 듣기에 한 문장이 얼마나 자연스러운지도 함께 고려해 정한다.
캐시가 적중해도 재생 버퍼는 남는다
공식 성능 조정 문서 (새 창)는 오디오를 묶어서 보내는 버퍼를 설명한다. 버퍼 크기를 늘리면 네트워크 전송 간격의 흔들림은 흡수할 수 있지만, 첫 재생이 늦어지고 사용자가 말을 끊고 들어올 때 대응하기 불리해진다. 대화가 중단됐을 때 클라이언트의 재생 큐를 비우지 않으면 이미 내려받은 음성이 계속 흘러나올 수 있다.
매장 안내를 듣던 사용자가 “아니요, 내일이요”라고 끼어드는 상황을 생각해 보자. 서버가 오늘자 안내 녹음 전송을 즉시 멈추더라도 클라이언트 재생 큐에 남아 있는 오디오 조각은 별개다. 이 예시에서는 요청마다 발화 식별자를 붙이고, 새 질문이 시작되면 이전 발화의 대기 조각을 폐기하는 방식을 고려할 수 있다. 뒤늦게 도착한 이전 합성 결과 역시 같은 식별자로 걸러내야 한다.
따라서 녹음 캐시는 첫 소리가 나오기까지의 지연 시간만으로 평가하지 않는다. 사용자가 끼어든 순간부터 이전 음성이 실제로 멈출 때까지 걸리는 시간도 함께 잰다. 합성만 빠른 시스템과 대화가 자연스러운 시스템의 차이가 바로 이 구간에서 드러날 수 있다.
적중률을 올리기 전에 미적중 경로를 본다
앞서 설정한 가상 시간을 기준으로 텍스트 조회가 항상 적중한다고 가정해 보자. 오디오 조회에 걸리는 시간까지 포함하면 녹음 적중 시 540ms, 녹음 미적중 후 합성 시 740ms가 걸린다. 녹음 적중 확률이 80%일 때 단순 평균은 0.8×540 + 0.2×740 = 580ms다. 물론 이 수치가 중앙값이나 가장 느린 5%의 지연을 대변하지는 않는다. 실제 지연 분포를 파악하려면 개별 요청을 직접 측정해야 한다.
만약 원격 저장소를 거치느라 오디오 조회 시간이 250ms로 늘어난다면, 같은 계산에서 적중 시 770ms, 미적중 시 970ms가 걸린다. 텍스트만 조회하고 바로 합성하는 경로(720ms)보다 오히려 느리다. 음성을 미리 저장해 두었다는 사실만으로 이득이 생기는 것은 아니며, 아끼게 되는 합성 비용보다 조회 비용이 작아야만 의미가 있다. 이 결과는 앞선 가정에 따른 단순 계산 비교일 뿐, 실제 NVIDIA 시스템의 성능을 예측하지 않는다.
실제 매장 안내에 적용한다면 새 생성·텍스트 적중·오디오 적중을 분리해 기록하고, 정책 버전을 바꾼 직후 발생하는 미적중 구간도 측정에 포함한다. 발화 종료, 내용 결정, 첫 텍스트 준비, 첫 음성 준비, 실제 재생 시작과 중단 시점을 기록해 두면 어느 단계에서 대기가 발생했는지 설명할 수 있다. 캐시의 목표는 모든 응답을 저장하는 데 있지 않다. 재사용해도 되는 내용을 정확히 추려낸 뒤, 해당 경로에서 가장 비싼 작업을 덜어내는 것이다.