Scion은 왜 전체 저장소를 받지 않을까: 조회·파일·캐시 경로의 분리
Scion의 조회 API와 파일 캐시 경로를 따라가며 객체 적중률, 지연 다운로드의 왕복 비용, 누락 후 재실행 비용을 계산한다. Git의 sparse checkout과 partial clone도 나눠 설명한다.
AI 작업이 저장소의 변경 목록만 필요할 때도 전체 작업 디렉터리를 준비해야 할까. 반대로 파일 몇 개만 받으면 테스트까지 충분히 실행할 수 있을까. Scion 사례가 던지는 질문은 저장소가 얼마나 큰가보다 각 작업이 어떤 데이터를 실제로 읽는가에 가깝다.
조회와 파일 실행을 나누고, 계층형 캐시와 지연 다운로드의 비용을 따라가 보자. 아래 요청 수와 시간은 설명을 위한 가정이며, Scion을 직접 운영하거나 사내 저장소 이관 성능을 측정한 결과는 아니다.
변경 이력 질문과 파일 내용 요청은 다른 경로를 탄다
Anthropic의 Scion 설명 (새 창)은 이력·diff 같은 질문은 서버가 처리하고, 클라이언트는 필요한 파일 내용을 요청하는 구조를 소개한다. 온라인 연결을 전제로 로컬에 준비할 데이터를 줄이는 설계다. 파일을 실행할 필요가 없는 질의라면 작업 복사본 자체를 생략할 수도 있다.
가령 가상 작업이 “기준 커밋과 대상 커밋 사이에 어떤 파일이 바뀌었는가”라면 필요한 결과는 경로와 변경 정보다. 반면 “바뀐 함수의 테스트를 실행하라”는 작업에는 소스·공통 모듈·설정·도구가 필요하다. 같은 변경을 다루더라도 작업을 끝내는 데 필요한 데이터의 범위는 다르다.
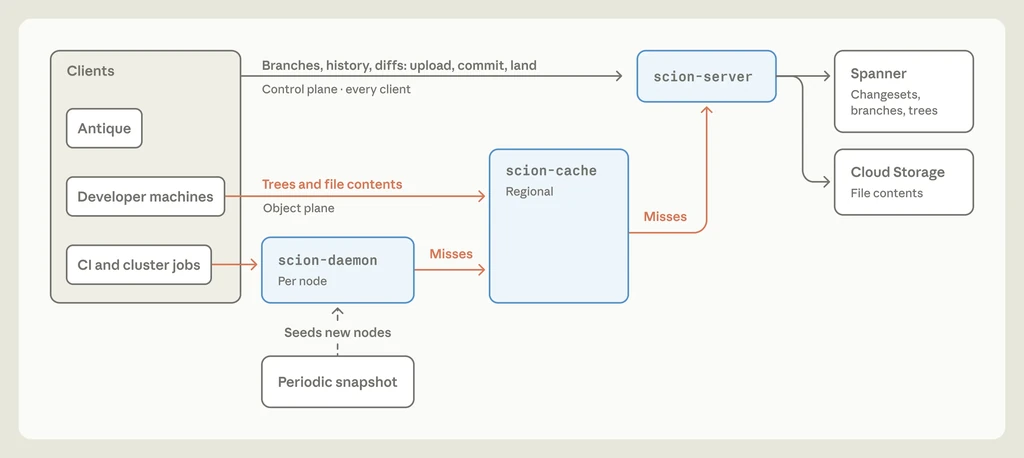
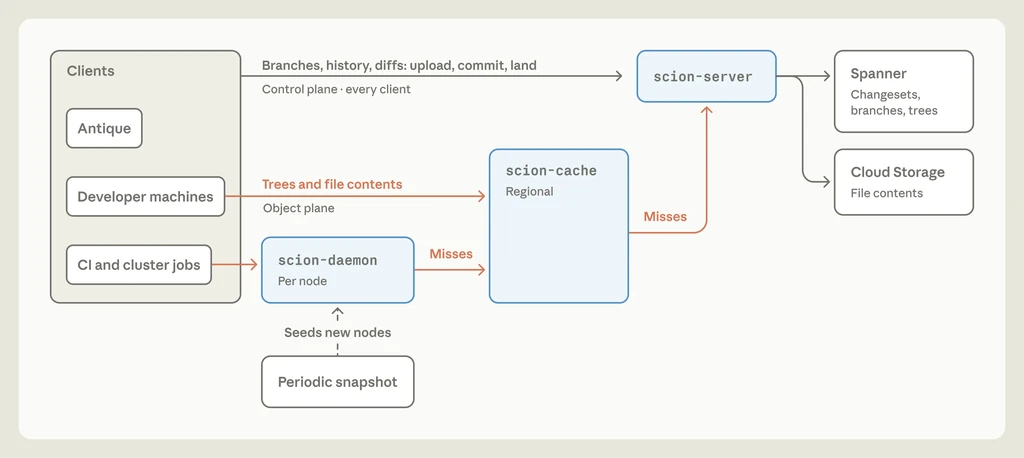
그림에서 CI·클러스터 작업의 파일 요청은 노드 daemon, 지역 cache, 상위 server 경로를 따른다. 캐시에 있으면 가까운 계층에서 반환하고, 없으면 상위로 이동한다. 제어 질의와 파일 전송을 나누면 파일 바이트가 많이 오가는 경로를 별도로 확장할 수 있고, 조회 작업이 불필요한 파일 준비에 묶이는 일도 줄일 수 있다.
바뀌지 않는 객체를 요청하면 캐시 재사용이 단순해진다
Scion은 내용으로 주소를 정한 불변 객체를 요청한다고 설명한다. 같은 객체 식별자를 다시 요청하면 같은 내용을 기대할 수 있어 여러 작업이 캐시를 공유하기 쉽다. 반면 main처럼 이동 가능한 이름은 새로운 커밋을 가리킬 수 있다. 작업 시작 시점에 대상 커밋을 고정하는 문제와 파일 객체를 캐시하는 문제는 구별해야 한다.
가상으로 파일 요청 1,000개 중 노드 캐시에서 900개를 처리하고, 남은 100개 중 지역 캐시가 80개를 처리한다고 하자. 상위 서버까지 가는 요청은 20개다. 여기서 지역 캐시 적중률 80%의 분모는 전체 1,000개가 아니라 노드에서 놓친 100개다. 전체 요청에서 상위 요청을 피한 비율은 98%다.
이 계산은 객체 크기가 모두 같고 캐시가 유지된다는 단순한 예다. 만약 큰 파일 20개가 모두 상위로 간다면 요청 수가 적어도 전송량은 클 수 있다. 노드가 새로 생기거나 캐시가 비었을 때도 결과는 달라진다. 적중률과 함께 바이트 수·첫 실행·반복 실행을 나누어 봐야 한다.
작업 디렉터리의 범위와 객체 다운로드 범위는 다르다
Git partial clone 문서 (새 창)는 처음에는 일부 객체를 받지 않고, 필요할 때 promisor remote에서 가져오는 방식을 설명한다. sparse-checkout (새 창)은 작업 디렉터리에 펼칠 파일 범위를 제한한다. 둘은 줄이는 대상이 달라 함께 쓸 수도 있지만, 하나를 켰다고 다른 효과까지 얻었다고 볼 수는 없다.
가상 저장소의 파일 내용이 10GB이고 필요한 하위 디렉터리가 100MB라고 하자. 객체를 이미 전부 받은 상태에서 작업 디렉터리만 좁히면, 디스크에 펼친 파일은 적어져도 앞서 전송한 10GB가 되돌아가지는 않는다. 객체 다운로드까지 제한해야 초기 전송을 줄일 여지가 생긴다. 실제 전송량은 이력·압축·필터와 읽는 파일에 따라 달라지므로 이 숫자는 개념을 설명하기 위한 예일 뿐이다.
누락된 객체를 나중에 받을 수 있다는 편의에는 원격 가용성이라는 조건이 따라붙는다. 이미 있는 파일은 읽히더라도 새 객체가 필요한 순간 네트워크가 끊기면 작업이 막힐 수 있다. 오프라인 작업 여부와 재시도 경로도 준비 방식의 조건에 포함된다.
작은 파일을 늦게 받는 일이 오히려 대기를 늘릴 수 있다
가상으로 실행 중 1KB 파일 100개를 차례로 요청하고, 각 원격 왕복이 20ms라고 하자. 전송 대역폭과 처리 시간을 무시해도 직렬 왕복만 2초가 걸린다. 같은 파일을 한 번에 묶어 요청하면 이 가정에서 왕복은 20ms로 줄지만, 실제로 쓰지 않을 파일까지 미리 받을 가능성이 생긴다. 전송 바이트를 줄이는 선택과 요청 횟수를 줄이는 선택이 충돌할 수 있다.
테스트 시작 전에 확실히 필요한 공통 설정과 모듈은 묶어서 준비하고, 나머지는 필요할 때 받는 혼합 방식도 생각할 수 있다. 다만 어떤 파일이 필요한지는 테스트·플러그인·동적 import에 따라 달라진다. 좁힌 경로로 실행했다가 공통 모듈을 놓치면, 준비 시간을 줄인 것보다 실패 후 재실행하는 비용이 더 커질 수 있다.
그래서 시작까지의 시간만 재면 안 된다. 가상으로 전체 준비에 8초, 실행에 2초가 걸리던 작업을 준비 1초로 줄였더라도, 누락 복구·재실행에 12초가 추가되면 총 15초가 걸린다. 성공 조건을 같은 테스트 완료로 고정해야 비교가 의미 있다.
캐시 장애 때 상위 계층에 몰리는 요청도 설계 대상이다
Scion 설명은 캐시 계층을 엄격히 나누어 장애가 상위 서버 전체로 번지는 일을 막는다고 밝힌다. 앞선 가상 예에서 지역 캐시가 없다면 상위 요청은 20개에서 100개로 늘 수 있다. 노드 캐시까지 비면 더 커진다. 평소 적중률이 높다는 사실만으로 장애 때의 용량을 설명할 수는 없다.
일반 팀이 참고할 부분은 Git을 교체하라는 결론보다 반복 작업의 준비 범위를 분리하는 방법이다. 같은 커밋과 같은 질문에서 조회 API 결과만으로 충분한지 확인하고, 실행 작업에서는 필요한 파일·환경·테스트 결과를 동일하게 맞춘다. 첫 실행과 캐시 재사용, 누락 복구를 나누어 기록하면 비용이 어디로 옮겨 갔는지 보인다.
저장소 준비 최적화는 다운로드를 가장 적게 하는 경쟁이 아니다. 결과를 완성하는 데 필요한 데이터와 왕복, 캐시 의존성, 실패 복구를 함께 줄이는 일이다. 작업이 실제로 읽는 범위를 알아야 어떤 준비를 생략해도 되는지 판단할 수 있다.