관계를 묶으면 무엇을 잃을까: ReKnoS의 후보 축소와 정답 경로
super-relation으로 줄인 후보 수와 실제 정답 경로 보존을 구분하고, 관계 방향과 엔티티 연결을 확인하는 예시를 제시한다.
관계를 묶어 탐색 후보 줄이기
경로가 있어도 찾지 못하는 실패
Think-on-Graph(ToG) 같은 기존 LLM 기반 KG 추론은 non-retrieval rate가 높다는 한계가 있다. GrailQA 기준 약 45.7%의 쿼리가 올바른 경로를 찾지 못해 실패하며, 실패 원인은 세 가지로 나뉜다.
이 분류에서 94%는 경로 자체가 없는 경우가 아니라 방향을 잘못 선택했거나 깊이 제한에 걸린 경우에 해당한다. 단, 전체 지식 그래프 질문의 94%가 같은 이유로 실패한다는 뜻은 아니다.
초기 선택 오류를 복구하기 어려운 탐색
ToG(Think-on-Graph)는 greedy + forward-only 방식으로 탐색한다. 관계(relation)를 하나씩 평가하기 때문에 LLM 호출 수가 N^L에 비례해 지수적으로 늘어난다. 너비 N=3, 깊이 L=3이면 LLM을 최대 수십 번 호출해야 한다.
세부 관계를 묶는 super-relation
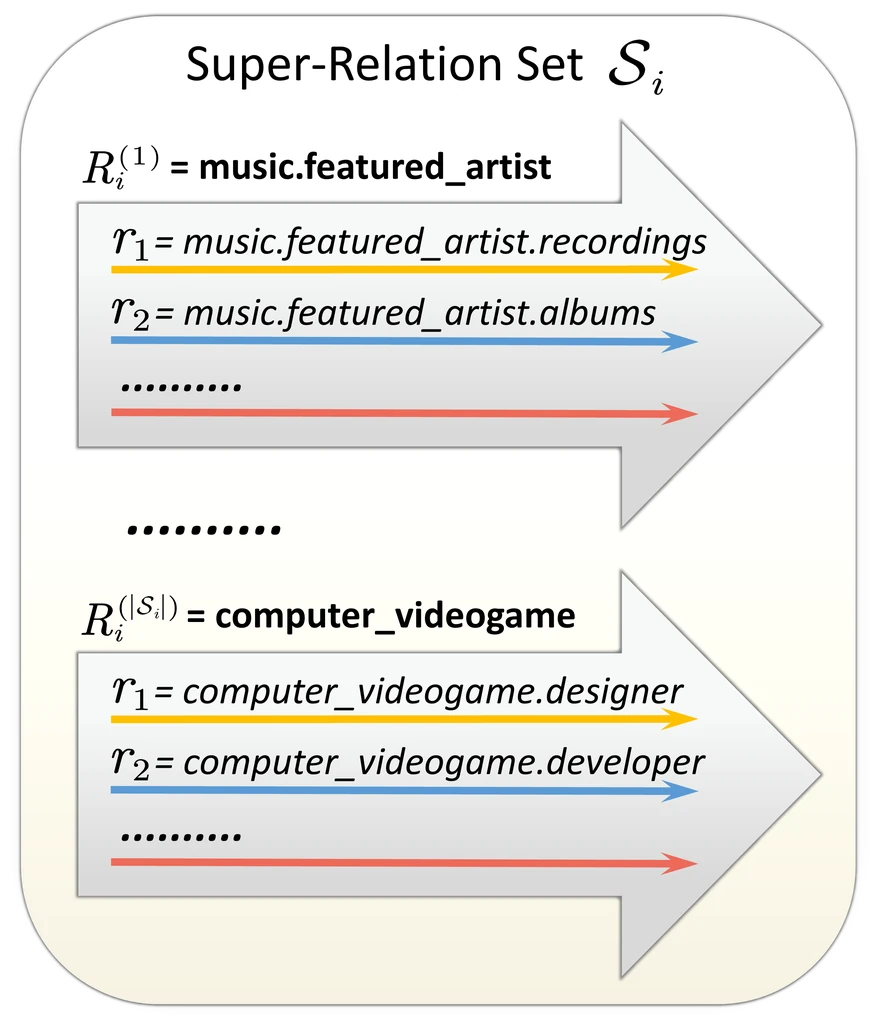
Super-relation은 의미상 같은 도메인에 속하는 세부 관계들을 묶은 군집이다. ReKnoS는 관계 계층의 두 번째 수준을 활용한다. 아래에 점으로 구분한 이름은 Freebase식 관계 네임스페이스 예시이며, 논문에 나오는 Wikidata 표기는 실제 스키마와 구분해 읽어야 한다. Freebase의 domain/type/property 구조 (https://developers.google.com/freebase/guide/basic_concepts (새 창))와 Wikidata의 P175 같은 속성 식별자 (https://www.wikidata.org/wiki/Property:P175 (새 창))는 체계가 서로 다르다.
하나의 super-relation이 여러 세부 관계를 대표하므로 점수를 매길 후보 수가 줄어든다. 계층 구조가 없는 OBQA·MetaQA에서는 의미 군집을 만들어 사용한다. 다만 후보가 줄어든다고 해서 정답 보존까지 보장되지는 않으므로 군집 품질을 확인해야 한다.
후보 선택·점수화·엔티티 추출·종료 판단
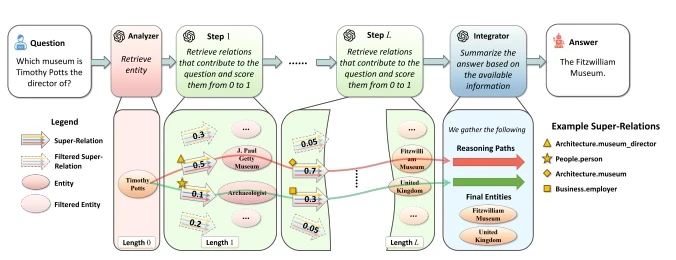
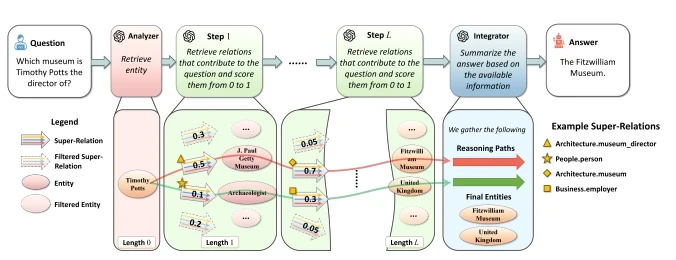
전체 흐름은 다음 4단계를 반복하며 진행된다.
① Candidate Selection: 현재 search path의 마지막 super-relation 집합(S_{l-1})에 연결된 모든 후보 super-relation을 KG에서 추출한다. 이 과정은 LLM 없이 그래프 탐색만으로 수행한다.
② Scoring: LLM이 후보 super-relation과 쿼리의 관련성을 0~1 사이의 점수로 매기고 상위 N개를 고른다. 점수는 정규화해 이후 경로를 선택할 때 활용한다. 이 단계에서 LLM은 1번만 호출한다.
③ Entity Extraction: 선택한 super-relation search path Q_l에서 실제로 연결되는 엔티티를 추출한다. 수식은 아래와 같으며, Super-relation path와 실제 KG relation path 사이의 매핑은 Theorem 4.2가 보장한다.
④ Termination Decision: 현재 추출된 엔티티만으로 답변할 수 있는지 LLM이 판단한다. 답변할 수 있으면 답변을 생성하고, 불가능하면 l을 늘려 과정을 반복한다.
양방향 탐색과 대안 경로 확보
ReKnoS는 super-relation의 요약 정보를 활용해 양방향으로 추론한다.
Forward reasoning: 현재 경로에서 다음 단계의 super-relation을 탐색한다.
Backward reasoning: 현재 경로가 막히면 super-relation 요약 정보를 바탕으로 이전 단계에서 대안 경로를 찾는다.
기존 ToG는 순방향 탐색만 지원해 Misdirection이 발생하면 복구할 수 없었다. 반면 ReKnoS의 LLM 호출 수는 2L* + 1로 너비 N과 무관해 효율적이다.
| 유형 | 비율 | 원인 |
|---|---|---|
| Misdirection | 68.8% | 초기 관계 선택 오류 → 이후 경로 전체 오염 |
| Depth Limitation | 25.2% | 최대 탐색 깊이 초과 |
| Path Absence | 6.0% | KG에 실제로 경로 없음 |
Step 1: relation_A 선택 → 틀림
Step 2: relation_A 기반으로만 다음 탐색 → 계속 틀림1단계: music ← 도메인
2단계: music.featured_artist ← Super-relation (이걸 사용)
3단계: music.featured_artist.recordings
music.featured_artist.albums ← 실제 세부 관계들E_l = { e | r1∈R1, r2∈R2, ..., rl∈Rl 을 통해 e1 → e2 → ... → e 가 성립 }| 방법 | LLM 호출 수 | WebQSP Hits@1 |
|---|---|---|
| ToG | 15.3회 | 76.2% |
| StructGPT | 11.0회 | 75.2% |
| ReKnoS | 7.2회 | 81.1% |
관계 매핑과 탐색 상태 구현
Super-Relation 구성 전략
KG 종류에 따라 두 가지 전략 중 하나를 선택한다.
관계 계층이 있는 KG에서는 2단계 수준과 세부 관계의 매핑을 미리 만들어 둔다. 이렇게 하면 실행 시점에 매핑을 다시 구성하는 비용은 줄어들지만, 조회·탐색 비용까지 사라지지는 않는다.
계층이 없는 KG에서는 관계 임베딩을 구한 뒤 K-means나 계층 군집 등으로 묶는다. sentence-transformers나 LLM으로 군집 이름을 생성할 수 있지만, 이름을 붙였다고 해서 군집의 의미 정확도나 해석 가능성이 보장되지는 않는다.
상태 관리: Search Path
Search path Q_l = {S_1, S_2, ..., S_l}은 추론의 중간 상태 전체를 담는다. 데이터 구조에는 다음 요소가 들어간다.
각 S_i는 super-relation 집합과 개별 super-relation의 점수로 구성된다.
S_i 사이의 연결성(connectivity) 정보도 함께 저장한다.
경로 점수(Score(P_i) = sum of scores)는 이 구조에서 바로 계산한다.
멀티턴 추론의 안정성은 이 상태를 얼마나 잘 직렬화하고 역직렬화하는지에 달려 있다.
LLM 프롬프트 설계 핵심
Scoring 프롬프트에는 super-relation의 존재를 따로 언급하지 않는다. LLM이 super-relation의 추상성 때문에 혼란을 겪지 않도록 일반 relation처럼 제시한다.
Termination 프롬프트에는 현재 추출된 엔티티 목록과 원본 질문을 함께 넣고, 답변 가능 여부를 이진 결정(답변 가능/불가능)하도록 유도해 모호한 중간 답변이 나오지 않게 한다.
확장성 고려사항
KG 규모: 대형 KG에서는 Candidate Selection 단계에서 후보 수가 급격히 늘어날 수 있다. super-relation 연결 그래프를 미리 인덱싱해 두면 반복 조회 비용은 줄어들지만, 반환된 후보 수만큼 처리해야 하므로 전체 탐색 복잡도가 O(1)이 되지는 않는다.
LLM 교체: Scoring과 Termination 로직을 인터페이스로 추상화해 두면 설정만 바꿔 GPT-4o, Claude, 로컬 Llama 등으로 교체할 수 있다. 논문에서도 여러 모델로 실험한 결과를 보고한다.
캐싱: 질문, super-relation 후보, 모델, 프롬프트 버전 조합이 모두 같다면 scoring 결과를 캐싱해 둘 수 있다. 관계 후보만 같다고 해서 다른 질문에서 계산한 점수를 재사용해서는 안 된다. 캐싱 효과는 같은 조건의 쿼리가 얼마나 자주 반복되는지와 캐시 무효화 비용이 얼마인지를 함께 측정해 판단한다.
검증이 필요한 개선 후보
지표별 결과와 한계
GNN-RAG와의 지표별 우위 차이: Table 9를 보면 GNN-RAG(WebQSP F1: 73.5)는 ReKnoS(79.5)보다 F1은 낮지만 Hits@1은 앞선다. GNN-RAG는 화이트박스 파인튜닝이 필요한 대신 그래프 구조 정보를 더 풍부하게 활용한다. super-relation으로 추상화하는 과정에서 세부 구분이 약해질 수는 있으나, 이 비교 결과만으로 성능 차이의 원인을 정보 손실이라고 단정할 수는 없다.
SimpleQA에서의 성능 역전(GPT-4o-mini): 단일홉 질문에서는 super-relation 추상화가 오히려 오버헤드가 될 수 있다. 질문 복잡도를 먼저 분류해 단순한 질문은 KG를 직접 탐색하고, 복잡한 질문에만 ReKnoS를 적용하는 하이브리드 라우팅을 검토해 볼 수 있다.
추가 실험이 필요한 설계안
① Adaptive Super-Relation Granularity: 계층형 그래프는 2단계 계층을, 비계층 그래프는 군집을 사용한다. 질문 복잡도나 후보 수에 맞춰 추상화 수준을 동적으로 조절할 때, 1단계와 3단계 선택이 정답 경로를 잘 보존하는지 실제 후보 수와 함께 비교해야 한다.
② Backward Reasoning의 명시적 구현: 역방향 탐색을 구현할 때는 실패 경로에서 복귀하는 조건과 대안 super-relation을 고르는 규칙을 명확히 정의해야 한다. Misdirection 사례에서 실제로 복구한 경로와 호출 수를 비교해 검증한다.
③ 그래프 구조 임베딩 통합: 현재 entity extraction은 순수 그래프 탐색에 의존한다. GNN 기반 엔티티 임베딩을 scoring 단계의 보조 신호로 추가하면 LLM의 언어적 판단에 그래프 구조 정보를 결합해 GNN-RAG의 장점을 흡수할 수 있다.
④ 점수 모델의 학습화: super-relation 점수화 과정을 소형 cross-encoder로 학습시키면 LLM 호출 비용을 줄일 수 있다. 단, 정확도가 높아진다는 보장은 없으므로 그래프나 질문 분포가 바뀔 때 성능이 어떻게 달라지는지 평가해야 한다.
⑤ 도메인 특화 Super-Relation 자동 구성: 제조·의료 그래프에서 관계 사용 빈도와 공출현 정보를 활용하면 군집 후보를 만들 수 있다. 그러나 통계적 공출현이 도메인에서의 의미 일치를 뜻하지는 않으므로, 전문가 검토와 정답 경로 보존 검사가 필요하다.
도입 전 검증 기준
도입하기 전에 관계를 묶기 전후의 정답 경로 보존율, 후보 수, 호출 비용을 비교한다. 비정형 텍스트에서 구축한 그래프나 자연어 관계 레이블을 쓰는 환경에서는 군집 오류가 병목이 될 수 있다. 단일홉 질문까지 똑같이 추상화할지는 별도 기준선과 비교해 결정한다.
가상의 그래프에서 회사 A의 설립자는 B이고 현재 대표는 C라고 해 보자. 두 관계를 “회사 관련 인물”로 묶으면 후보 이름은 단순해지지만, “현재 대표는 누구인가”라는 질문에 답하려면 세부 관계를 구분해야 한다. 상위 묶음을 잘 골랐더라도 B와 C를 구별하지 않고 답하면 오답이 된다. 관계 묶음은 탐색 후보를 압축하는 단위일 뿐, 최종 사실 확인을 대신하는 답이 아니다.
작은 검증용 그래프에는 같은 엔티티 쌍을 잇는 다른 관계, 방향이 반대인 관계, 중간 노드가 끊긴 경로를 함께 넣어 둔다. 그리고 상위 경로가 선택됐을 때 실제 세부 간선으로 이어지는 연속 경로가 존재하는지 확인한다. 논문의 매핑 정리가 가정하는 구성과 임의로 만든 의미 군집을 같은 것으로 취급해서는 안 되며, 군집 구성을 바꾼 뒤에는 정답 경로가 보존되는지 다시 검사한다.
호출 수를 줄이더라도 입력 후보 목록이 길어지면 토큰 사용량과 그래프 조회 비용은 오히려 늘어날 수 있다. 같은 질문에 대해 LLM 호출 횟수, 호출별 입력량, 실제 엔티티 후보 수, 전체 소요 시간을 함께 기록한다. 분기 너비와 무관한 호출 수 수식을 시스템 전체 비용이 일정하다는 뜻으로 받아들이지 않아야 후보 압축의 실질적인 이득을 판단할 수 있다.
참고 자료
Reasoning of Large Language Models over Knowledge Graphs with Super-Relations (https://arxiv.org/abs/2503.22166 (새 창))