어제의 선호를 오늘도 쓰는 이유: 에이전트 메모리의 갱신과 회수
유사도 검색과 최신 상태 결정을 구분한다. 사용자 선호의 유효 기간과 메모리 구축 비용의 손익분기점을 예제로 설명한다.
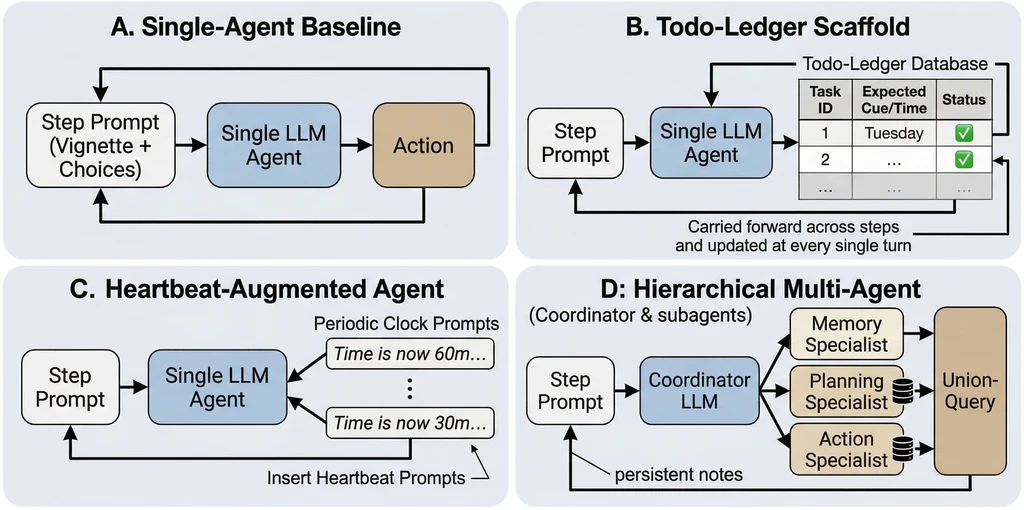
에이전트 메모리는 얼마나 많이 저장하는지보다 최신 상태를 어떻게 갱신하고 필요한 정보를 어떻게 회수하는지로 평가해야 한다. 이 글에서는 전체 대화, 요약, 벡터(Vector), 절차(Procedural) 메모리를 같은 실행 조건에서 비교하는 실험안을 다룬다.
유사한 과거 대화를 프롬프트에 덧붙이는 방식은 단순 사실을 회상할 때는 유용하다. 하지만 사용자의 바뀐 선호나 미래 시점의 요청까지 처리하려면 별도의 갱신과 실행 규칙이 필요하다.
지난 요청을 오늘 실행할 조건은 누가 확인하는가. 실패한 도구 호출 기록을 단순 저장하는 것과 다음 호출 순서를 바꾸는 것은 어떻게 다른가. 이 질문들을 분리해야 메모리가 필요한 이유를 명확히 설명할 수 있다.
메모리를 단순한 저장소로만 보면 위 질문에 답하기 어렵다. 에이전트 메모리는 무엇을 기록할지 결정하는 쓰기 경로(write path), 중복과 충돌을 정리하는 관리 경로(manage path), 현재 작업에 필요한 정보만 꺼내는 읽기 경로(read path)로 나누어 살펴봐야 한다. 최근 에이전트 메모리 연구도 이 세 경로와 장기 작업의 시스템 비용을 함께 다루는 추세다.
비교 실험에서는 같은 에이전트 런타임에 네 가지 메모리 방식을 연결해 작업 유형별 이득과 실패 양상, 운영 비용을 검증한다.
사실 회상과 절차 재사용의 분리 비교
벡터 메모리와 절차 메모리는 명확히 구분해야 한다. "지난 회의에서 예산을 20% 줄이기로 했다"는 사건 기억이고, "월간 보고서를 만들 때 매출 데이터를 먼저 검증한다"는 절차 기억이다. 두 기억을 같은 컬렉션에 넣고 유사도만으로 검색하면 단순 사실과 행동 규칙의 우선순위가 뒤섞인다.
| 방식 | 저장하는 것 | 읽는 방식 | 장점 | 주된 위험 |
|---|---|---|---|---|
| 전체 대화 유지 | 원본 메시지와 도구 결과 | 시간순으로 전부 주입 | 구현이 단순하고 정보 손실이 적음 | 컨텍스트 증가, 오래된 정보 간섭 |
| 요약 메모리 | 압축된 상태와 결정 사항 | 최신 요약을 고정 컨텍스트로 주입 | 토큰 예산 통제 용이 | 요약 과정의 누락과 왜곡 |
| 벡터 메모리 | 사실·이벤트 단위 메모리와 임베딩 | 현재 요청과 유사한 항목 상위 검색(top-k) | 대규모 기록에서 필요한 내용 선택 가능 | 의미는 비슷하나 잘못된 기억 검색 |
| 절차 메모리 | 재사용 가능한 작업 절차와 도구 사용 규칙 | 작업 유형에 맞는 기술(skill) 검색 및 적용 | 반복 업무 실행 품질 향상 | 특정 모델이나 업무에 과적합된 절차 |
평가 전 고정 조건
정확한 비교를 위해 메모리 구현만 바꾸고 나머지 조건은 동일하게 통제해야 한다.
동일한 생성 모델과 추론(reasoning) 설정
동일한 시스템 프롬프트와 도구 목록
동일한 작업별 최대 턴(turn), 토큰, 수행 시간(wall-clock) 예산
동일한 원본 대화와 환경 상태
동일한 메모리 쓰기 후보 생성 규칙
동일한 최종 컨텍스트 예산
특히 마지막 조건이 중요하다. 벡터 메모리에만 더 많은 토큰을 허용하면 검색 전략이 아니라 컨텍스트 크기를 비교하는 셈이 된다. 각 방식이 모델에 전달할 수 있는 메모리 토큰 수를 고정하고, 초과분을 어떻게 처리했는지 기록해야 한다.
권장 실행 단위는 작업×메모리전략×시드(task × memory_strategy × seed)다. 모델 출력에는 변동성이 있으므로 단 한 번의 성공이나 실패로 결론을 내리지 않으며, 모든 전략에 같은 시드와 재시도 정책을 적용한다.
평가 작업 유형
단순 회상 질문만으로는 메모리의 가치를 과대평가하기 쉽다. 제대로 된 평가를 위해 최소한 네 가지 영역을 살펴봐야 한다.
안정적인 사실 회상
초반 대화에 사용자 이름, 선호 언어, 프로젝트 제약 조건을 심어 두고 여러 작업이 지난 뒤 다시 묻는다. 가장 쉬운 기준선이며 전체 대화 유지 방식과 벡터 메모리가 유리하다. 정답 여부와 함께 관련 없는 개인정보까지 불필요하게 꺼내지 않았는지도 확인한다.
수정과 모순 처리
사용자가 처음에는 "보고서는 PDF로 달라"고 했다가 나중에 "Markdown으로 달라"고 수정하는 등 상태를 바꾼다. 이전 값과 최신 값이 공존할 때 갱신 규칙이 제대로 작동하는지 평가한다.
최신 지시 우선 반영 여부
과거 값 폐기 또는 이력 보존 여부
충돌 감지 및 사용자 확인 여부
답변 근거 메모리의 시점과 출처 추적 가능 여부
벡터 검색은 문구가 비슷한 과거 항목을 그대로 반환할 수 있고, 요약 메모리는 정보가 잘못 압축되면 원문 없이 복구하기 어렵다.
미래 의도 수행
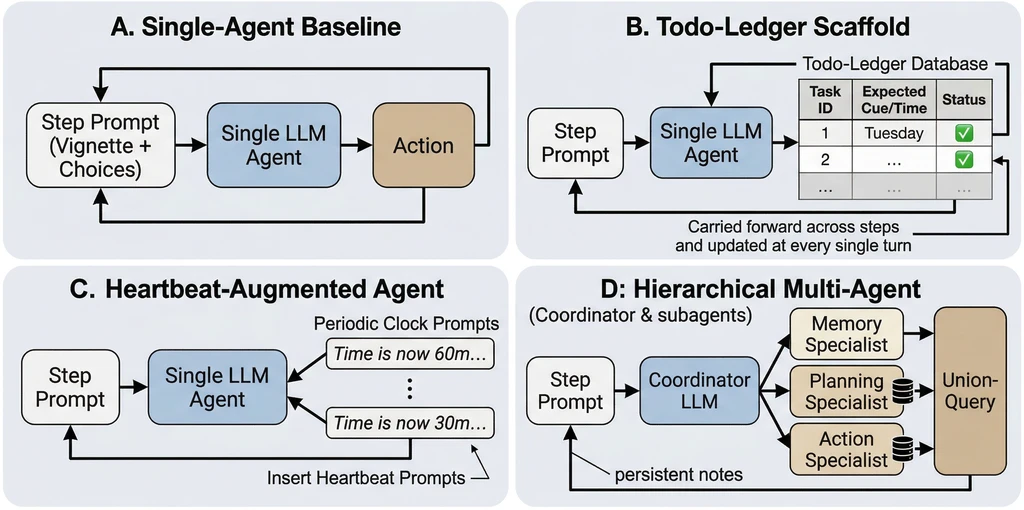
"배포가 끝나면 변경 사항을 정리해 줘"처럼 특정 조건이 충족될 때 실행할 요청을 미리 넣는다. 대기하는 동안 다른 작업을 수행한 뒤, 조건이 맞았을 때 해당 의도를 적절히 활성화하는지 평가한다. PM-Bench (https://arxiv.org/abs/2607.12385 (새 창))는 이 능력을 검증하며 현재 시스템의 한계를 보고한다.
실행 비율, 조기 실행 비율, 지연 미실행 비율, 불필요한 작업 중단 비율을 측정한다.
반복 절차 전이
첫 번째 작업에서 사람이 수정해 준 실행 순서를 다음 작업에 재사용하는지 본다. 예를 들어 SQL을 생성하기 전에 스키마를 먼저 확인하도록 교정한 뒤, 이 규칙이 다른 데이터베이스 작업에도 적용되는지 확인한다.
절차 메모리가 필요한 구간이지만, 똑같은 템플릿 작업에서만 성공한다면 단순 암기에 가깝다. 전이 수준은 같은 업무 다른 입력, 비슷한 업무 다른 도구, 다른 업무 같은 원칙의 세 단계로 나눈다.
AFTER (https://arxiv.org/abs/2606.23127 (새 창))는 실제 업무형 작업에서 절차 기억의 로컬 개선과 전이를 구분한다. 학습한 절차가 어느 수준까지 전이되었는지 확인하는 데 유용하다.
검색 성공과 작업 성공의 분리
메모리 회상(Memory Recall)과 작업 성공(Task Success)은 반드시 분리해 평가한다. 필요한 기억을 잘 검색하고도 실제 작업에 반영하지 못했다면 읽기 경로 이후의 문제다. 반대로 검색된 근거가 없는데도 정답을 맞혔다면 모델의 사전 지식이나 우연 덕분일 수 있다.
비용 역시 질의당 토큰 수만 따져서는 부족하다. 에이전트 메모리 시스템 특성 연구 (https://arxiv.org/abs/2606.06448 (새 창))에 따르면 메모리 비용은 생성(construction), 검색(retrieval), 생성(generation) 단계로 나뉜다. 요약과 정리는 쓰기 시점에 비싸고, 전체 대화 유지는 읽기와 생성 시점에 비용이 많이 든다. 따라서 초기 구축 비용이 반복 사용을 통해 상각(amortization)되는지 따져봐야 한다.
가상 메모리 M1에는 ‘보고서는 PDF’가 저장되어 있고, 나중에 M2로 ‘이번 프로젝트는 Markdown’이 들어왔다고 해 보자. 단순히 최신 문장이라는 이유로 모든 프로젝트에 M2를 적용하면 다른 프로젝트의 기본 선호까지 덮어쓰게 된다. 반대로 유사도만 보고 판단하면 PDF 관련 문맥이 더 가까워 M1을 다시 꺼낼 수 있다. 사용자·프로젝트·적용 기간·대체 관계를 먼저 확인하고 그 범위 안에서 유효한 값을 선택해야 한다.
만약 M2가 ‘이번 한 번만’ 적용하는 예외라면 기존의 영구 선호를 삭제해서도 안 된다. 원문 이벤트와 적용 범위를 남겨 두고 작업이 끝난 뒤 예외가 정상적으로 만료되는지 시험한다. 이 예시는 특정 메모리 제품의 실제 결과가 아니라 갱신 규칙이 필요한 이유를 보여준다.
비용 효율은 사용 횟수에 따라 달라진다. 가정상 메모리 구축에 100단위가 들고 질문마다 기존 방식보다 0.5단위를 아낀다면 200번은 사용해야 단순 손익분기점에 도달한다. 20번만 쓰고 말면 절약한 10단위보다 초기 구축 비용이 훨씬 크다. 실제 비교에는 갱신·삭제·검색 비용과 오류로 인해 재작업한 비용도 포함한다. 결국 저장량이 늘었다는 사실보다 재사용 횟수와 작업 성공에 얼마나 기여했는지가 중요하다.
| 지표 | 확인하는 질문 | 측정 방법 |
|---|---|---|
| Memory Recall | 필요한 기억을 읽었는가 | 정답 메모리가 읽기 집합에 포함된 비율 |
| Task Success | 실제 작업을 끝냈는가 | 환경 상태 또는 테스트 검증 |
| Contradiction Rate | 오래된 정보와 충돌했는가 | 최신 상태와 답변 및 행동 비교 |
| Intrusion Rate | 필요 없는 기억이 개입했는가 | 관련 없는 메모리 사용과 잘못된 전이 검사 |
| Latency | 메모리 처리 지연 시간 | 쓰기·관리·읽기·생성 구간별 지연 시간(p50/p95) |
| Cost | 비용 발생 항목 | 저장·요약·임베딩·검색·생성 비용 분리 |
예상 경향과 실제 결과
전체 대화 유지
대화가 짧고 원문 표현이 중요할 때 유리하며 디버깅하기 쉽다. 다만 기록이 길어질수록 토큰 사용량과 지연 시간이 늘어난다.
요약 메모리
추적할 상태가 명확한 업무에 적합하다. 상태 스키마를 고정하면 비용을 예측하기 쉽지만, 요약 모델이 중요 정보를 누락하면 복구하기 어렵다.
벡터 메모리
세션이 길고 과거의 일부 사건만 선별해 꺼낼 때 유리하다. 메타데이터 필터 없이 의미 유사도만 사용하면 적용 대상이 다른 기억을 잘못 가져올 수 있다.
절차 메모리
반복되는 도구 사용과 업무 규칙을 학습할 때 유효하다. 다만 절차가 만들어진 뒤 모델이나 도구 스키마, 권한 정책이 바뀌면 오래된 기술(stale skill)이 되므로 부작용을 점검해야 한다.
저장 정보와 갱신 규칙
무엇을 검색할지보다 무엇을 기억할지 결정하는 일이 먼저다. 모든 대화와 도구 출력을 그대로 저장하면 저장소가 오염되므로 쓰기 정책(write policy)에 다음 필드를 두어야 한다.
대체 관계(supersedes)와 유효 기간이 없으면 최신 상태를 계산하기 어렵고, 원문 참조(source_ref)가 없으면 출처 원문을 추적할 수 없다. 민감도(sensitivity) 필드가 없으면 개인정보가 그대로 노출될 위험이 있다.
삭제 역시 중요한 기능이다. 사용자가 삭제를 요청하면 원본은 물론 요약본, 임베딩, 캐시 등 파생 데이터까지 모두 추적해 제거해야 한다.
memory_id
type: fact | event | preference | intention | procedure
scope: user | project | task
source_ref
created_at
valid_from
expires_at
supersedes
confidence
sensitivity
도입 검토 가이드
처음부터 복잡한 메모리 플랫폼을 구축할 필요는 없다.
짧은 작업은 전체 대화로 처리하고 토큰 예산을 측정한다.
장기 작업은 목표, 완료 단계, 미해결 항목을 구조화해 요약한다.
누락된 과거 정보가 쌓이면 벡터 메모리를 추가한다.
반복되는 수정 패턴이 확인되면 절차 메모리로 승격한다.
작업 유형별 메모리 추가
메모리를 도입하기 전에 세션을 넘어 유지해야 할 상태와 반복되는 실패 사례를 먼저 정리한다. 해당 실패를 다시 재현해 보며 단순 회상, 상태 갱신, 미래 의도, 절차 재사용 중 실제로 필요한 메모리 유형을 파악한다.
이후 작업 성공률, 지연 시간, 비용, 잘못된 기억의 개입 여부를 측정하고 운영 부담 대비 개선 효과를 확인한 뒤 현장에 적용한다.
참고 자료
Memory for Autonomous LLM Agents: Mechanisms, Evaluation, and Emerging Frontiers (https://arxiv.org/abs/2603.07670 (새 창))
Agent Memory: Characterization and System Implications of Stateful Long-Horizon Workloads (https://arxiv.org/abs/2606.06448 (새 창))
PM-Bench: Evaluating Prospective Memory in LLM Agents (https://arxiv.org/abs/2607.12385 (새 창))
Managing Procedural Memory in LLM Agents: Control, Adaptation, and Evaluation (https://arxiv.org/abs/2606.23127 (새 창))
Effective context engineering for AI agents (https://www.anthropic.com/engineering/effective-context-engineering-for-ai-agents (새 창))