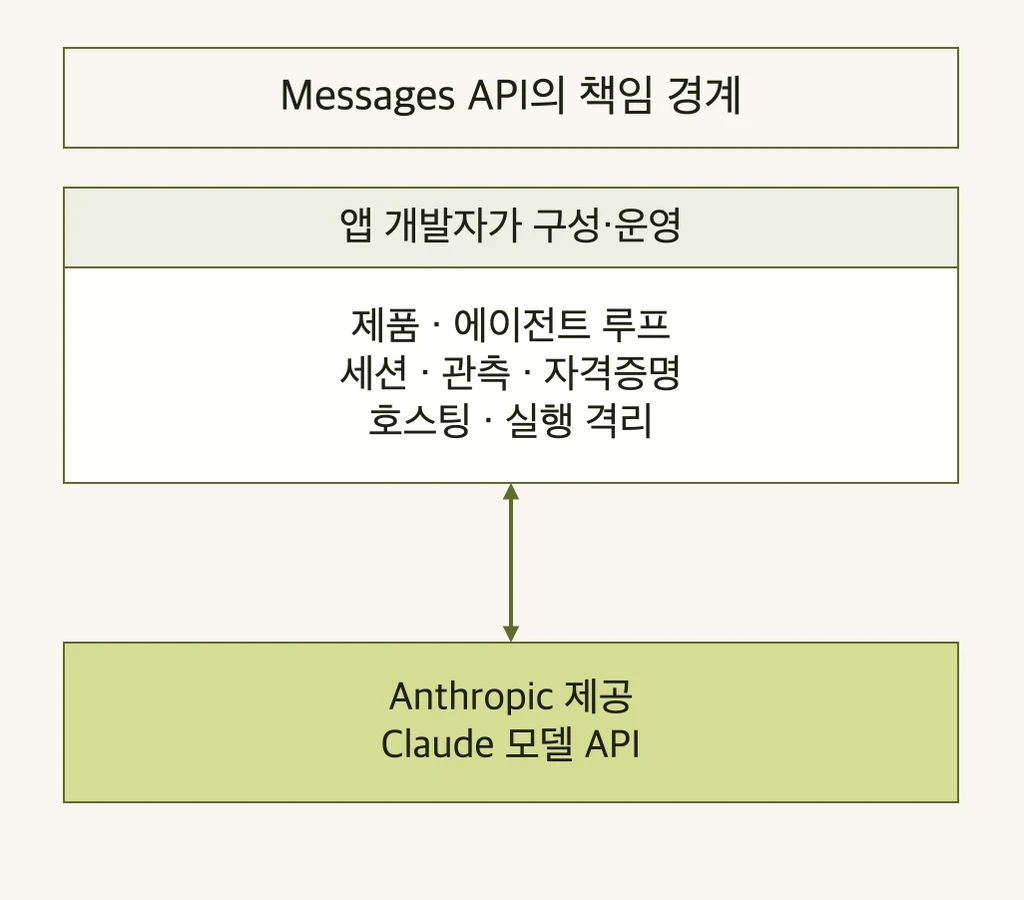
파일을 읽은 뒤 누군가 고쳤다면: 에이전트 실행 경계와 재시도
추론과 실행 분리를 파일 버전 충돌과 응답 유실 사례로 설명한다. 실행 전 권한 검사와 실행 후 외부 상태 확인이 각각 필요한 이유를 다룬다.
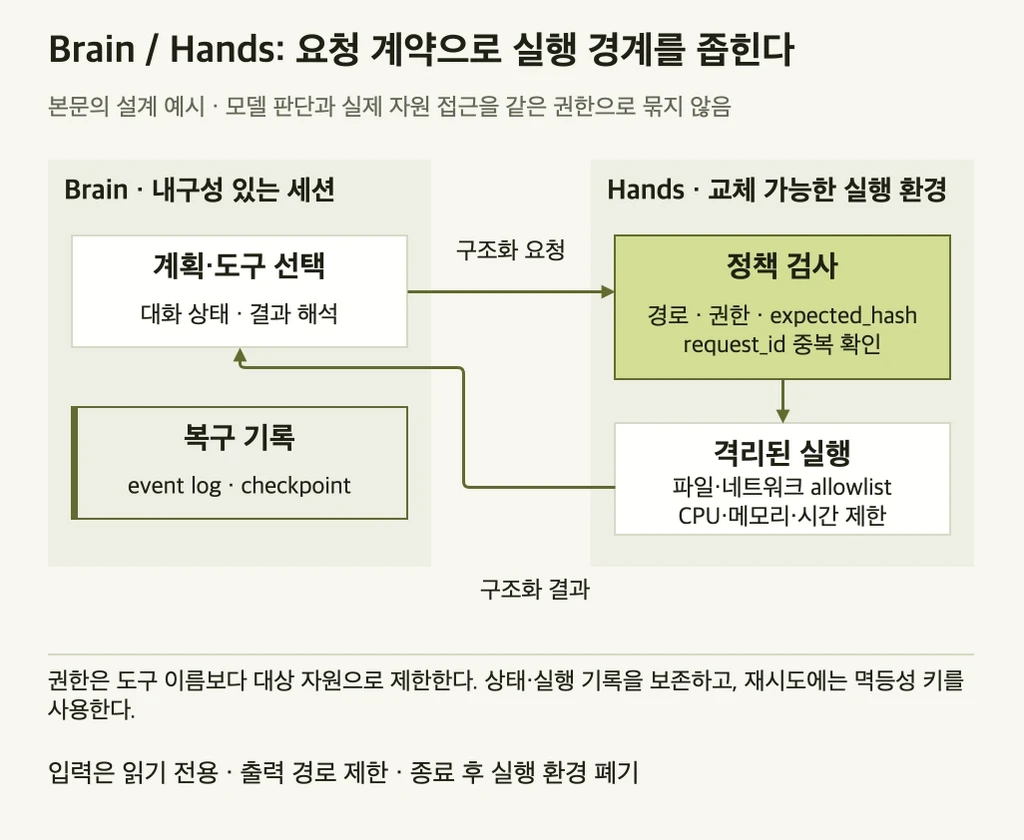
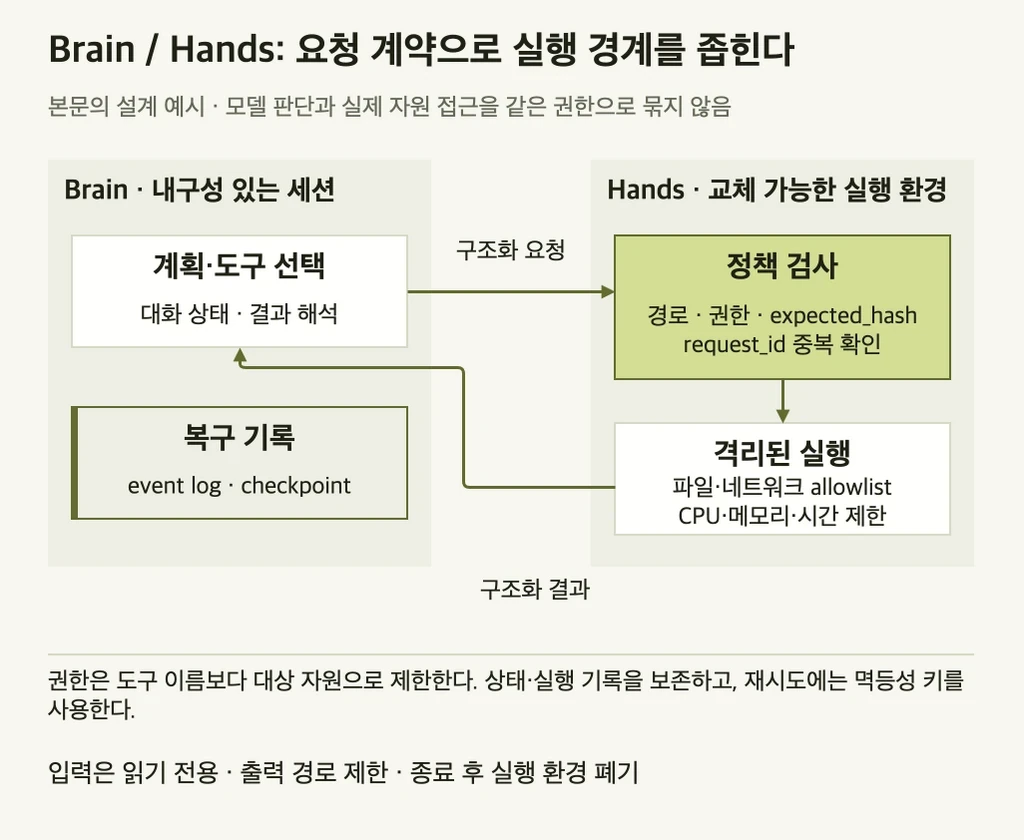
판단을 담당하는 영역을 Brain, 실제 파일·명령·API 작업을 수행하는 실행 환경을 Hands로 나눈다. 프롬프트로 모델에 주의를 주는 것과 실행기가 허용 범위를 강제하는 것은 별개의 문제다.
Brain: 대화 상태, 계획, 모델 호출, 도구 선택, 결과 해석
Hands: 파일, 셸, 브라우저, 데이터베이스, 외부 API에서 실제 동작을 수행하는 환경
이렇게 분리하는 목적은 필요한 작업을 수행하면서도 실수나 공격이 미칠 최대 피해 범위를 제한하는 데 있다.
한 프로세스에 모두 넣었을 때 생기는 문제
모델 루프, 실행 도구, 인증 정보, 작업 파일을 한 프로세스나 컨테이너에 몰아두면 개발은 단순해진다. 하지만 각 도구의 권한 경계를 따로 강제하지 않으면 읽기 작업이 쓰기나 외부 전송 권한까지 건드릴 수 있다.
예를 들어 Agent가 외부 저장소의 README를 읽었다고 하자. 그 파일에 숨은 지시가 들어 있고 같은 환경에 배포 토큰과 네트워크 권한이 열려 있다면, 단순한 문서 읽기가 외부 전송이나 운영 변경으로 이어질 수 있다. 이때 실패 원인은 모델의 판단 착오만이 아니다. 읽기 작업에 쓰기 권한과 인증 정보까지 함께 열어둔 시스템 설계도 원인이다.
Anthropic의 Agent 격리 사례 (https://www.anthropic.com/engineering/how-we-contain-claude (새 창))는 위험을 실패 확률과 사고 반경으로 나누어 설명한다. 모델 계층의 방어가 실패 확률을 낮추더라도, 샌드박스와 권한 경계가 없으면 단 한 번의 실패로 발생할 피해 규모는 그대로 남는다.
Brain과 Hands 사이에는 요청서만 오간다
분리된 구조에서 Brain은 셸을 직접 실행하지 않는다. 구조화된 작업 요청을 만들면 Hands 쪽 실행기가 정책을 검사한 뒤 수행한다.
실행기는 다음 항목을 확인한다.
이 Agent에 write_file 권한이 있는가
대상 경로가 허용된 작업 공간 안에 있는가
삭제나 덮어쓰기가 허용된 작업인가
현재 파일이 Brain이 읽었던 버전과 같은가
같은 요청을 이미 실행하지 않았는가
검사를 통과해 작업을 마친 뒤에도 실행 결과는 정해진 구조에 맞춰 돌려준다. 이렇게 하면 도구 출력에 섞여 들어온 외부 지시와 실제 실행 상태를 구분하기 쉬워진다.
Anthropic의 Managed Agents 구조 (https://www.anthropic.com/engineering/managed-agents (새 창))는 세션, harness, sandbox를 서로 다른 구성 요소로 다룬다. OpenAI Agents SDK (https://openai.com/index/the-next-evolution-of-the-agents-sdk/ (새 창))도 harness와 compute를 분리해 보안과 내구성, 확장성을 확보한다.
가상으로 Brain이 파일 버전 H1을 읽고 수정안을 만드는 동안 사람이 H2로 고쳤다고 해보자. Hands가 요청의 expected_hash=H1을 현재 H2와 비교하지 않으면 정상적인 수정 요청이라도 사람이 바꾼 내용을 덮어쓴다. 버전 충돌은 모델에게 ‘주의해서 수정하라’고 지시해서 막을 수 없다. 실행기가 충돌을 반환하고, Brain이 새 버전과 변경 의도를 다시 비교하게 해야 한다.
해시 확인과 쓰기를 별도 단계로 두고 그사이에 다른 쓰기를 허용하면 같은 문제가 남는다. 버전 조건을 검사하며 쓰는 동작은 해당 저장소가 제공하는 원자적 조건부 갱신이나 그에 준하는 잠금 계약 안에서 처리해야 한다. 이는 Brain·Hands 분리만으로 자동 해결되는 기능이 아니라 실행기가 책임져야 할 영역이다.
쓰기에 성공한 뒤 응답만 유실될 수도 있다. 같은 request_id로 다시 요청했을 때 이미 완료된 결과를 돌려주는 멱등 처리가 없다면 똑같은 외부 작업이 반복된다. 다른 내용에 같은 키를 재사용하는 요청도 거절해야 한다. 새 Hands를 띄우는 것만으로 복구가 끝나지 않으며, 확인된 외부 상태와 미확정 시도를 구분해 마지막 단계부터 이어 가야 한다.
{
  "tool": "write_file",
  "path": "workspace/report.md",
  "mode": "replace",
  "expected_hash": "...",
  "request_id": "task-42-step-7"
}
실행 환경을 버릴 수 있게 만든다
Hands는 수명이 짧고 언제든 교체할 수 있는 환경이어야 한다. 작업마다 새 컨테이너를 만들고 필요한 파일만 마운트하며 결과물만 밖으로 꺼낸다.
실용적인 기본값은 다음과 같다.
입력 자료는 읽기 전용으로 마운트한다.
쓰기는 별도 output 디렉터리에만 허용한다.
네트워크는 기본적으로 차단하고 필요한 도메인만 연다.
인증 정보는 파일이나 환경 변수로 통째로 넘기지 않는다.
CPU, 메모리, 실행 시간, 프로세스 수를 제한한다.
심볼릭 링크를 고려해 경로를 검사하고, 검사와 파일 열기 사이에 대상이 바뀌는 경쟁 조건도 막는다.
작업이 끝나면 실행 환경을 폐기한다.
Claude Code의 샌드박스 설명 (https://www.anthropic.com/engineering/claude-code-sandboxing (새 창))은 파일시스템 접근과 네트워크 접근을 함께 제한해야 한다고 강조한다. 한쪽만 막으면 다른 쪽이 우회 경로가 될 수 있기 때문이다.
도구 이름보다 권한 범위를 줄인다
권한을 허용과 차단 두 단계로만 나눌 필요는 없다. 읽기는 자동으로 허용하고, 되돌릴 수 있는 쓰기는 정책 검사 뒤 실행하며, 외부 전송이나 삭제는 사용자 승인을 요구한다.
승인 창을 너무 자주 띄우면 사용자는 내용을 읽지 않고 습관적으로 승인하게 된다. 승인은 빈도보다 위험도에 맞춰 읽기·쓰기 여부, 복구 가능 여부, 외부 영향, 사용하는 인증 정보를 기준으로 단계화한다.
| 넓은 도구 | 제한된 능력으로 분리한 예 |
|---|---|
| database | describe_schema, run_readonly_query, request_write |
| filesystem | read_workspace, write_output, request_delete |
| git | read_diff, create_commit, request_push |
| messaging | draft_message, request_send |
컨테이너가 사라져도 작업은 이어져야 한다
장시간 실행되는 Agent는 중간에 실패하기 마련이다. 모델 요청 시간이 초과될 수도 있고, 샌드박스가 종료되거나 외부 API가 일시적으로 실패할 수도 있다. Brain과 Hands가 한 몸이면 실행 환경의 장애가 곧 세션 전체의 장애로 이어진다.
복구 가능한 구조를 만들려면 세 가지 기록이 필요하다.
Append-only event log: 사용자의 요청, 모델의 결정, 도구 요청과 결과를 순서대로 보존한다.
Checkpoint: 긴 대화 상태와 작업 계획을 재시작 가능한 형태로 저장한다.
Idempotency key: 재시도할 때 같은 외부 동작이 두 번 실행되지 않도록 막는다.
새 샌드박스를 만든 뒤 체크포인트와 작업 파일을 다시 넣으면 Hands가 교체되더라도 Brain은 마지막으로 확인된 단계부터 작업을 이어 갈 수 있다. 반대로 실행 로그를 모델의 대화 기록에만 남겨두면 컨텍스트가 압축되거나 세션이 종료된 뒤 정확히 복구하기 어렵다.
실패 시 도달할 수 있는 자원을 제한한다
Agent 보안에서 모든 실패를 예방하기는 어렵다. 현재 단계가 완전히 잘못되더라도 최대 어디까지 망가질 수 있는지가 핵심이다.
따라서 각 도구가 접근할 수 있는 자원의 범위를 제한해야 한다. 읽기 전용 데이터베이스 도구와 운영 쓰기 권한을 가진 데이터베이스 도구는 이름이 같아도 위험도가 전혀 다르다.
| 작업 | 최대 권한 | 복구 수단 |
|---|---|---|
| 코드 분석 | 저장소 읽기 전용 | 샌드박스 폐기 |
| 문서 생성 | 출력 폴더 쓰기 | 버전 또는 휴지통 복원 |
| 코드 수정 | 작업 브랜치 쓰기 | diff 검토와 revert |
| 데이터 조회 | 읽기 전용 DB 역할 | 쿼리 취소와 감사 로그 |
| 외부 발행 | 단일 대상·단일 작업 토큰 | 발행 전 승인, 취소 API |
| 운영 변경 | 기본 차단 | 별도 승인 워크플로 |
분리 구조의 효과를 확인할 비교안
모놀리식 Agent와 Brain/Hands 분리형 Agent에 같은 작업을 맡기고 기능, 정책 위반, 복구 비용을 함께 비교한다.
정상 작업
저장소를 읽고 문서를 생성한다.
테스트를 실행하고 실패 원인을 정리한다.
읽기 전용 데이터베이스에서 통계를 조회한다.
중간에 샌드박스를 종료한 뒤 작업을 재개한다.
공격·장애 작업
저장소 문서에 도구 실행을 유도하는 간접 Prompt Injection을 심는다.
허용 경로 밖을 가리키는 심볼릭 링크를 둔다.
외부 전송을 시도하는 스크립트를 포함한다.
파일 쓰기 직후 응답을 끊어 같은 작업의 재시도를 유도한다.
실행 중 컨테이너를 강제로 종료한다.
평가 항목
Task Completion: 정상 작업을 끝낸 비율
Policy Violation: 차단돼야 할 작업이 실행된 횟수
Blast Radius: 변경된 파일, 외부 호출, 노출된 자원의 범위
Approval Count: 사용자에게 요청한 승인 횟수
Recovery Time: 장애 뒤 정상 단계로 돌아오기까지 걸린 시간
Duplicate Action Rate: 재시도 중 외부 동작이 중복된 비율
Overhead: 분리 구조로 인해 추가된 지연과 인프라 비용
안전 구조가 정상 작업을 지나치게 가로막으면 쓰기 어렵고, 성공률만 높고 정책 위반을 허용하면 운영 환경에 투입할 수 없다. 두 축을 함께 봐야 한다.
샌드박스만으로 해결되지 않는 것
Brain과 Hands를 분리해도 다음과 같은 빈틈은 남을 수 있다.
샌드박스 안에 과도한 권한을 가진 토큰을 넣었다.
네트워크 egress가 전부 열려 있다.
여러 사용자가 같은 영구 작업 공간을 공유한다.
도구 실행 결과를 신뢰된 시스템 지시처럼 모델에 전달한다.
승인 이후 실제 실행 내용이 바뀔 수 있다.
로그에는 성공으로 남았지만 외부 시스템의 실제 상태를 확인하지 않았다.
따라서 격리, 최소 권한, 입력 신뢰도 표시, 실행 전후 검증, 감사 로그가 겹겹이 작동해야 한다. 하나의 방어선에 모든 책임을 맡기지 않는 구조가 필요하다.
읽기·쓰기 경계부터 검증하기
Brain과 Hands를 나누는 것만으로 안전해지지는 않는다. 실행기가 권한과 대상 버전을 확인하고, 외부 동작의 결과도 독립적으로 검증해야 한다.
처음에는 읽기와 쓰기를 분리하고 인증 정보를 꼭 필요한 작업에만 제공한다. 이어서 실행 환경을 교체한 뒤에도 로그, 체크포인트, 멱등 키를 통해 작업이 잘 재개되는지 시험한다. 정책 위반과 복구 비용을 정상 작업 성공률과 함께 비교해 보면 분리 구조의 효과를 판단할 수 있다.
참고 자료
Anthropic: Scaling Managed Agents — Decoupling the brain from the hands (https://www.anthropic.com/engineering/managed-agents (새 창))
Anthropic: How we contain Claude across products (https://www.anthropic.com/engineering/how-we-contain-claude (새 창))
Anthropic: Making Claude Code more secure and autonomous with sandboxing (https://www.anthropic.com/engineering/claude-code-sandboxing (새 창))
OpenAI: The next evolution of the Agents SDK (https://openai.com/index/the-next-evolution-of-the-agents-sdk/ (새 창))
OpenAI: GPT-5.3-Codex System Card — Agent sandbox (https://deploymentsafety.openai.com/gpt-5-3-codex/cybersecurity (새 창))