Phonon TTS는 왜 숫자를 다르게 읽을까: 런타임별 전처리와 날짜 해석
Phonon의 Transformers와 ptts가 숫자·기호를 다르게 처리하는 이유를 설명한다. 날짜 규칙과 언어 옵션의 범위를 코드로 확인하고, 입력 변환 오류와 음성 생성 오류를 나누는 진단 순서를 제안한다.
같은 Phonon 체크포인트에 같은 문장을 넣어도 Transformers와 전용 런타임 ptts에 들어가는 입력은 달라질 수 있다. 숫자와 기호를 읽을 말로 바꾸는 전처리 범위가 서로 다르기 때문이다. 합성된 음성이 어색할 때 모델부터 바꾸기 전에, 실제로 어떤 문자열이 토크나이저에 들어갔는지 확인할 이유가 여기에 있다.
11월 5일 Phonon 소개 (새 창)는 소형 모델의 온디바이스 합성과 Transformers 지원을 함께 다룬다. 이 글은 그중 전처리 차이와 날짜 해석의 한계를 공개 문서와 코드로 짚어 본다. 음성을 직접 합성해 비교한 실험은 아니며, 뒤에서 드는 주문 안내는 설명을 돕기 위한 가상 사례다.
같은 금액도 런타임에 따라 다른 입력으로 들어간다
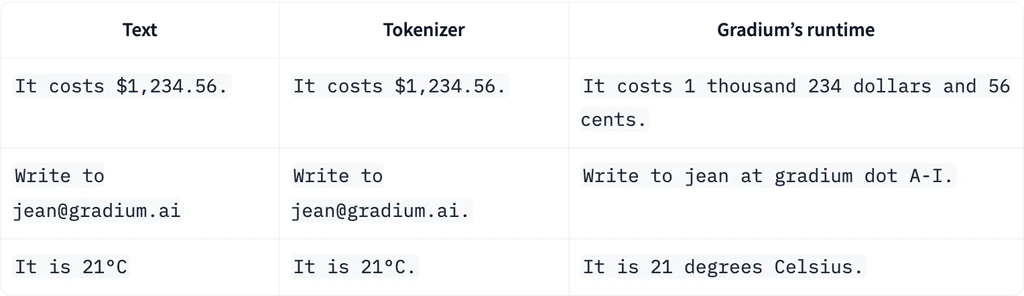
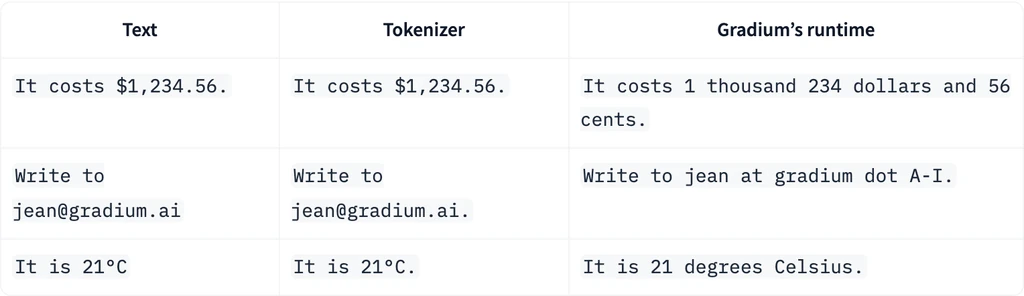
Transformers 문서 (새 창)는 문자 정리와 언어별 읽기 변환을 구분한다. 따옴표나 문장부호를 정돈하는 작업과 금액·이메일·온도를 발음할 표현으로 풀어 쓰는 작업은 다르다. 아래 공식 비교표를 보면 금액 표기가 토크나이저 열에는 그대로 남지만, 전용 런타임 열에서는 달러와 센트를 포함한 말로 바뀐다.
가상의 주문 안내에서 총액을 숫자와 통화 기호로 받는다고 해 보자. 한 경로는 이 표기를 모델에 그대로 넘기고, 다른 경로는 읽을 표현으로 바꿔서 넘긴다. 체크포인트와 목소리 파일이 같아도 조건으로 주어지는 텍스트가 다르므로, 두 결과의 차이를 곧바로 가중치나 양자화 문제로 단정할 수는 없다. 원문과 전처리 결과, 언어 설정을 먼저 함께 기록해 두면 차이가 발생한 단계를 좁힐 수 있다.
이 표는 지원하는 변환 범위를 보여 줄 뿐, 특정 문장이 반드시 잘못 발음된다는 실험 결과는 아니다. Transformers를 쓴다면 필요한 표현을 미리 풀어 쓰거나 별도 전처리를 연결할 수 있지만, 이 경우에도 서비스에서 원하는 읽기 방식부터 정해야 한다.
날짜 규칙을 기본으로 켜지 않은 이유
ptts의 고정 커밋 (새 창)을 보면 숫자·금액·이메일 같은 기본 규칙과, 기본 설정에서 빠진 전화번호·시각·날짜 규칙이 나뉘어 있다. 공백으로 나눈 단어를 판정할 때는 먼저 일치한 규칙이 결과를 반환하며, 그 결과에 다른 단어 규칙을 이어서 적용하지는 않는다. 여러 단어에 걸친 금액처럼 별도로 처리하는 항목도 있어서 전체 전처리를 단순한 정규식 한 번으로 생각하면 안 된다.
기본 규칙에서 날짜를 뺀 이유는 형태만 보고 뜻을 정하기 어렵기 때문이다. 1/2는 날짜일 수도 있고 분수일 수도 있다. 가상의 주문 안내에 배송 예정일과 재료 비율이 같은 형태의 문자열로 들어온다면, 똑같은 치환 규칙을 적용해서는 두 의미를 모두 살리기 어렵다. 입력 필드가 날짜인지 비율인지 아는 쪽에서 읽을 표현을 정하는 편이 낫다.
날짜 규칙 코드 (새 창)는 슬래시로 구분된 숫자를 하이픈과 공백으로 바꾼다. 예를 들어 코드의 테스트는 20/12/15를 20-12 15로 바꿀 것을 기대한다. 월 이름을 붙이거나 지역에 따라 월·일 순서를 해석하는 규칙은 아니다. 따라서 규칙을 켰다고 해서 날짜의 의미까지 검증했다고 볼 수는 없다. 이 관찰은 해당 커밋의 구현에 한정한 내용이다.
언어 옵션과 모델의 발화 언어는 다르다
CLI 문서 (새 창)의 --lang은 숫자와 기호를 어떤 언어 기준으로 정리할지 고르는 옵션이다. 선택할 수 있는 언어 코드가 많다고 해서 체크포인트가 그 언어를 모두 말할 수 있는 것은 아니다. 문서에는 숫자·금액·주소를 풀어 읽는 규칙의 지원 범위도 따로 명시돼 있다.
가령 영어 모델을 그대로 두고 --lang ko만 지정한다고 해서 한국어 TTS가 되지는 않는다. 전처리에 전달하는 언어와 모델이 학습한 발화 언어는 별개의 설정이다. 한국어 서비스를 만들 때는 모델이 해당 언어를 지원하는지 먼저 확인하고, 한국어 숫자·단위·고유명사를 검증할 입력도 따로 준비해야 한다.
만약 내가 이 두 경로를 비교한다면 원문 입력과 미리 풀어 쓴 입력을 같은 목소리로 각각 합성해 볼 것이다. 원문 입력에서만 차이가 크다면 전처리 단계부터 살피고, 두 입력 모두에서 차이가 남는다면 모델 버전·생성 설정·디코딩 경로를 이어서 점검할 수 있다. 이는 진단 순서에 관한 개인적인 제안일 뿐, 특정 옵션이 음질 문제를 해결한다는 측정 결과는 아니다.
첫 오디오 지연 시간과 읽기 정확도는 별개다
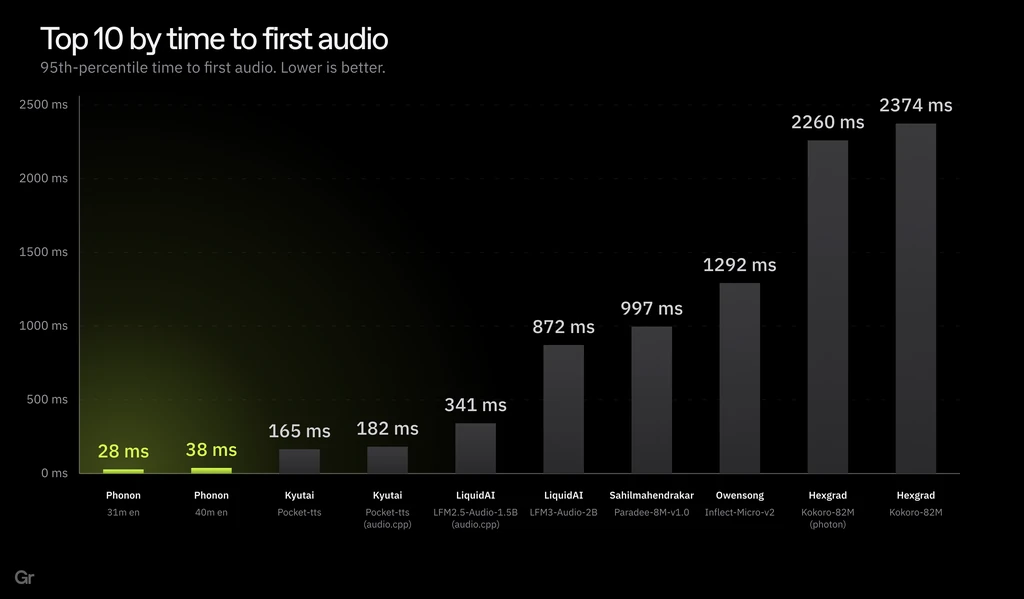
공식 소개 글의 아래 그래프는 CPU 스트리밍 비교에서 첫 오디오가 나올 때까지 걸리는 시간의 95백분위수를 보여 준다. Phonon의 두 막대는 각각 28ms와 38ms로 표시돼 있다. 이는 숫자나 날짜를 의미에 맞게 읽었는지와는 다른 지표다. 짧은 지연 시간과 정확한 발화 내용은 따로 확인해야 한다.
같은 글에서는 ptts를 온디바이스 단일 스트림용으로, Transformers를 GPU 배치 처리용으로 구분한다. 따라서 그래프의 수치를 다른 런타임이나 내 서비스의 첫 재생 시간으로 그대로 가져다 쓸 수는 없다. 원자료의 CPU 스트리밍·95백분위 조건을 그대로 두고 봐야 하며, 실제로 비교할 때는 전처리와 재생 준비 과정을 측정 구간에 포함했는지도 밝혀야 한다.
그래프 출처 (새 창). 이 글에서는 해당 벤치마크를 직접 재현하지 않았다.
원문과 실제 합성 입력을 함께 보관한다
주문 안내를 검증한다면 금액, 배송일, 주문번호, 이메일을 각각 다른 사례로 묶어 테스트할 것이다. 똑같은 숫자열이라도 금액은 수량으로 읽고 주문번호는 식별자로 읽어야 할 수 있다. 기대하는 발화 형태를 먼저 정한 뒤 전처리 결과와 실제 음성을 대조하면, 문자열 변환 오류와 음성 생성 오류를 구분하기 쉬워진다.
운영 로그에는 원문 전체를 무조건 쌓기보다, 개인정보를 뺀 재현용 입력과 런타임·모델·언어·전처리 설정을 함께 남기는 방식이 적절하다. 이미 변환된 입력을 다시 변환하는 경우도 별도 사례로 분류해 확인한다.
Phonon을 다른 환경으로 옮겨 붙일 때 챙겨야 할 것은 모델 파일만이 아니다. 어떤 표기를 어떤 말로 읽기로 했는지, 그 결정을 어느 단계에서 내렸는지도 함께 옮겨야 한다. 음질을 비교하기에 앞서 두 경로가 같은 뜻의 문장을 합성하고 있는지부터 확인한다.