BERT 토크나이저는 무엇을 건너뛸까: ASCII 빠른 경로와 한글 정규화
É와 한글 가의 NFD 분해, ASCII 비트 연산 반례로 BERT 정규화의 빠른 경로를 설명한다. 같은 토큰을 유지하는 조건과 전체 요청에서 얻는 성능 이득을 구분한다.
토크나이저를 빠르게 만든다는 말은 문자를 덜 읽거나 토큰을 줄인다는 뜻일까. BERT 정규화 최적화는 같은 결과를 내면서 불필요한 유니코드 판정을 생략하는 쪽에 가깝다. 하지만 ASCII 구간을 빠르게 넘기더라도 대문자와 공백 처리는 여전히 필요하다.
이 글에서는 문자 변환, 빠른 경로의 조건, 전체 지연의 손익을 차례로 살핀다. 아래 문자 예제는 Python 표준 유니코드 함수로 확인했으며, 제안된 Rust 토크나이저나 한국어 검색 서비스를 벤치마크한 결과는 아니다.
같은 글자처럼 보여도 코드 포인트는 다를 수 있다
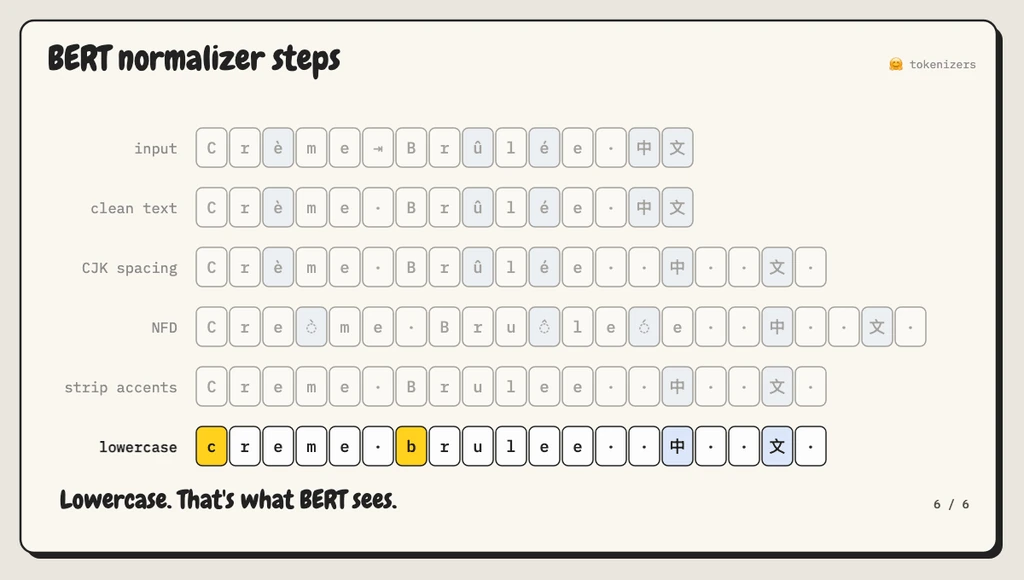
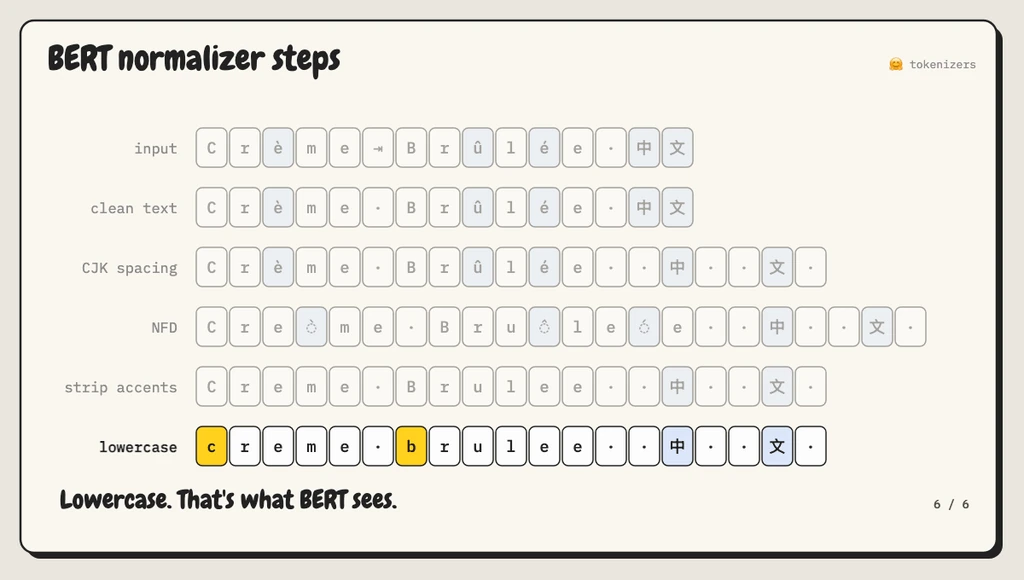
Tokenmaxxing BERT (새 창)는 uncased BERT의 정규화를 공백·제어문자 정리, 한자(중국 문자) 간격 띄우기, NFD 분해, 악센트 제거, 소문자화 순서로 설명한다. 이 과정은 WordPiece가 어휘에서 토큰을 고르는 단계보다 앞서 진행된다. 설정이 다르면 적용하는 변환도 달라지므로 모든 모델에 같은 규칙을 강제할 수는 없다.
가령 É는 U+00C9 하나로 표현된다. 이를 NFD로 분해하면 E와 결합 악센트 U+0301이 되며, 악센트를 제거하고 소문자화하면 e가 된다. 처음부터 E와 결합 악센트로 입력한 경우에도 같은 순서를 거치면 동일한 결과에 도달한다. 화면에 보이는 글자 수와 내부 코드 포인트 수가 다르다는 점이 정규화 비용과 결과를 이해하는 출발점이다.
한글 '가'는 NFD에서 초성 U+1100과 중성 U+1161로 나뉜다. 두 자모는 결합 악센트와 같은 범주가 아니므로 “분해된 문자는 모두 지운다”는 식의 구현은 틀리다. 이 예시는 문자 처리 규칙의 차이를 보여 줄 뿐, 한글의 최종 토큰 ID나 검색 품질을 예측하지 않는다. 아래 원자료 그림은 하나의 입력에 각 처리를 누적해 적용한 단계다.
ASCII 확인과 대문자 변환은 별도 조건이다
원문은 UTF-8 바이트의 최상위 비트로 ASCII 구간을 찾고 여러 바이트를 한꺼번에 검사하는 빠른 경로를 설명한다. 일반 유니코드 분해나 범주 조회가 필요 없는 구간은 건너뛸 수 있지만, 탭을 공백으로 바꾸거나 A를 a로 바꾸는 BERT 규칙까지 사라지는 것은 아니다.
간단한 비트 계산으로 경계를 살펴보자. A는 65이고 32와 비트 OR 연산을 하면 97, 즉 a가 된다. 그러나 이 연산을 모든 ASCII에 적용하면 값 91인 [는 123이 되어 {로 바뀐다. 따라서 A–Z 범위인지 먼저 판정한 뒤 해당 위치에만 변환을 적용해야 한다. “ASCII니까 전부 그대로”와 “ASCII니까 전부 소문자 비트 적용”는 둘 다 잘못된 일반화다.
비ASCII에는 문자 영역 단위로 정규화 가능성을 기억하는 캐시를 쓴다. 같은 문자권이 반복되면 매번 큰 표를 검색하는 대신 이미 계산해 둔 판정을 읽을 수 있다. 다만 캐시를 처음 채우는 작업도 필요하므로 짧은 입력이나 다양한 문자권이 섞인 경우의 비용은 따로 확인해야 한다.
빠른 경로의 이득은 입력 분포가 결정한다
원문은 영어·코드에서는 큰 이득을 보였지만, 중국어와 매우 짧은 입력에서는 이득이 작거나 퇴행이 나타나는 조건도 함께 보고한다. 영어에 ASCII가 많다는 관찰을 한국어에 그대로 옮길 수는 없으며, 한글과 중국어의 정규화 과정도 같지 않다.
가상의 입력 묶음에서 긴 영문 로그와 짧은 한글 질의를 하나의 평균으로 합치면 실제 사용자가 겪는 퇴행이 가려질 수 있다. 문자 비중이 같더라도 길이와 연속 구간의 배치가 다르면 빠른 경로 진입과 출력 버퍼 할당 횟수가 달라질 수 있다. 정상 영문, 대문자·탭 포함 입력, 결합 악센트, 한글 자모, 혼합 오류 코드를 별도 묶음으로 비교할 이유가 여기에 있다.
이미 정규화된 입력을 그대로 반환하는 최적화 역시 가능한 경우에는 복사와 할당을 줄여 준다. 하지만 한 문자라도 바뀌면 출력 문자열을 새로 만들고 원래 위치와의 대응을 보존할 필요가 생긴다. 토큰 내용만 같으면 되는지, 원문 위치를 가리키는 오프셋까지 같아야 하는지는 결과를 소비하는 기능에 맞춰 확인한다.
정규화가 빨라진 배율과 요청이 빨라진 배율을 구분한다
가정상 전체 요청 100ms 중 토크나이저가 20ms를 차지한다면, 이 부분이 5배 빨라져도 전체 시간은 80+20/5=84ms다. 약 1.19배의 개선이며, 토크나이저 시간이 완전히 사라져도 하한은 80ms다. 모델 추론과 검색에 쓰는 시간이 남기 때문이다.
반면 대량 색인 작업에서 CPU 전처리가 병목이라면 같은 최적화의 가치가 더 클 수 있다. 온라인의 짧은 질의 응답 시간과 오프라인 문서 처리량을 구분하고, 같은 스레드·배치·입력·정규화 설정으로 비교해야 분모가 맞는다. 위 시간은 설명용 계산이며 원문 벤치마크의 서비스 환산값이 아니다.
최적화 PR #2508 (새 창)은 확인 시점에 Draft 상태로 표시되어 있다. 따라서 PR의 성능 수치를 일반 설치 버전의 성능으로 간주할 수는 없다. 사용할 패키지 버전과 변경 커밋을 구분하고, 실제 설치한 구현에 빠른 경로가 포함되어 있는지 확인한다.
속도를 재기 전에 같은 입력이 같은 토큰으로 가는지 확인한다
최적화 전후에는 같은 어휘·정규화 설정·최대 길이·특수 토큰 정책을 고정한다. 토큰 ID뿐 아니라 필요한 경우 attention mask, 토큰 경계, 원문 오프셋도 대조한다. é와 e에 결합 악센트를 붙인 입력, 탭과 줄바꿈, 빈 문자열, 대괄호 같은 반례는 빠른 경로가 건너뛰면 안 되는 처리를 드러낸다.
이 글에서 실행한 표준 함수 검사는 É의 분해·악센트 제거·소문자화와 '가'의 NFD 자모, ASCII 비트 계산만 확인했다. 최적화 브랜치의 토큰 출력 동일성이나 한국어 성능은 검증하지 않았다. 이를 판단하려면 같은 입력 묶음을 양쪽 구현에 넣는 별도 비교가 필요하다.
좋은 빠른 경로는 중요하지 않은 문자를 지우는 규칙이 아니다. 어떤 입력에서 어떤 판정이 결과를 바꾸지 않는지 확인하고 그 작업만 생략하는 규칙이다. 결과의 동일성을 먼저 확인한 뒤, 남아 있는 전체 병목 안에서 절약의 크기를 판단한다.