HopRAG가 잘못된 근거로 이동할 때: 간선 연결과 버전 검증
유사한 질문으로 만든 간선이 실제 업무 관계를 보장하지 않는 이유와, 최종 근거 예산을 고정한 비교 방법을 설명한다.
간접 관련 문단에서 다음 근거 찾기
유사도와 논리적 관련성의 차이
질문과 문장이 유사한 것과 그 문장이 답에 필요한 근거인 것은 별개일 수 있다. HopRAG는 여러 근거를 연결해야 하는 멀티홉 검색에서 이 간극을 해결한다. 논문의 BGE 실험에서는 top-k를 늘려도 recall이 약 0.45 부근에서 정체되었다.
핵심 메커니즘은 다음과 같다. 검색된 패시지 상당수는 질문과 간접적으로 관련된(indirectly relevant) 상태다. 이런 패시지를 진짜 근거로 가는 징검다리 삼아 그래프 홉(hop)으로 연결하면 정답 근거에 도달할 수 있다.
색인과 질의의 두 단계
문단별 질문 생성과 방향성 간선 연결
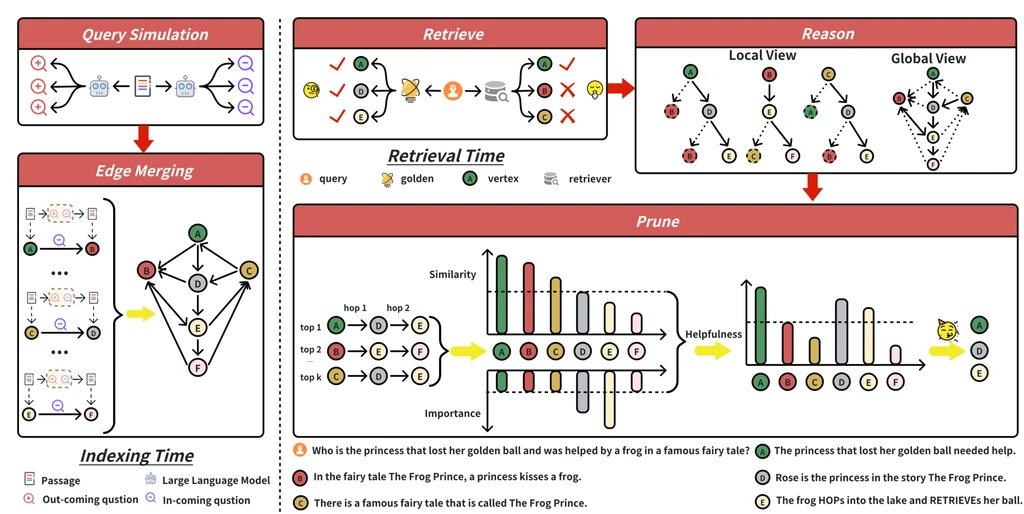
Query Simulation: 각 쿼리마다 sparse(NER 키워드)와 dense(임베딩) 표현을 모두 생성한다.
Edge Merging: Out-coming triplet(Q⁺)과 In-coming triplet(Q⁻)을 하이브리드 유사도로 매칭해 방향성 간선을 생성한다. 간선은 "A가 제기하는 질문에 B가 답할 수 있다"는 후보 관계를 나타낸다. LLM이 생성한 질문과 유사도 매칭에 의존하므로 실제 문맥에서 관계가 유효한지 확인해야 한다.
검색·관계 추론·근거 선별
1단계 Retrieve: 하이브리드 검색으로 질문과 유사한 top-k 간선을 찾고, 도착 패시지를 확보해 Cqueue 초기값으로 넣는다.
2단계 Reason (BFS + LLM): 각 정점(vertex)의 출력 간선에 달린 질문을 LLM에 제시해 원래 쿼리에 답하는 데 필요한지(Irrelevant / Indirectly / Relevant) 판단한다. 가장 유용한 간선으로 이동(hop)하며 새 정점을 큐에 추가한다. 이 과정을 nhop 라운드만큼 반복하며 방문 횟수를 Ccount에 기록한다.
3단계 Prune: Helpfulness 점수로 재랭킹한 뒤 상위 top-k만 최종 컨텍스트로 선택한다.
논문 조건의 답변 F1 비교
dense retriever(BGE) 대비 상대 향상률 +76.78%(%p 차이가 아님), reranking 대비 +36.25%, SiReRAG 대비 약 +1.11%(추가 노드 없이 달성)를 기록했다. top-12만 사용해도 RAPTOR/HippoRAG의 top-20과 대등해 컨텍스트 효율성이 높다.
| 종류 | 의미 | 예시 |
|---|---|---|
| In-coming (Q⁻) | 이 passage가 답이 되는 질문 | "이 동화의 공주 이름은?" |
| Out-coming (Q⁺) | 이 passage에서 파생되지만 답이 없는 질문 | "개구리와 Rose의 관계는?" |
passage A의 Q⁺ ─────매칭────→ passage B의 Q⁻
          └──────엣지 생성──────┘
(A → B, edge label = Q⁻)Helpfulness(v) = (textual_similarity(v, q) + importance(v)) / 2
importance(v) = visit_count(v) / total_visits파이프라인 구조와 구현 도구
전체 파이프라인 설계
구현 시 주요 고려사항
인덱싱 비용 관리: 가장 비용이 큰 부분은 패시지당 LLM 호출(Q simulation)이므로 배치 처리와 비동기 병렬화가 필수다. 간선 매칭은 FAISS 등 ANN으로 근사 처리할 수 있다.
그래프 저장 구조: 각 간선에 쿼리 텍스트, 키워드 집합, 임베딩 벡터를 함께 저장한다. 검색할 때 간선 단위로 찾아야 하므로 간선 인덱스를 별도로 관리한다.
탐색(Traversal) 구현: BFS 큐에서 같은 정점을 다시 방문할 때는 재탐색 없이 방문 횟수(count)만 늘린다. 논문에서 5번째 홉의 평균 큐 길이는 1.23이었으며, nhop=4는 실험 설정값이다. 같은 라운드의 정점들은 독립적으로 LLM을 병렬 호출할 수 있다.
[Corpus]
   │
   ▼
[Chunking] → 데이터셋 특성에 맞는 단위 (문장/단락)
   │
   ▼
[Query Simulation] → LLM으로 in/out-coming questions 생성
   │                  (최소 Q⁻ 2개, Q⁺ 4개 per passage)
   ▼
[Representation]
  ├─ Sparse: NER → keyword extraction
  └─ Dense: Embedding model → vector
   │
   ▼
[Edge Merging]
  ├─ 모든 out-coming triplet vs in-coming triplet 매칭
  ├─ Hybrid SIM = (Jaccard + cosine) / 2
  └─ O(n·log n) 엣지만 유지 (밀도 제어)
   │
   ▼
[Graph DB] → Neo4j 또는 유사 그래프 DB
  ├─ Vertex: passage text + in/out-coming triplets
└─ Edge: matched query + keywords + embedding| 컴포넌트 | 논문 설정 | 경량 대안 |
|---|---|---|
| Query Generation LLM | GPT-4o-mini | Qwen2.5-7B, Llama3 |
| Traversal LLM | GPT-4o-mini | Qwen2.5-1.5B (성능 차이 적음) |
| Embedding | BGE-base 768dim | BGE-small, E5 |
| NER | PaddleNLP POS | spaCy, NLTK |
| Graph DB | Neo4j | NetworkX (소규모), Memgraph |
| Reader LLM | GPT-4o / GPT-3.5 | 로컬 LLM 가능 |
검증이 필요한 개선 후보
간선 매칭과 갱신 비용 절감
현재 한계: 패시지 수 N에 대해 간선 매칭은 잠재적으로 O(N²) 복잡도를 가진다.
개선안: 의미상 유사한 클러스터 안에서만 간선을 탐색하는 로컬 매칭, 새 문서를 추가할 때 전체를 재구성하지 않고 반영하는 증분 인덱싱, 유사도 임계값 이하인 간선을 미리 제거하는 품질 필터링을 적용할 수 있다.
탐색 폭과 종료 조건 개선
현재 한계: 매 단계에서 간선을 하나만 선택하는 탐욕적(beam=1) 탐색을 수행한다.
개선안: 각 홉에서 상위 B개 경로를 동시에 탐색하는 Beam Search, 쿼리에서 역방향 탐색을 병행하는 양방향 BFS, 쿼리 복잡도에 따라 홉 수를 조절하는 Adaptive nhop, 간선 생성 시 LLM 신뢰도를 저장해 탐색 우선순위에 반영하는 방식을 검토할 수 있다.
유사도·방문 수·중복 가중치 조정
현재 한계: 텍스트 유사도와 방문 횟수를 단순 평균해 점수를 매긴다.
개선안: 질문 유형(단답형, 비교형, 인과형 등)별 가중치 조정, 유사한 패시지가 중복 선택되는 것을 억제하는 MMR 적용, 깊은 홉에 있는 패시지의 신뢰도 감쇠(discount) 적용이 가능하다.
도메인 확장 검증
현재 한계: 멀티홉 QA 벤치마크에서만 검증되었다.
개선안: 법률(조항 단위), 의료(개념 단위), 코드(함수 단위) 등 도메인별로 청킹 전략을 분리하고, 이미지-텍스트 간선이나 시간적 선후 관계 간선을 추가하는 확장을 실험할 수 있다.
탐색 모델 비용과 지연 단축
현재 한계: nhop=4, topk=20 기준 질문당 평균 38.53회 LLM을 호출한다.
개선안: 논문에서 GPT-4o-mini에 근접한 성능을 보인 Qwen2.5-1.5B 등 로컬 소형 모델에 탐색을 전담시킨다. 자주 방문하는 정점의 추론 결과 캐싱(질문·모델 변경 시 유효성 확인 필요), 관련 패시지 확보 시 조기 종료(Early stopping), vLLM + GPTQ 조합(논문 기준 18.86초 → 4.43초 단축)을 적용할 수 있다.
그래프 구조 가설
논문은 패시지 그래프의 차수(degree) 분포가 멱법칙(power-law)을 따르지 않는다고 보고한다. 단, small-world 특성과 멱법칙 분포는 별개 조건이며, O(n·log n) 간선 제약이 원인이라고 입증된 것도 아니다. 허브 노드 추가나 커뮤니티 탐지가 도달 홉 수를 줄이는지는 별도 실험이 필요하다.
도입 판단 기준
기본 검색이 놓친 질문에서 그래프 탐색이 실제로 정답 근거를 회수하는지부터 확인한다. 그다음 로컬 소형 탐색 모델이나 vLLM 조합을 동일한 코퍼스·정확도 기준에서 비교한다. 호출 비용을 낮추더라도 잘못된 간선을 따라가 답변 품질이 떨어지면 도입 이득이 없다.
가상의 제품 문서 A가 “P2의 지원 정책은 무엇인가”라는 질문을 만들고, 문서 B가 P1의 지원 기간에 답한다고 하자. 표현이 비슷해 간선 후보로 연결되더라도 제품 버전이 다르면 P2 질문의 근거가 될 수 없다. 관계가 연결됐다는 사실과 그 관계가 현재 질문에 유효하다는 판단은 구분해야 한다. 이 예시는 논문에서 보고한 실제 실패 사례가 아니라 도메인 적용 시 검사할 반례다.
문서 ID·제품 버전·효력 시점을 간선의 원자료와 연결하고, 검색된 경로가 동일한 대상과 시점을 유지하는지 확인한다. 최종 답이 틀렸을 때는 초기 검색의 누락, 잘못된 간선, 탐색 판단, 마지막 가지치기 중 어디에서 정답 근거가 사라졌는지 추적한다. 방문 횟수가 많다는 사실만으로 잘못 연결된 인기 문서가 신뢰할 근거로 바뀌지는 않는다.
비교할 때는 동일한 최종 컨텍스트 예산에서 초기 검색 후보만 늘린 조건과 그래프를 탐색한 조건을 나란히 두고 본다. 그래프 내부에서는 더 많은 후보를 살필 수 있으므로, 이때 발생하는 추가 검색·LLM 비용도 함께 기록한다. 정답 근거 회수는 늘었지만 전체 지연이 예산을 넘는다면, 특정 질문 유형에만 적용하거나 더 작은 탐색 모델을 쓰는 후보를 별도로 시험한다.
참고 자료
HopRAG: Multi-Hop Reasoning for Logic-Aware Retrieval-Augmented Generation (https://arxiv.org/abs/2502.12442 (새 창))