CoPE는 한 행동에서 어떻게 더 배우나: 미래 행동 예측과 성공 경로의 편향
CoPE에서 한 행동이 여러 과거 입력의 정답이 되는 과정을 계산한다. 성공 필터가 어려운 작업의 학습 기회를 줄이는 이유와 표본 효율·전체 시간의 차이를 짚는다.
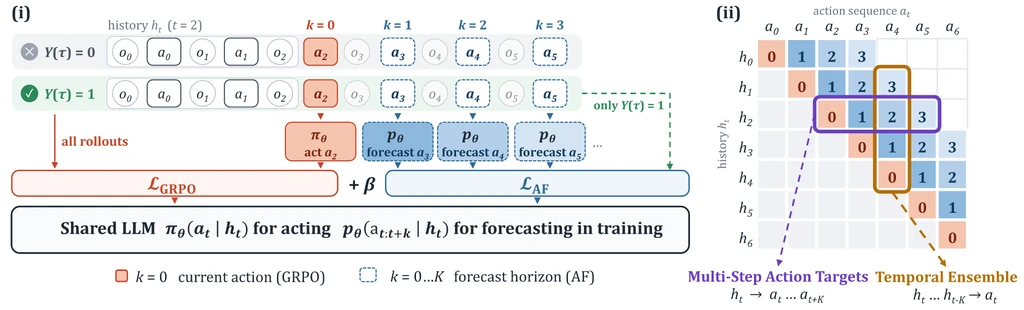
성공한 실행 기록 하나에서 에이전트가 더 많이 배우게 할 수 있을까. CoPE는 같은 행동을 실제로 선택한 시점뿐 아니라 그보다 앞선 시점에서도 예측하도록 학습한다. 긴 로그를 그대로 재현하는 대신, 행동이 이어지는 흐름을 학습 신호로 삼는 방식이다.
작은 예제를 통해 행동 묶음과 학습 신호 수, 성공 필터의 분모를 따라가 보자. 아래 계산은 이해를 돕기 위한 가정일 뿐, 에이전트를 다시 학습하거나 논문의 성능을 재현한 결과는 아니다.
보조 목표는 앞으로 이어질 행동이다
10월 14일 제출된 CoPE 논문 (새 창)은 그룹 내 보상 차이로 정책을 갱신하는 GRPO에 행동 예측 손실을 더한다. 현재 정책으로 수집한 경로 가운데 성공한 경로에서 각 시점 이후의 행동 묶음을 뽑아낸다. 행동을 선택할 때와 예측할 때 같은 LLM 본체를 공유하며, 예측 시에만 별도의 지시를 덧붙인다.
방법 절 (새 창)에서는 중간 관측을 예측 입력에 하나씩 추가하지 않고 앞으로 이어질 행동을 맞히게 한다. 반면 배포 시에는 현재 관측을 보고 행동을 하나씩 선택한다. 학습할 때 미래 행동 묶음을 예측한다고 해서, 배포 시 그 묶음을 도구에 한꺼번에 실행하는 구조는 아니다.
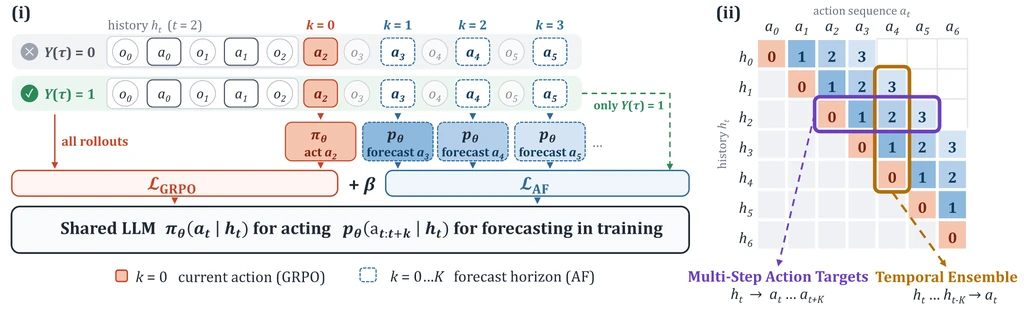
한 행동이 여러 과거 시점의 정답이 된다
예측 범위를 K=2로 두면 현재 행동을 포함해 최대 세 행동을 예측한다. 아래는 긴 성공 경로를 단순화한 예시다. h는 그 시점까지 본 관측과 이전 행동의 기록이고, a는 실제로 이어진 행동이다.
길이가 5인 경로 a0부터 a4까지에서 경로 끝을 넘어가지 않게 묶음을 자르면, 각 시점의 정답 행동 수는 3, 3, 3, 2, 1로 총 12개가 된다. 현재 행동만 예측할 때의 5개와 비교하면 정답으로 등장하는 횟수가 2.4배로 늘어난다. 하지만 환경과의 새로운 상호작용을 12번 수집한 것은 아니다. 정답이 서로 겹치므로 독립 표본 수까지 2.4배가 되었다고 해석할 수는 없다.
| 학습 입력 | 예측할 행동 |
|---|---|
| h0 | a0 → a1 → a2 |
| h1 | a1 → a2 → a3 |
| h2 | a2 → a3 → a4 |
예측에 쓰는 정보와 실행에 쓰는 정보
표에서 a2는 세 입력의 정답에 걸쳐 있다. h0에서 a2를 예측할 때는 h2까지의 새 관측을 아직 보지 못한 상태이므로, h2에서 같은 행동을 선택할 때와 정보 조건이 다르다. 이 차이를 유지해야 여러 시점의 학습을 단순한 동일 표본 복제와 구분할 수 있다.
재현 실험을 설계할 때는 예측용 기록에 미래의 관측이 잘못 섞이지 않았는지 먼저 대조해야 한다. 학습 중 미래 행동을 정답으로 주는 것과 미래 관측을 입력에 넣는 것은 전혀 다른 일이다.
고객 계정을 조회한 뒤 잔액에 따라 환불하거나 추가 확인을 요청하는 상황을 생각해 보자. 조회 전 기록만으로 미래의 환불 행동을 예측하는 모델은 아직 조회 결과를 모른다. 성공 경로에서 환불이 이어졌다는 사실을 정답으로 배우더라도, 실제 배포 환경에서는 새로 확인한 잔액에 맞춰 행동해야 한다. 예측 결과를 실행 계획으로 고정해 버리면 관측에 따라 갈라져야 할 분기를 잃게 된다.
성공 경로가 없는 작업도 따로 세어야 한다
작업의 성공 조건이 개별 행동의 완벽함을 보증하지는 않는다. 고객 지원 업무에서 전체 요청을 해결했더라도 불필요한 조회를 반복했을 수 있으며, 성공 여부만 보고 이런 반복이 사라지기를 기대하기는 어렵다. 따라서 성공 검사기와 별개로 경로의 품질을 따로 평가해야 한다.
논문 5.2절 (새 창)의 보조 손실은 그룹 내 성공 경로 수로 평균을 낸다. 한 그룹에서 성공 경로가 0개라면 그 그룹에서 얻는 행동 예측 항도 0이 된다. 그렇다고 GRPO 학습 전체가 멈추는 것은 아니지만, 쉬운 작업에서만 성공이 집중되는 상황이라면 전체 평균뿐 아니라 작업별 성공 경로 수도 함께 확인해야 한다.
판단을 보류할 근거도 원문에 나타나 있다. Qwen2.5-7B-Instruct로 평가한 τ²-bench의 Avg@4 전체 성공률은 GRPO 27.5%에서 CoPE 28.7%로 올랐지만, Airline 도메인에서는 26.2%에서 16.2%로 낮아졌다. 평가 표 1 (새 창)의 평균 수치만 보고 모든 업무에 유익하다고 단정할 수는 없다.
가상으로 그룹 크기가 8이고 각 경로가 독립적으로 성공할 확률이 p라고 하면, 보조 학습 신호를 하나라도 얻을 확률은 1−(1−p)^8이다. p=0.5일 때는 약 99.6%에 달하지만 p=0.01일 때는 약 7.7%에 그친다. 실제 생성된 경로들이 서로 비슷하다면 독립 가정도 맞지 않을 수 있다. 같은 그룹 예산을 쓰더라도 어려운 작업에서는 성공 행동을 배울 기회가 훨씬 적을 수 있다는 뜻이다.
성공 경로 수로 나누는 정규화는 성공이 1개뿐인 그룹의 손실을 전체 경로 수인 8개로 나누어 신호가 약해지는 현상을 막아 준다. 하지만 그 1개의 경로가 작업 전체를 대표하는 것은 아니다. 성공 횟수가 적을수록 우연히 맞아떨어진 행동 순서를 반복해서 배우고 있지는 않은지 살펴볼 필요가 있다.
학습 표본 절약과 전체 비용은 나눠 봐야 한다
배포 시 예측을 위한 호출을 추가하지 않는다고 해서 학습 비용까지 동일한 것은 아니다. 성공 경로에서 보조 학습을 수행하는 계산과 환경에서 새로운 실행을 수집하는 비용은 별개로 남는다. 따라서 같은 보상에 도달하기까지의 학습 단계 수와 실제 소요 시간을 분리해서 비교해야 한다.
고객 지원 환경에 적용한다면 기본 GRPO, 현재 행동만 예측하는 보조 목표, 여러 행동을 예측하는 목표를 같은 예산 아래에서 비교해야 한다. 실패가 잦은 업무와 도구 오류가 발생하는 업무도 따로 확인한다.
가상으로 기존 학습 한 단계에 환경 수집 80초와 갱신 20초를 합쳐 100초가 걸린다고 해 보자. 여기에 예측 보조 계산이 10초 추가되고 수집 시간이 그대로라면 한 단계는 110초가 된다. 같은 점수에 도달하는 단계 수가 절반으로 줄어들어야 전체 소요 시간이 기존의 55%로 단축된다. 만약 단계 수가 그대로라면 시간은 오히려 10% 더 걸린다. 이는 논문의 실제 측정치가 아니라 표본 효율과 시간 효율을 구분해 본 가상 계산이다.
같은 성공 기록에서 무엇을 더 배우는지 확인하기
CoPE를 검토할 때는 성공률뿐만 아니라 예측 입력의 시점, 작업별 성공 경로 수, 도메인별 성능 저하도 함께 확인해야 한다. 보조 손실을 더해 평균 성능이 올랐다는 결과에 그치지 않고, 어떤 기록이 학습에 기여했으며 어떤 작업이 신호를 얻지 못했는지까지 살펴야 적절한 적용 범위를 정할 수 있다.