HLA는 과거 기억을 어떻게 다시 읽나: 청크 변환과 건너뛰기의 오차
HLA가 청크의 새 정보와 기존 기억의 변환을 함께 조절하는 이유를 계산한다. 시간순 합성, 가중치 임계값의 오차, 문맥 길이에 따른 저장량을 구분한다.
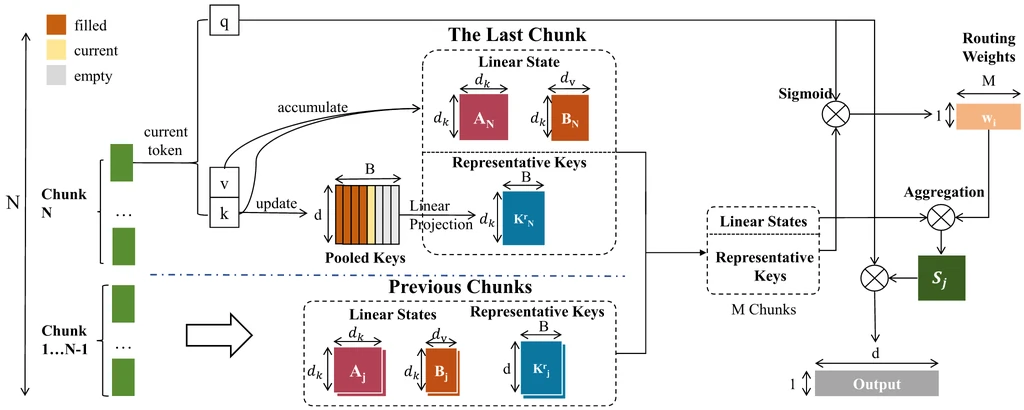
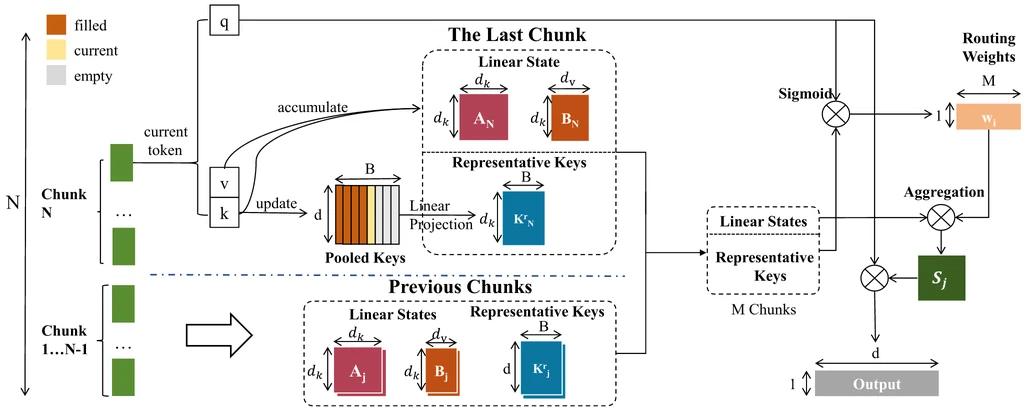
긴 문맥을 읽은 LLM이 앞부분 정보를 놓치는 이유는 무엇일까. 과거를 압축해 저장하는 선형 어텐션에서는 새 정보를 쓰는 과정이 이전 메모리까지 바꾼다. HLA는 현재 질문에 맞춰 과거 문맥의 영향력을 다시 조절하므로, 무엇을 더 저장하는지뿐 아니라 무엇이 기존 기억을 바꾸는지도 함께 살펴야 한다.
아래 수치 예제는 원리를 설명하기 위한 가정이며, 해당 모델의 학습이나 하드웨어 성능을 직접 실험한 결과는 아니다.
새 정보를 쓰면서 이전 기억도 바뀐다
10월 5일 제출된 HLA 논문 (새 창)은 Gated DeltaNet(GDN)의 메모리 갱신을 문맥 묶음인 청크 단위로 다룬다. 각 청크는 S′=AS+B로 요약된다. 여기서 S는 들어오는 메모리, A는 이전 메모리를 바꾸는 변환, B는 새로 더하는 정보다.
HLA는 질문과 청크의 대표 키를 비교해 가중치 w를 구한다. 과거 청크를 시간순으로 합성하되 A를 (1−w)I+wA로, B를 wB로 바꾼다. I는 입력을 그대로 돌려주는 항등변환이다. w=0이면 이전 메모리를 보존하고, w=1이면 원래 갱신을 적용한다. 현재 청크는 미래 토큰을 참조하지 않는 범위에서 원래 갱신식을 따른다. 저자 설명 (새 창)에서도 두 항을 함께 조절하는 이유를 확인할 수 있다.
가상으로 S=10, A=0.5, B=2이고 w=0.2라면 조절된 변환은 0.8+0.2×0.5=0.9, 새 정보는 0.4가 되어 결과는 9.4다. 반면 B만 줄이면 0.5×10+0.4=5.4가 된다. 두 항을 함께 조절하는 이유는 새 정보를 덜 쓰는 데 그치지 않고 기존 기억도 덜 바꾸기 위해서다.
새 정보만 줄이면 이전 기억은 보존될까
갱신식을 단일 숫자로 단순화해 비교해 보자. 이전 메모리 S=10, 변환 A=0.5, 새 정보 B=2로 두고, 해당 청크가 질문과 무관해 w=0이라고 판단했을 때를 계산한다. 실제 모델에서 A와 S는 행렬이며, 아래 숫자는 정확도나 메모리 용량을 뜻하지 않는다.
| 갱신 방법 | w=0일 때 결과 |
|---|---|
| B만 줄임: AS+wB | 0.5×10+0×2=5 |
| 두 항 조절: [(1−w)+wA]S+wB | [(1−0)+0×0.5]×10+0×2=10 |
청크를 건너뛴다는 말의 정확한 범위
위 예시는 새 정보의 기여를 없애더라도 기존 메모리를 바꾸는 효과는 남는다는 차이를 보여준다. HLA를 검토할 때는 라우팅 점수가 어느 청크를 골랐는지만 볼 것이 아니라, 그 선택이 이전 정보에 가하는 변환도 확인해야 한다. 중요한 문장이 앞에 나오고 관련 없는 문장이 뒤따르는 입력을 별도로 평가할 필요가 있다.
논문은 추론 시 0.1 미만의 가중치를 0으로 만든다. 이는 연속 가중치 모델에 대한 근사다. 이후 가중치가 0이 된 청크의 항등변환을 생략하는 계산은 임계값을 적용한 모델 안에서만 정확하다. 따라서 “건너뛰어도 정확하다”는 설명을 원래의 연속 가중치 모델과 출력이 같다는 뜻으로 확대 해석해서는 안 된다. 방법 절 (새 창)에 나온 두 단계를 구분해서 봐야 한다.
청크 순서 문제도 남는다. 가상 변환 F1(S)=0.5S+2, F2(S)=2S+1을 S=10에 적용하면 F2(F1(10))=15지만, 순서를 바꾸면 F1(F2(10))=12.5가 된다. 청크 가중치를 구한 뒤 임의 순서로 더하는 연산과 시간순으로 변환을 합성하는 연산은 다르다.
임계값에 따른 차이도 직접 계산할 수 있다. 앞선 S=10, A=0.5, B=2에 w=0.09를 적용하면 9.73이 되지만, 0.1 미만을 0으로 만들면 10이 된다. 청크 생략은 임계값을 적용한 뒤에는 항등변환을 생략하는 것과 같지만, 원래의 연속 가중치 결과와는 0.27 차이가 난다. 뒤이은 변환이 이 차이를 키울 수도 있고 줄일 수도 있다.
평균 점수 상승과 긴 문맥 해결을 구분하기
논문 표 1 (새 창)은 1.3B 규모 모델을 100B 토큰·4K 문맥으로 처음부터 학습한 조건을 다룬다. 32K RULER 평균은 GDN이 3.65, HLA가 7.87이다. 평균은 올랐으나 절대 점수가 낮고 개별 과제에서는 오히려 점수가 떨어진 경우도 있어, 모든 긴 문맥 문제를 해결했다고 보기는 어렵다.
적용을 검토할 때는 평균 점수와 함께 실패 유형을 나눠 봐야 한다. 기술 문서에서 단일 설정값을 찾는 경우, 여러 절의 조건을 함께 읽어야 하는 경우, 앞에서 정의한 값을 뒤에서 수정하는 경우를 비교하는 식이다. 첫 번째 유형에서 좋은 점수가 나오더라도 나머지 두 유형의 근거를 놓친다면 업무 적용을 보류해야 한다.
청크별 요약과 대표 키를 남기는 구조에는 문맥 길이에 따라 저장할 항목이 늘어나는 대가가 따른다. 기본 선형 어텐션의 고정 크기 상태와 HLA의 전체 저장량을 같게 취급할 수는 없다. 라우팅, 상태 합성, 메모리 읽기 비용을 포함해 같은 하드웨어에서 첫 응답 지연과 이후 토큰 생성 지연을 나누어 측정하고 비교해야 한다.
가상으로 청크 길이를 128토큰으로 고정하면 4,096토큰은 32개, 32,768토큰은 256개 청크가 된다. 청크당 저장량이 같더라도 청크별 요약 저장량은 8배로 늘어난다. 실제 바이트 수는 헤드 수·차원·정밀도·저장 구현에 따라 달라지므로, 이 계산이 전체 GPU 메모리의 배수를 뜻하지는 않는다.
다음 실험에서는 변환과 선택을 따로 비교한다
비교 실험에서는 원래 GDN, B만 조절하는 방식, 두 항을 모두 조절하는 방식을 같은 입력과 조건에 맞춰 비교해야 한다. 임계값 적용 전후의 정답률 차이도 별도로 기록한다. 질문별 선택이 유익한지 판단하려면 앞부분 정보가 보존되는지, 여러 근거를 함께 읽는지 확인하고 전체 지연과 저장 비용까지 비교해야 한다.