Expert를 똑같이 나눴는데도 GPU가 대기하는 이유: MoE의 토큰 쏠림
가중치 분할과 실제 토큰 부하를 구분하고, 로딩·라우팅·통신을 함께 측정해야 하는 이유를 계산 예시로 설명한다.
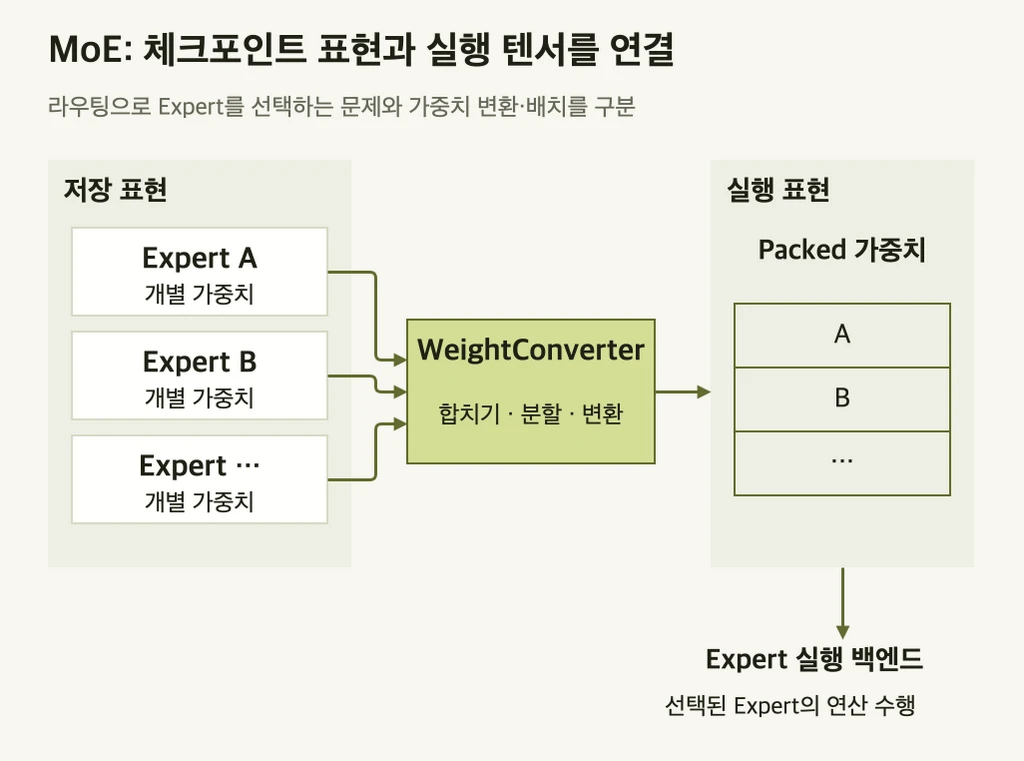
선택적 계산을 실제 실행으로 연결하기
Dense 모델을 키울 때의 비용
Scaling Law에 따라 데이터와 파라미터를 키우는 Dense Scaling 전략은 훈련 비용, 추론 지연, 배포 메모리라는 세 가지 병목을 동시에 악화시킨다.
토큰마다 일부 Expert만 활성화하기
MoE는 Transformer의 FFN(Feed-Forward Network) 레이어를 N개의 Expert 서브네트워크 집합으로 교체하고, Router가 각 토큰마다 활성화할 Expert를 동적으로 선택하는 구조다. 이때 Expert는 "수학 전문가", "코딩 전문가"처럼 의미론적으로 분리된 것이 아니라, 단순히 학습 가능한 서브네트워크의 집합이다.
gpt-oss-20b는 총 21B 파라미터 중 토큰당 ~3.6B만 활성화한다. M3 Ultra(bfloat16) 환경에서 실측한 추론 속도는 ~115 tok/s로, 활성 파라미터 기반 이론치인 111 tok/s와 거의 일치한다. 단, 모든 환경에서 Dense 21B와 같은 품질이나 Dense 3.6B와 같은 지연을 보장하는 것은 아니다.
MoE 채택의 세 가지 배경
① 컴퓨팅 효율 — 동일한 FLOP 예산에서 Dense 모델보다 나은 학습 곡선을 보인다(OLMoE 논문 인용).
② 자연스러운 병렬화 축 — Expert 단위가 계산 그래프의 구조적 경계를 형성하므로 이를 기준으로 Expert Parallelism을 구성한다.
③ 산업 채택 가속 — DeepSeek R1(2025.01)을 기점으로 Qwen 3.5, MiniMax M2, Kimi K2.5 등 주요 오픈모델이 MoE 구조로 전환했다.
Transformers에서 바꾼 네 가지 구현 계층
Hugging Face transformers 라이브러리는 MoE를 효율적으로 처리하기 위해 네 가지 엔지니어링 계층을 개편했다.
Weight Loading에서 텐서 구조 맞추기
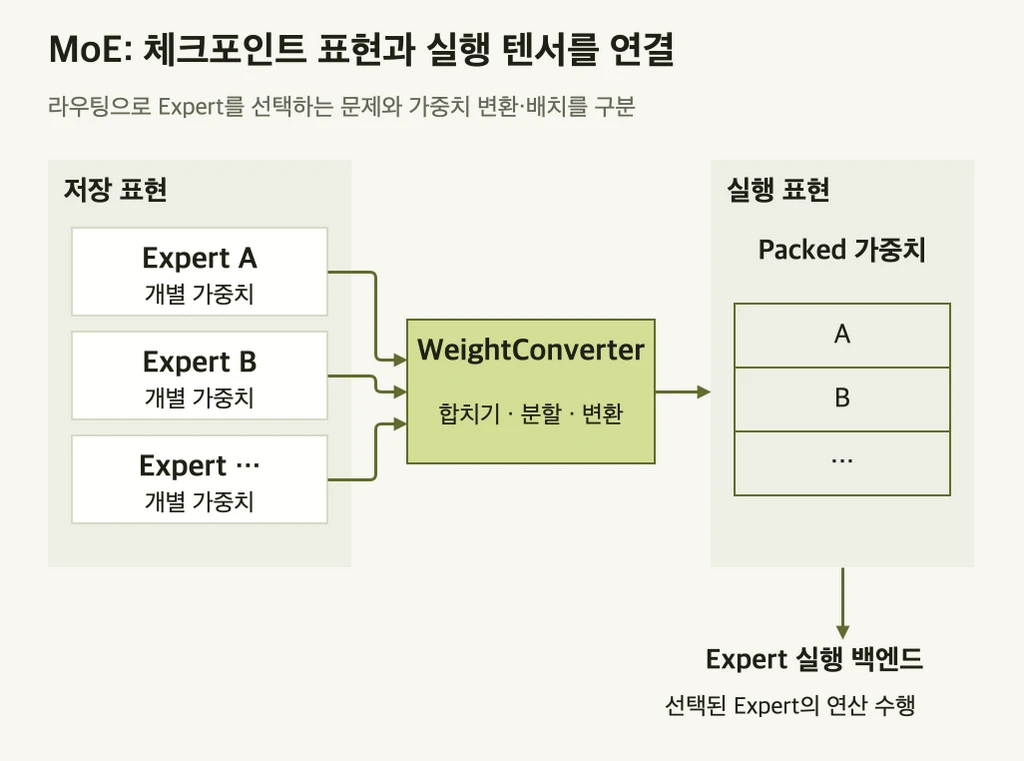
체크포인트는 Expert별 개별 텐서 256개(예: experts.0.gate_proj.weight ~ experts.255.gate_proj.weight)로 저장되는 반면, 런타임 최적화 커널(Grouped GEMM)은 단일 연속 텐서(packed tensor)를 요구한다.
이를 해결하기 위해 WeightConverter 추상화를 도입해 로딩 방식을 단순 키-값 복사에서 변환 파이프라인으로 전환했다. MergeModulelist(분산 → 통합)와 SplitModulelist(통합 → 분산) 두 기본 연산을 조합해 임의의 체크포인트 레이아웃을 런타임 레이아웃으로 변환한다.
Lazy Materialization은 체크포인트 키를 1회만 스캔해 의존성 그래프를 구성하고, 스레드풀 기반으로 비동기 병렬 로딩을 수행한다. MergeModulelist는 특정 레이어의 모든 Expert가 준비된 시점에만 실행된다. 로딩 속도 향상은 단순 병렬화가 아니라 단일 패스 라우팅, 비동기 구체화, 변환 인식 스케줄링이 결합된 결과다.
또한 Expert가 예측 가능한 packed 레이아웃으로 묶이면서 로딩 단계에 Expert 단위 양자화(Quantization)를 자연스럽게 통합한다.
Expert Backend로 실행 방식 선택하기
토큰을 해당 Expert 가중치로 디스패치하는 방식이 모델 구현에 하드코딩되어 있으면 최적화 유연성이 떨어진다. 이를 @use_experts_implementation 데코레이터 기반의 플러그인 아키텍처로 분리했다.
Expert Parallelism으로 가중치 분산하기
N개 GPU에 Expert를 균등 분배해 각 GPU가 할당된 Expert만 로드하고 연산한다.
GroupedGemmParallel: Expert 차원(dim=0) 기준으로 가중치를 샤딩해 각 디바이스가 num_experts / num_devices개만 보유한다.
RouterParallel: 전역 Expert 인덱스를 로컬 인덱스로 재매핑한다. 담당하지 않는 Expert는 마스킹하고 All-Reduce로 부분 출력을 집계한다.
enable_expert_parallel=True 플래그 하나로 TP 플랜에서 EP 플랜으로 자동 전환된다.
Unsloth와의 MoE 학습 경로
MoE 훈련은 파라미터 수 폭증, 분산 Expert 통신, 라우팅 불안정성이 겹쳐 추론보다 훨씬 복잡하다. 이를 해결하기 위해 Expert Backend 추상화, torch._grouped_mm 표준화, Triton 커스텀 Grouped-GEMM/LoRA 커널을 결합했다.
| 구분 | 파라미터 범위 |
|---|---|
| 모델 용량에 영향을 주는 범위 | 전체 파라미터 (Total Parameters) |
| 토큰별 계산량에 영향을 주는 범위 | 활성화 파라미터 (Active Parameters) |
| 버전 | 전략 | 로딩 시간 |
|---|---|---|
| v4 (기존) | device_map="auto" | 66.24s |
| v5 (신규) | device_map="auto", Async | 20.71s (↓69%) |
| v5 (신규) | TP + Async | 10.1s (↓85%) |
| 백엔드 | 메커니즘 | 최적 시나리오 |
|---|---|---|
| eager | Expert별 순차 루프 | 정확성 검증 / 디버깅 |
| batched_mm | torch.bmm (선택 Expert 가중치 복제 후 배치 GEMM) | 소배치, GPU 메모리 여유 있는 환경 |
| grouped_mm | torch._grouped_mm (토큰을 Expert ID 기준 정렬 후 그룹 GEMM) | 대배치 또는 메모리 제약 환경 |
| 지표 | 개선폭 |
|---|---|
| MoE 훈련 속도 | ~12× 향상 |
| VRAM 사용량 | >35% 감소 |
| 컨텍스트 길이 | ~6× 확장 |
| v4 대비 종합 | 12~30× 빠름 |
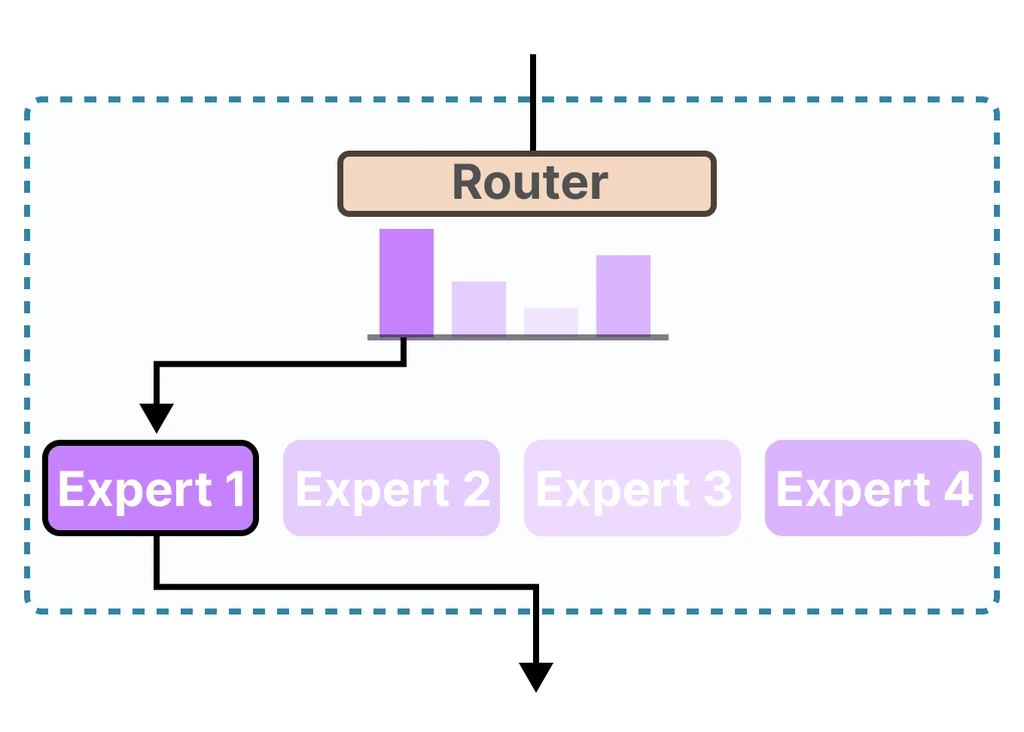
배치·메모리·장치 조건에 맞춘 구현 선택
백엔드별 정확도와 비용 비교하기
실제 모델·배치·메모리 조건에서 정확도와 속도를 비교해 백엔드를 결정한다. 배치 크기와 메모리 여유도를 두 축으로 한 선택 기준은 다음과 같다.
소배치 + 메모리 여유 → batched_mm (가중치 복제 오버헤드를 메모리로 감수)
대배치 또는 메모리 제약 → grouped_mm (정렬 오버헤드를 메모리 효율로 상쇄)
검증/디버깅 → eager (성능보다 정확성 우선)
Expert 분배와 통신량 확인하기
공식 글의 Transformers Expert Parallelism 예시는 전체 Expert 수가 실행 프로세스 수 N으로 나누어떨어지도록 구성한다. 이는 해당 균등 분할 방식의 조건이다. Expert 수를 균등하게 나눠도 토큰 배정까지 균등해지는 것은 아니다. RouterParallel의 All-Reduce가 통신 병목이 될 수 있으므로 노드 내 NVLink/NVSwitch 토폴로지를 고려해 배치한다.
적재 변환과 양자화 조합하기
v5 파이프라인은 Expert packed 레이아웃을 확정한 뒤 양자화를 적용하므로 로딩 파이프라인에 양자화 스텝을 자연스럽게 끼워 넣을 수 있다. 단, 이 구조만으로 AWQ/GPTQ의 정밀도가 향상된다고 단정할 수는 없다.
가상의 Expert 8개를 GPU 4대에 두 개씩 나눴다고 하자. Top-1 라우팅에서 토큰 100개 중 70개가 GPU 한 대가 맡은 Expert 둘로 몰리고 나머지 세 GPU에는 10개씩만 간다면, 가중치 개수는 같아도 계산 부하는 균등하지 않다. 토큰별 계산량이 같다는 단순 가정에서도 가장 바쁜 장치가 다른 장치보다 7배 많은 토큰을 처리한다. 이는 실제 모델 측정값이 아니라 정적 분할과 동적 부하의 차이를 보여 주는 예시다.
따라서 장치별 가중치 메모리뿐 아니라 Expert별 배정 토큰, 패딩·버려진 토큰, 통신 대기와 커널 시간을 함께 본다. 계산 구간만 빨라져도 통신과 동기화가 길어지면 전체 지연은 줄지 않을 수 있다. Top-K를 바꾸는 선택은 실행 최적화와 출력 품질을 동시에 바꾸므로 같은 모델의 무조건적인 가속 옵션처럼 취급하지 않는다.
“토큰당 일부 파라미터만 활성화한다”는 설명도 저장 메모리를 같은 비율로 줄인다는 뜻은 아니다. 다른 토큰이 다른 Expert를 선택하므로 전체 가중치를 저장하거나 적재할 경로는 필요하다. 활성 파라미터 수로 추정한 연산량과 전체 가중치·캐시·통신 버퍼가 차지하는 메모리를 분리해야 장치에 실제로 올라가는 구성을 판단할 수 있다.
[체크포인트 (분산 Expert 텐서)]
          ↓
  WeightConverter (변환 파이프라인)
  - MergeModulelist / SplitModulelist
  - Lazy Materialization + 비동기 스케줄링
          ↓
  [런타임 Packed Tensor]
          ↓
  Expert Backend (플러그인 실행 계층)
  - eager / batched_mm / grouped_mm 선택
          ↓
  [분산 추론 (선택)]
  Expert Parallelism (EP Plan)
  - GroupedGemmParallel + RouterParallel
  - All-Reduce 집계
검증이 필요한 설계 제안
기본 구조를 확장할 때는 정확도·속도·메모리 사용량을 함께 비교해 설계 후보를 선택해야 한다.
라우팅 분포와 학습 안정성
실행 계층 최적화만으로는 특정 Expert에만 토큰이 집중되고 나머지는 죽는 Expert Collapse 문제를 해결할 수 없다. 훈련 안정성을 높이려면 다음 기능을 보완해야 한다.
Auxiliary Load Balancing Loss를 라이브러리 수준에서 표준화해 쉽게 활성화하도록 지원한다.
토큰이 Expert를 선택하는 대신 Expert가 토큰을 선택하는 Expert Choice Routing 옵션을 제공한다.
라우팅 분포 모니터링 훅(hook)을 기본 통합해 훈련 중 Expert 활용도를 가시화한다.
활성 Expert 수를 바꿀 때의 품질 검증
고정된 활성화 Expert 수(Top-K)를 추론 시나리오에 따라 동적으로 조정하면 지연 시간과 품질 사이의 트레이드오프를 런타임에 조절할 수 있다. 예를 들어 배치 크기나 입력 복잡도에 따라 Top-2와 Top-4를 전환하는 adaptive routing이 가능하다. 단, 학습 때와 다른 Top-K는 품질을 떨어뜨릴 수 있으므로 재학습이나 별도 평가 없이 적용해서는 안 된다.
EP와 TP를 조합할 분산 설계 후보
대규모 MoE에서는 Attention은 TP로, Expert는 EP로 나누는 구성을 자동화하도록 DistributedConfig를 확장할 수 있다. 이때 통신량·메모리·품질을 별도로 평가해야 한다.
시계열 도메인에 대한 확장 가설
언어 모델 중심의 MoE 구현을 TimesFM·Chronos 같은 시계열 모델에 접목해 서로 다른 시간 패턴을 학습하게 할 수 있다. 제조 예측 정비 등에서 정확도와 효율이 함께 개선될지는 별도 데이터와 평가로 검증해야 한다.
체크포인트 변환 비용 줄이기
WeightConverter는 모델별 변환 규칙을 요구한다. safetensors 확장 등으로 Expert 구조의 체크포인트 표현을 표준화하면 통합 부담을 줄일 수 있으나, 구체적인 효과는 추가 검증이 필요하다.
라우터 변경 전에 실행 계층부터 계측하기
먼저 같은 모델과 배치 조건에서 가중치 로딩 시간, 백엔드별 메모리·처리량, 장치 간 통신을 측정한다. 그 뒤 라우팅과 학습 안정성 문제를 분리해 비교해야 어느 계층을 바꿀지 정할 수 있다. OLMoE·DeepSeek V3의 결과도 각 학습·배포 조건과 함께 읽어야 한다.
참고 자료
Mixture of Experts (MoEs) in Transformers — Hugging Face (https://huggingface.co/blog/moe-transformers (새 창))