숨은 상태에서 답이 읽히면 추론한 걸까: 잠재 추론의 삭제·대체 실험
잠재 상태를 읽는 프로브와 상태를 바꾸는 개입의 차이를 가상 벡터로 설명한다. 같은 80% 정확도에서도 40개 문제의 정오가 바뀔 수 있는 이유와 상태 거리의 한계를 계산한다.
숨은 상태에서 정답을 90% 읽어 내는 판독기를 만들었다고 하자. 원래 모델도 그 정보를 사용해 답했을까. 판독기가 사용할 수 있는 정보와 모델의 출력 경로가 실제로 참조하는 정보는 다를 수 있다.
잠재 추론을 읽는 실험과 바꾸는 실험을 구별하면 이 차이가 드러난다. 아래의 벡터와 정답률은 설명을 위한 가상 사례다. 실제 논문 결과와는 별개이며, 내부 상태를 직접 편집하거나 모델을 실행한 경험을 주장하지 않는다.
문장 대신 숨은 상태를 넘겨도 정보의 사용은 따로 확인한다
잠재 연쇄 추론 연구 (새 창)는 연속적인 숨은 상태를 다음 입력으로 넘기는 계산을 다룬다. 모델은 이전 잠재 상태뿐 아니라 원래 질문도 참조할 수 있다. 따라서 중간 상태가 순서대로 존재한다는 사실만으로 답이 그 경로를 따라 만들어졌다고 결론 내릴 수 없다.
가상으로 숨은 벡터가 h=(정답 관련 신호, 다른 신호)라고 하자. 별도로 학습한 판독기는 첫 좌표만 보고도 정답을 읽을 수 있다. 그러나 원래 출력기가 질문에서 얻은 정보를 쓰고 이 좌표의 가중치를 0으로 둔다면, 판독 성공 여부와 무관하게 해당 좌표는 출력에 기여하지 않는다. 이는 실제 신경망의 좌표 의미를 재현한 것이 아니라, 두 경로가 달라질 수 있음을 보여 주는 단순 반례다.
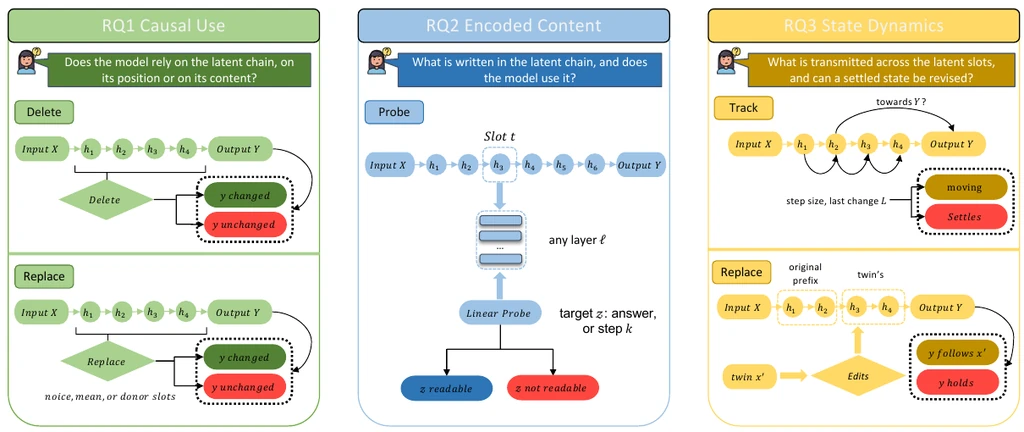
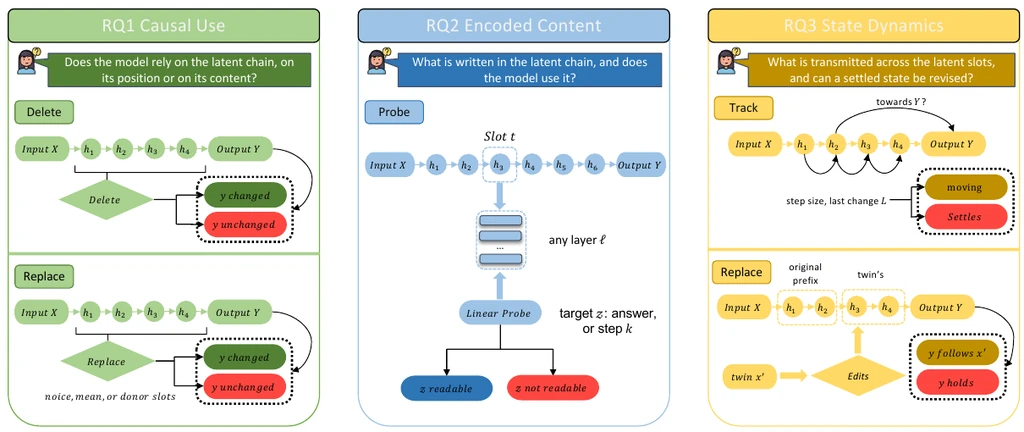
Figure 1의 초록색 영역은 삭제·대체, 파란색은 프로브, 노란색은 상태 변화와 중간 편집을 나타낸다. 그림의 질문을 나누어 읽으면 표현에 정보가 있는가, 답이 그 정보에 의존하는가, 시간에 따라 어떻게 변하는가를 하나의 정답률로 뭉뚱그리지 않게 된다.
삭제는 자리와 내용을 함께 없애고 대체는 내용을 바꾼다
잠재 단계를 삭제하면 벡터 내용뿐 아니라 계산할 자리와 단계 수도 사라진다. 반면 자리를 유지하는 대체 실험은 잡음·평균·다른 문제의 벡터로 내용만 바꾼다. 두 실험이 바꾸는 조건이 다르므로 함께 비교해야 원인을 좁힐 수 있다.
가상 구성 A가 원래 100문제 중 80개를 맞히고, 잠재 단계를 삭제하면 55개, 같은 자리에 다른 내용으로 대체하면 여전히 80개를 맞힌다고 하자. 삭제 결과만 보면 내용이 중요해 보이지만, 대체한 뒤에도 문제별 예측이 모두 같다면 필요한 것은 그 내용보다 자리나 추가 계산일 수 있다. 이런 양상은 placeholder 가설과 연결해 검사할 수 있다.
반대로 가상 구성 B에서 대체 뒤 50개만 맞혔다고 해서 곧바로 올바른 논리 풀이를 한다고 결론 내릴 수는 없다. 익숙하지 않은 벡터가 계산을 망가뜨렸을 가능성도 있기 때문이다. 여러 대체 방식과 문제별 변화 방향을 비교하고, 특정 중간 답을 바꿀 때 최종 답이 예상한 방향으로 따라오는지까지 확인해야 주장이 좁혀진다.
평균 80%가 같아도 바뀐 문제는 40개일 수 있다
100문제 중 원래 맞혔던 80개 가운데 20개가 대체 후 오답이 되고, 원래 틀렸던 20개가 모두 정답이 된다고 하자. 대체 뒤에도 정답은 여전히 80개지만, 정오 상태가 바뀐 문제는 40개다. 평균 정확도가 같다는 이유만으로 출력이 영향을 받지 않았다고 말하면 이 변화를 놓치게 된다.
그래서 원래 정답→오답, 오답→정답, 유지된 정답, 유지된 오답을 같은 문제 ID로 짝지어 기록한다. 정오 상태는 같아도 오답 내용이 달라지는 경우가 있으므로 실제 답 문자열이나 선택지의 변화도 따로 센다. 모델의 의존성을 따질 때 정확도 차이와 예측 변화율은 서로 다른 질문에 답한다.
프로브도 같은 방식으로 대조해야 한다. 판독 점수가 높다는 사실과 원래 모델의 개입 민감도를 나란히 놓고 본다. 임의로 섞은 정답 레이블에서도 판독기가 잘 맞힌다면 평가 누수나 학습 절차를 먼저 의심할 수 있다. 읽기 실험의 대조군이 출력 경로에 대한 인과 증거까지 대신하지는 않는다.
작은 상태 변화가 작은 출력 변화를 뜻하지는 않는다
가상 상태가 h=(1000,0)에서 h′=(1000,1)로 변하면 전체 벡터 크기에 비해 변화량은 작다. 하지만 출력이 두 번째 좌표가 0.5를 넘는지에만 달려 있다면 답은 뒤집힌다. 반대로 출력과 무관한 좌표가 크게 움직이면 벡터 거리는 멀어져도 답이 같을 수 있다. 전체 상태의 이동량과 답에 영향을 주는 방향을 구별해야 하는 이유다.
논문은 GPT-2와 Llama-3.2-1B-Instruct, 논리·산술 과제, 세 가지 학습 방식을 비교했다. 논리 과제에서는 삭제 영향이 거의 없거나 자리만 필요한 양상이 나타났고, 산술 과제에서는 시험한 방식들이 내용 대체에 영향을 받았다. 이 범위의 결과를 상용 모델 전체에 적용하거나 모든 잠재 계산이 불필요하다고 일반화할 수는 없다.
잡음의 세기, 대체 벡터의 분포, 편집 위치도 결과를 바꾼다. 특정 개입에 반응이 작다는 것은 그 개입 조건에서 관찰된 결과일 뿐, 상태가 아무 역할도 하지 않는다는 증명이 아니다. 출력이 바뀌었다는 결과 역시 어떤 정보가 어떤 경로로 쓰였는지 추가로 검증하기 위한 출발점이다.
단계를 줄이려면 정확도와 변화율, 실제 시간을 함께 본다
잠재 단계를 생략하는 최적화를 검토한다면 같은 문제를 원본·삭제·대체로 짝지어 비교한다. 정확도가 유지되더라도 다른 문제를 틀리기 시작했는지, 특정 과제나 어려운 사례에 손실이 몰리는지 확인해야 한다. 계산 단계가 줄었다고 전체 서비스 지연이 같은 비율로 줄어드는 것은 아니므로 실제 시간은 따로 측정한다.
이 실험을 하려면 숨은 상태와 실행 경로에 접근할 수 있어야 한다. 내부에 접근할 수 없는 API에서 출력된 설명만 읽고 같은 인과 검증을 했다고 말할 수는 없다. 이 글의 가상 계산도 실제 모델의 검증 결과를 대체하지 않는다.
잠재 추론의 근거는 그럴듯한 풀이가 숨어 있다는 사실만으로 완성되지 않는다. 무엇이 읽히는지, 무엇을 바꿨을 때 답이 바뀌는지, 그 변화가 어느 문제에서 나타나는지를 연결해야 표현과 계산의 역할을 구별할 수 있다.