답은 한 번 읽는데 모델은 왜 두 번 돌까? DiffusionGemma의 실행 경로 합치기
DiffusionGemma의 한 번짜리 노이즈 제거가 두 모델 실행으로 나뉘는 이유를 코드로 따라간다. 입력·캔버스 융합, 어텐션 경계와 토큰 예산을 작은 예제로 설명한다.
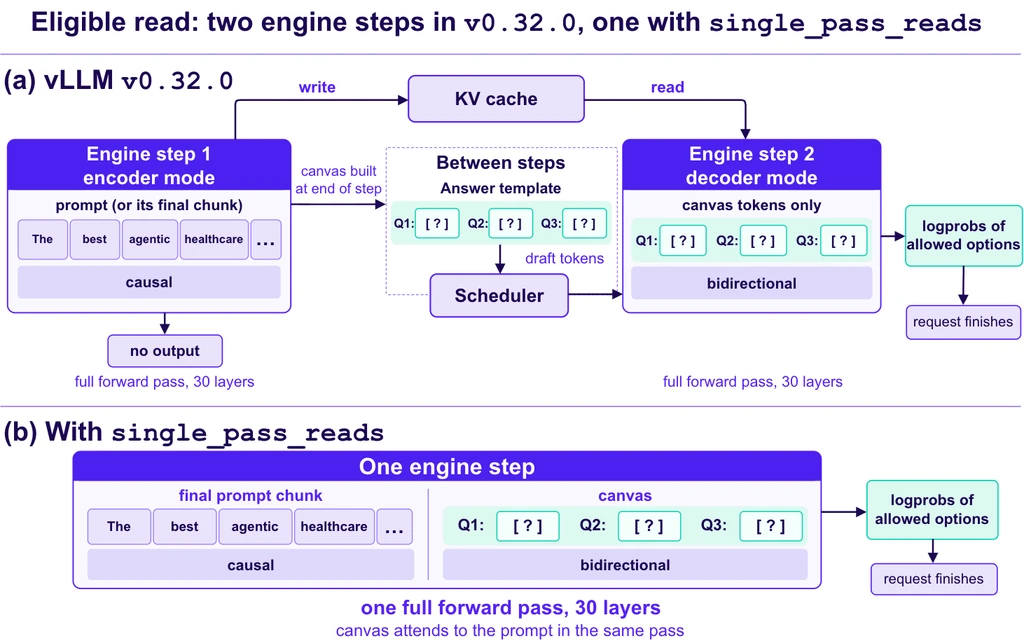
정해진 선택지의 확률만 읽는 요청이라면 답변 문장을 끝까지 생성할 필요가 없다. 그런데 노이즈를 한 번만 제거하는 DiffusionGemma 요청도 vLLM에서는 모델을 두 번 실행해야 했다. 입력을 처리한 뒤 답 템플릿을 다음 실행으로 넘기는 경로 때문이다. 이 글에서는 그 경계를 합치는 제안과, 합칠 수 없는 조건을 코드로 따라가 본다.
답의 내용은 몰라도 답을 담을 자리는 안다
가상의 고객지원 분류 요청을 생각해 보자. 입력은 “중복 결제됐고 앱에서 로그아웃돼요”이고, 질문은 담당 부서와 재문의 필요 여부다. 부서는 A·B·C, 재문의는 Yes·No 중에서 고른다. 이 글에서 든 예시일 뿐 실제 모델에 실행한 요청은 아니다.
일반 생성에서는 모델이 답변 토큰을 순서대로 내놓으면 서비스가 그 결과를 해석한다. 반면 structured read는 고정된 답 템플릿을 먼저 만들고 질문별 답 자리만 비워 둔다. DiffusionGemma가 이 캔버스의 빈자리를 한 번의 노이즈 제거로 처리하면, 서버는 질문마다 허용된 선택지의 확률을 얻는다. 여기서 '한 번'은 노이즈 제거 횟수이지, 입력 처리까지 포함한 엔진 실행 횟수가 아니다.
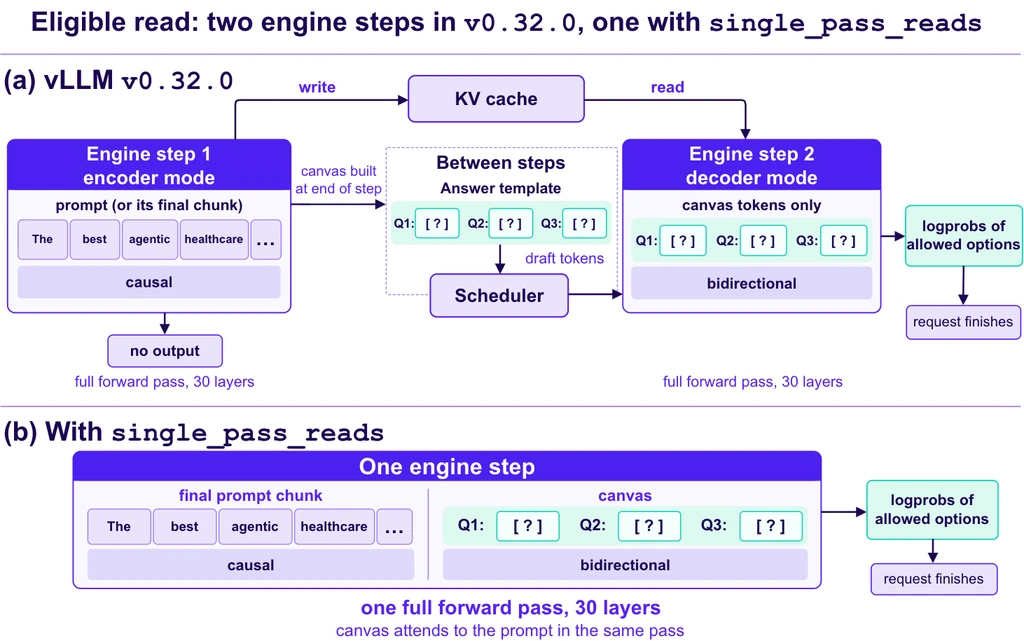
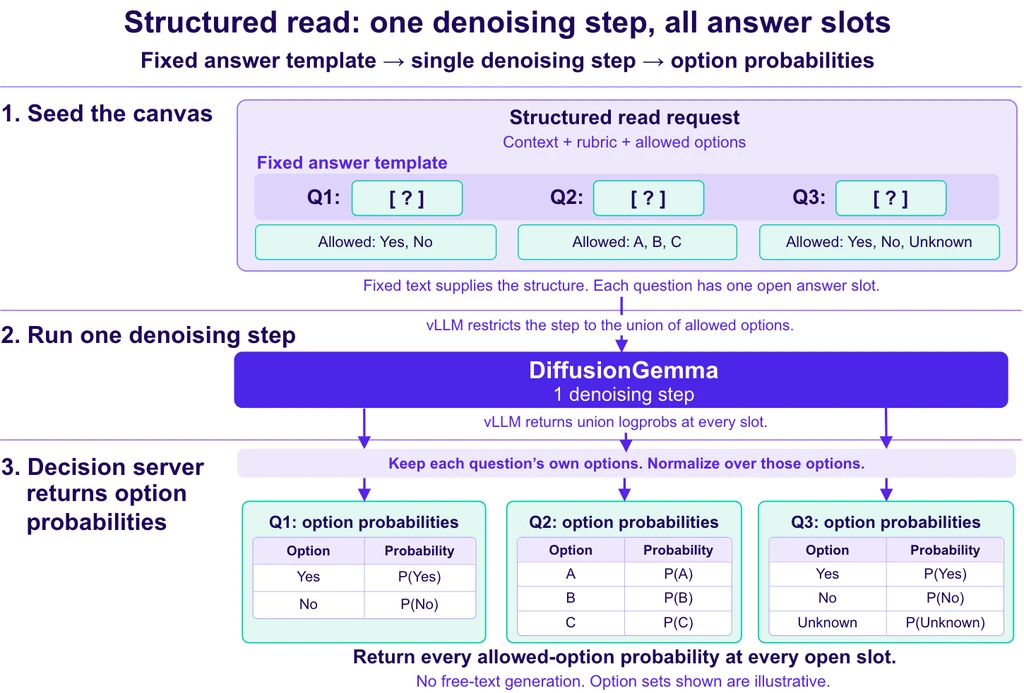
League의 구현 보고 (새 창)는 vLLM v0.32.0을 기준으로 이 차이를 추적한다. 아래 그림의 위쪽 경로를 보면 입력을 처리한 뒤 캔버스를 draft tokens로 넘기고, 스케줄러가 다음 실행에서 이를 선택한다. 하지만 캔버스는 답변을 순차 생성한 결과가 아니라 요청과 함께 정해지는 틀이므로, 이 요청에서는 앞선 실행의 출력을 기다릴 이유가 없다. 그림에 나오는 질문 세 개는 원자료의 예시로, 여기서 든 질문 두 개와는 다르다.
같이 실행해도 서로 볼 수 있는 범위는 유지한다
PR #61480 (새 창)은 `single_pass_reads`를 켰을 때 캔버스를 미리 등록해 마지막 입력 조각과 함께 실행하는 방식을 제안한다. 2026년 11월 1일 확인 기준 아직 병합되지 않은 CPU 전용 제안이며, 기본값은 꺼져 있다. 정식 버전에 이 옵션이 이미 반영되었다고 가정해서는 안 된다.
입력과 캔버스를 단순히 이어 붙여 똑같은 어텐션을 적용하면 계산 결과가 달라진다. 입력은 앞선 입력만 참고하는 인과적 어텐션을 유지해야 하고, 캔버스는 전체 입력과 캔버스 내부를 모두 볼 수 있어야 한다. 제안 코드의 `_CanvasSplit` (새 창)은 하나로 합친 요청을 입력 행과 캔버스 행으로 나누고, 각각의 길이와 causal 표시를 따로 만든다. KV 블록 표는 같은 요청의 것을 함께 쓴다.
이를 축소한 가상 예시로 입력 p0·p1과 캔버스 c0·c1을 살펴보자. p0는 p0만 읽고, p1은 p0·p1을 읽는다. 반면 c0와 c1은 p0·p1뿐만 아니라 c0·c1도 읽는다. 실행 묶음은 하나여도 입력이 답 자리를 미리 들여다보는 경로는 생기지 않는다. 이 경계를 유지하는 덕분에 입력 처리와 답 자리 평가를 같은 모델 실행 안에 배치할 수 있다.
12개 입력과 4개 캔버스를 예산에 넣어 보면
스케줄러의 `_final_prefill_spec_tokens` (새 창)는 지금 선택한 입력 조각으로 프롬프트가 끝나는지 먼저 확인한다. 이어서 이번 입력 토큰 수에 캔버스 폭을 더한 값이 남은 토큰 예산에 들어오는지, 전체 프롬프트와 캔버스의 합이 `max_model_len` 안에 들어오는지 검사한다. 조건에 맞지 않으면 빈 목록을 반환해 기존 경로를 유지한다.
고객지원 요청을 단순화해 입력 12개와 캔버스 4개, 이번 실행의 남은 예산을 16개라고 가정해 보자. 실제 문장의 토큰 수를 센 결과가 아니라 코드 조건을 살펴보기 위한 수치다. 이 조각으로 입력이 끝나고 전체 길이 한도도 충족한다면 12+4=16이므로 한 번에 실행할 수 있다. 만약 예산이 15개라면 입력은 끝낼 수 있어도 캔버스까지 넣을 수는 없어 분리 경로를 쓴다.
입력이 20개이고 한 번에 16개씩 처리하는 경우는 다르다. 첫 실행에서는 입력 16개만 처리하고, 다음 실행에서 남은 입력 4개와 캔버스 4개를 합친다. 전체 요청을 처리하려면 여전히 두 번 실행해야 한다. 줄어드는 것은 마지막 입력 뒤에 따로 돌던 캔버스 실행이지, 앞선 모든 입력 조각이 아니다.
요청 자격 검사 (새 창)도 따로 거친다. `diffusion_read_only`가 참이고 `diffusion_max_steps=1`이어야 하며, 입력 토큰의 로그 확률을 요청하지 않아야 한다. 자유 생성이나 노이즈를 여러 번 제거하는 작업까지 같은 방식으로 합칠 수 있다는 뜻은 아니다.
실행 하나를 줄인 대가도 요청 단위로 본다
이 방식은 캔버스 계산 자체를 없애지 않는다. 입력과 함께 모델을 통과시켜 별도의 전체 순전파를 한 번 줄일 뿐이다. 대신 같은 실행에 캔버스까지 넣어야 하므로 토큰 예산과 KV 공간을 더 일찍 확보해야 한다. PR에서는 조건에 맞는 요청이라도 입력과 캔버스의 KV 공간을 모두 확보할 때까지 대기한다는 점을 대가로 꼽는다. 토큰 예산 검사에서 걸려 분리 경로로 돌아가는(fallback) 경우와 KV 공간이 부족해 대기하는 경우를 같은 fallback으로 묶어 설명해서는 안 된다.
League는 BF16 모델의 C4·C3 실험에서 지연 시간이 줄었다고 보고하지만, 단일 요청에서 얻은 이득을 동시성이 높은 환경에 그대로 적용할 수는 없다. 기존 경로에서도 여러 요청이 한 실행을 공유하기 때문이다. 또한 계산 내용이 같아도 묶음 모양이 달라지면 BF16 반올림 결과가 달라질 수 있다. 보고서의 JevBench 비교에서는 최종 결정이 바뀐 항목도 있었다.
고객지원 분류에 적용한다면 합쳐진 실행 횟수와 대기 시간을 확인한 뒤, 같은 문의에 대해 부서 선택과 확률이 그대로 유지되는지도 대조해 볼 필요가 있다. 입력 처리와 캔버스 평가의 두 행을 보존하는 것은 구조적 조건이고, 달라진 확률을 서비스에서 받아들일 수 있는지는 별개로 판단할 문제다. 이 글은 제안 코드를 읽고 정리한 해설이며, 실제 모델을 실행하거나 성능을 재현한 결과는 아니다.