vLLM Humming은 4비트를 어떻게 계산하나: 스케일·커널·병목의 연결
작은 INT4 계산으로 스케일과 복원 오차를 이해하고, Humming의 가중치 전처리·커널 준비·추론을 따라간다. 입력 형상과 활성값 정밀도가 성능 비교를 바꾸는 이유를 설명한다.
4비트 모델 파일을 받았다고 해서 GPU가 모든 계산을 4비트로 처리하는 것은 아니다. 저장된 가중치를 계산에 맞는 형태로 풀고, 활성값과 곱한 뒤 결과를 모으는 경로가 필요하다. 같은 파일이라도 이 경로와 입력 크기에 따라 속도와 오차가 달라질 수 있다.
vLLM Humming은 양자화 표현과 실행 선택을 분리한다. 작은 양자화 계산부터 가중치 전처리, 커널 준비, 실제 추론 순서까지 차례로 따라가 보자. 아래 숫자는 원리를 설명하기 위한 가정이며 Humming 커널을 실행한 벤치마크는 아니다.
4비트 값에는 스케일이라는 해석 규칙이 붙는다
단순한 대칭 양자화를 가정해 가중치 w를 q=round(w/s)로 저장하고, 사용할 때 s×q로 복원한다고 하자. 4비트 부호 정수의 범위를 −8부터 7까지로 잡고 s=0.1, w=0.26으로 두면 q=3이 되고 복원값은 0.3이다. 이 작은 차이가 양자화 오차다. 범위를 벗어나는 값은 별도로 제한해야 하므로 반올림만으로 모든 입력을 처리할 수는 없다.
가상 가중치 [0.26, −0.14]와 활성값 [2, 1]의 내적은 원래 0.38이다. 여기에 같은 스케일로 양자화한 가중치 [0.3, −0.1]을 쓰면 0.5가 된다. 저장 비트를 줄이는 일은 곧 값의 근사로 이어진다. 활성값까지 양자화하면 별도의 근사가 더해질 수 있다. 이 계산은 INT4 설명용일 뿐, MXFP4나 실제 Humming의 모든 형식을 대신하는 식은 아니다.
스케일 자체도 저장 공간을 차지한다. 가상으로 가중치 128개마다 16비트 스케일 하나를 붙이면, 가중치 본체 64바이트에 스케일 2바이트가 더해져 총 66바이트가 된다. 이는 값당 평균 4.125비트로, 패딩·제로포인트·정렬을 제외한 계산이다. “4비트”를 모델 전체 메모리가 정확히 원래의 4분의 1로 줄어든다는 뜻으로 읽을 수 없는 이유다.
표현을 맞춘 다음 GPU가 읽기 좋은 배치로 바꾼다
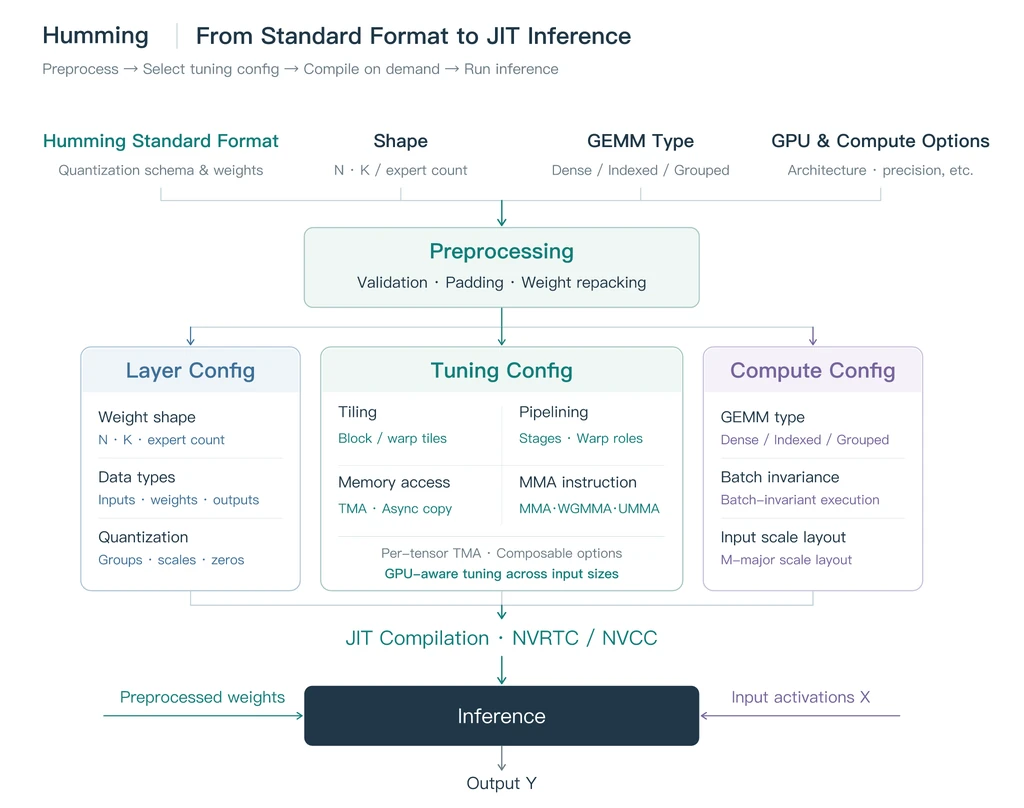
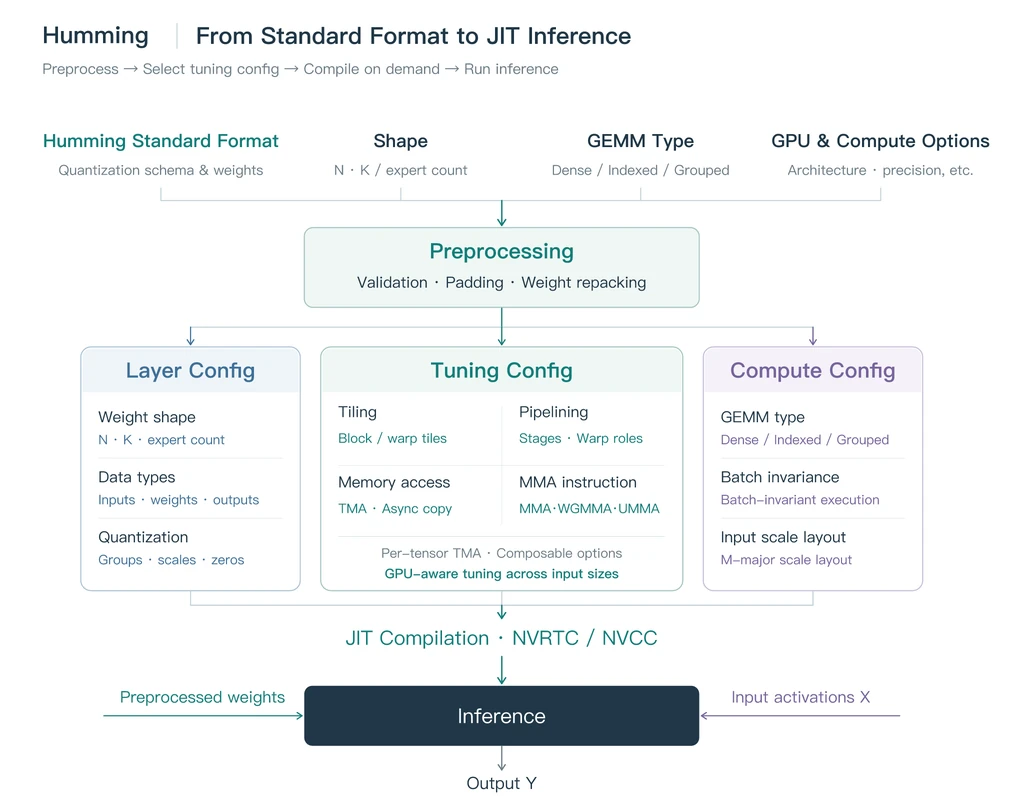
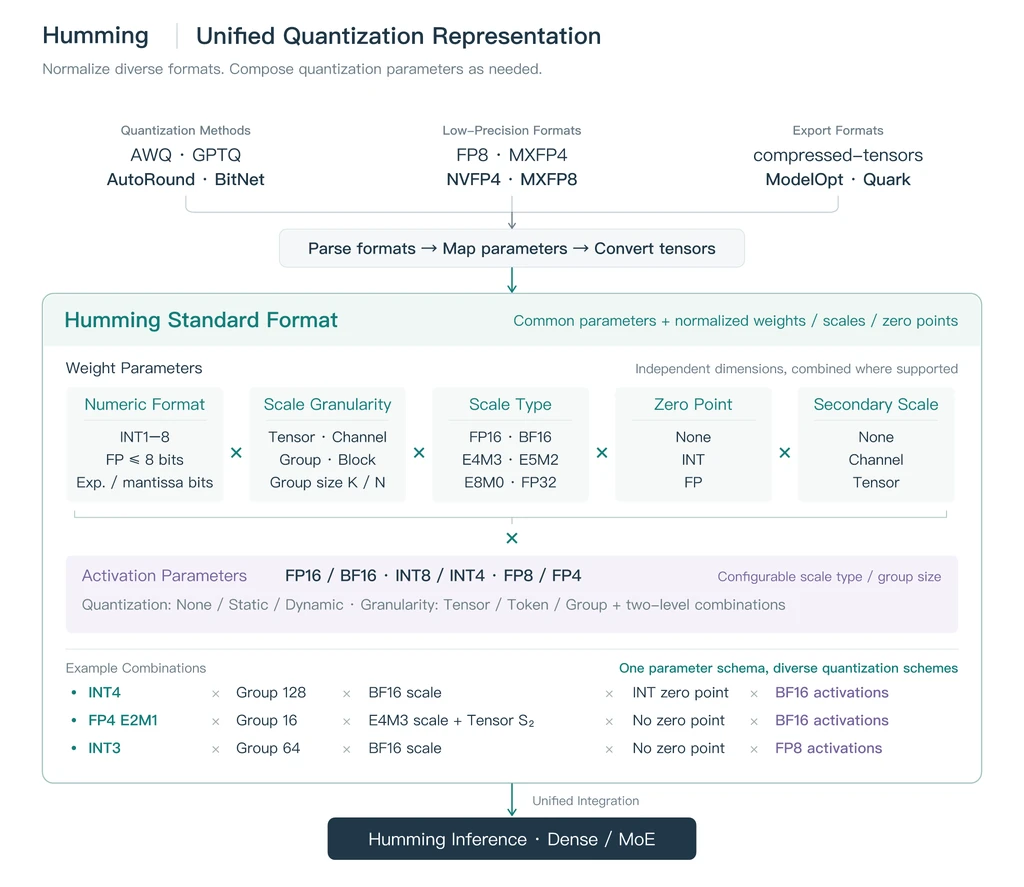
Humming 공식 발표 (새 창)에 따르면, 가중치 형식과 스케일·제로포인트 등을 공통 표현으로 정리한 뒤 장치와 커널에 맞게 전처리한다. 단순히 파일 확장자를 바꾸는 과정이 아니다. 차원 패딩과 재배치를 거쳐 GPU가 읽고 계산하기 좋은 자료 배치를 준비한다.
그다음 Layer Config는 형상·자료형·양자화 조건을, Compute Config는 행렬곱 유형과 계산 옵션을, Tuning Config는 타일과 메모리 접근 등 실행 전략을 정한다. 아래 그림처럼 미리 준비된 가중치와 실행 시 들어오는 활성값은 서로 다른 시점에 합쳐진다.
저장소 예제 (새 창)에서도 가중치를 로드한 뒤 transform()으로 표현 변환과 기본 커널 준비를 마치고, 이후 layer(inputs)로 추론한다. 준비 비용과 반복 추론 비용을 나누어 보는 이유가 여기에 있다. 첫 호출의 컴파일 비용까지 포함한 측정값과 이미 준비된 커널의 실행 시간을 그대로 비교하면 서로 다른 작업을 비교하는 셈이 된다.
같은 가중치도 한 토큰과 많은 토큰에서 비용이 다르다
선형층을 X와 W의 전치행렬 Wᵀ의 곱으로 보면 X는 M×K, W는 N×K이고 출력은 M×N이다. 가중치는 같더라도 한 번에 처리하는 행 수 M이 달라지면 재사용 기회가 달라진다. 설명을 위해 가중치를 한 번 읽어 M개의 입력 행에 재사용할 수 있다고 가정하면, M이 커질수록 행당 가중치 읽기 부담은 줄어든다.
반면 계산량은 대략 2MNK로 M에 비례해 늘어난다. 작은 M에서는 가중치를 읽고 푸는 시간이 중요했다가, 큰 M에서는 행렬곱 계산이 더 중요해질 수 있다. 실제로 어느 쪽이 병목이 될지는 캐시·타일·하드웨어와 커널에 따라 달라지므로 이 식만으로 실행 시간을 단정할 수는 없다.
MoE에서는 토큰이 전문가별로 나뉜다. 전체 요청 수가 같아도 특정 전문가로 몰린 토큰 수가 다르면 각 행렬곱의 M이 달라질 수 있다. 따라서 동시성 하나만 고정했다고 해서 모든 커널 형상이 같아지지는 않는다. 형식 이름만 비교하기보다 입력 크기와 전문가별 부하를 함께 살펴보는 편이 실행 차이를 설명하기 쉽다.
가중치 형식, 활성값, 백엔드를 한 줄에 적는다
vLLM 연동 안내 (새 창)에서는 일반 행렬곱에 --linear-backend humming을, MoE 행렬곱에 --moe-backend humming을 사용한다. --quantization humming은 기본으로 지원하지 않는 형식 등을 연결하는 호환 경로다. 이름이 같아도 실제로 바꾸는 대상은 다르다.
공식 종단 간 비교 (새 창)는 DeepSeek-V4.1-Flash, H20 8장, TP=8 환경에서 MXFP4 가중치를 유지했다. 그러나 Marlin W4A16에서 Humming W4A8로 전환하면서 활성값도 BF16에서 토큰별 FP8로 바뀌었다. 동시성 64 기준 출력 처리량이 442.37→633.94 tokens/s로 약 43.3% 늘어났지만, 이를 순수하게 백엔드만 교체한 효과로 분리할 수는 없다.
가상의 비교표를 만든다면 각 행에 체크포인트, 가중치 형식, 활성값 형식, 실제 백엔드, GPU, 입력·출력 길이를 함께 적는다. 백엔드만 바뀌는 조합과 정밀도까지 바뀌는 조합을 구분해 두면, 품질 차이가 생겼을 때 무엇을 되돌릴지 판단하기 쉽다.
커널의 빠르기가 전체 요청에 얼마나 남는지 본다
가상 요청 시간 100ms 중 특정 행렬곱이 40ms를 차지하고 나머지가 60ms라고 하자. 해당 행렬곱이 두 배 빨라져 20ms로 줄어들어도 전체 시간은 80ms다. 전체 가속은 100/80=1.25배에 그치며 두 배가 되지 않는다. 이는 다른 구간의 시간이 변하지 않는다는 가정 아래 계산한 예시다.
실제 도입 시에는 커널 준비를 포함한 첫 실행과 준비가 끝난 뒤의 반복 실행을 구분한다. 짧은 입력과 긴 입력, 낮은 부하와 높은 부하 조건에서 첫 토큰 지연·출력 처리량·답변 품질을 함께 본다. 옵션을 요청했다는 사실과 원하는 자료형·백엔드가 실제로 선택됐다는 사실도 나누어 확인한다.
Humming을 선택하는 기준은 가장 작은 비트 수나 가장 큰 커널 가속 배수 하나만이 아니다. 저장 표현을 어떻게 계산으로 옮겼는지, 그때 생긴 오차와 준비 비용을 감당하면서 실제 요청 시간을 얼마나 줄였는지가 중요하다. 조건을 분리해 기록해야 빨라진 이유와 품질이 달라진 이유를 같은 비교 안에서 설명할 수 있다.