실행되는 SQL이 왜 틀릴까: 조인 중복부터 비용 제한까지
주문 두 건이 조인 뒤 세 행이 되면 실행에 성공한 SQL도 매출을 부풀린다. 집계 단위를 추적하고 권한·스캔 비용을 분리해 검증하는 과정을 설명한다.
SQL이 오류 없이 실행돼도 매출이 두 배로 집계될 수 있다. 주문과 상품을 조인한 뒤 주문 금액을 더하면, 같은 주문이 상품 수만큼 반복되기 때문이다. Text-to-SQL 검증은 문법 오류를 고치는 데서 끝나지 않는다. 조인 뒤에도 질문의 집계 단위가 유지되는지, 결과를 조회할 권한과 비용 여유가 있는지까지 확인해야 한다.
생성·구문 검증 이후의 통제 기준
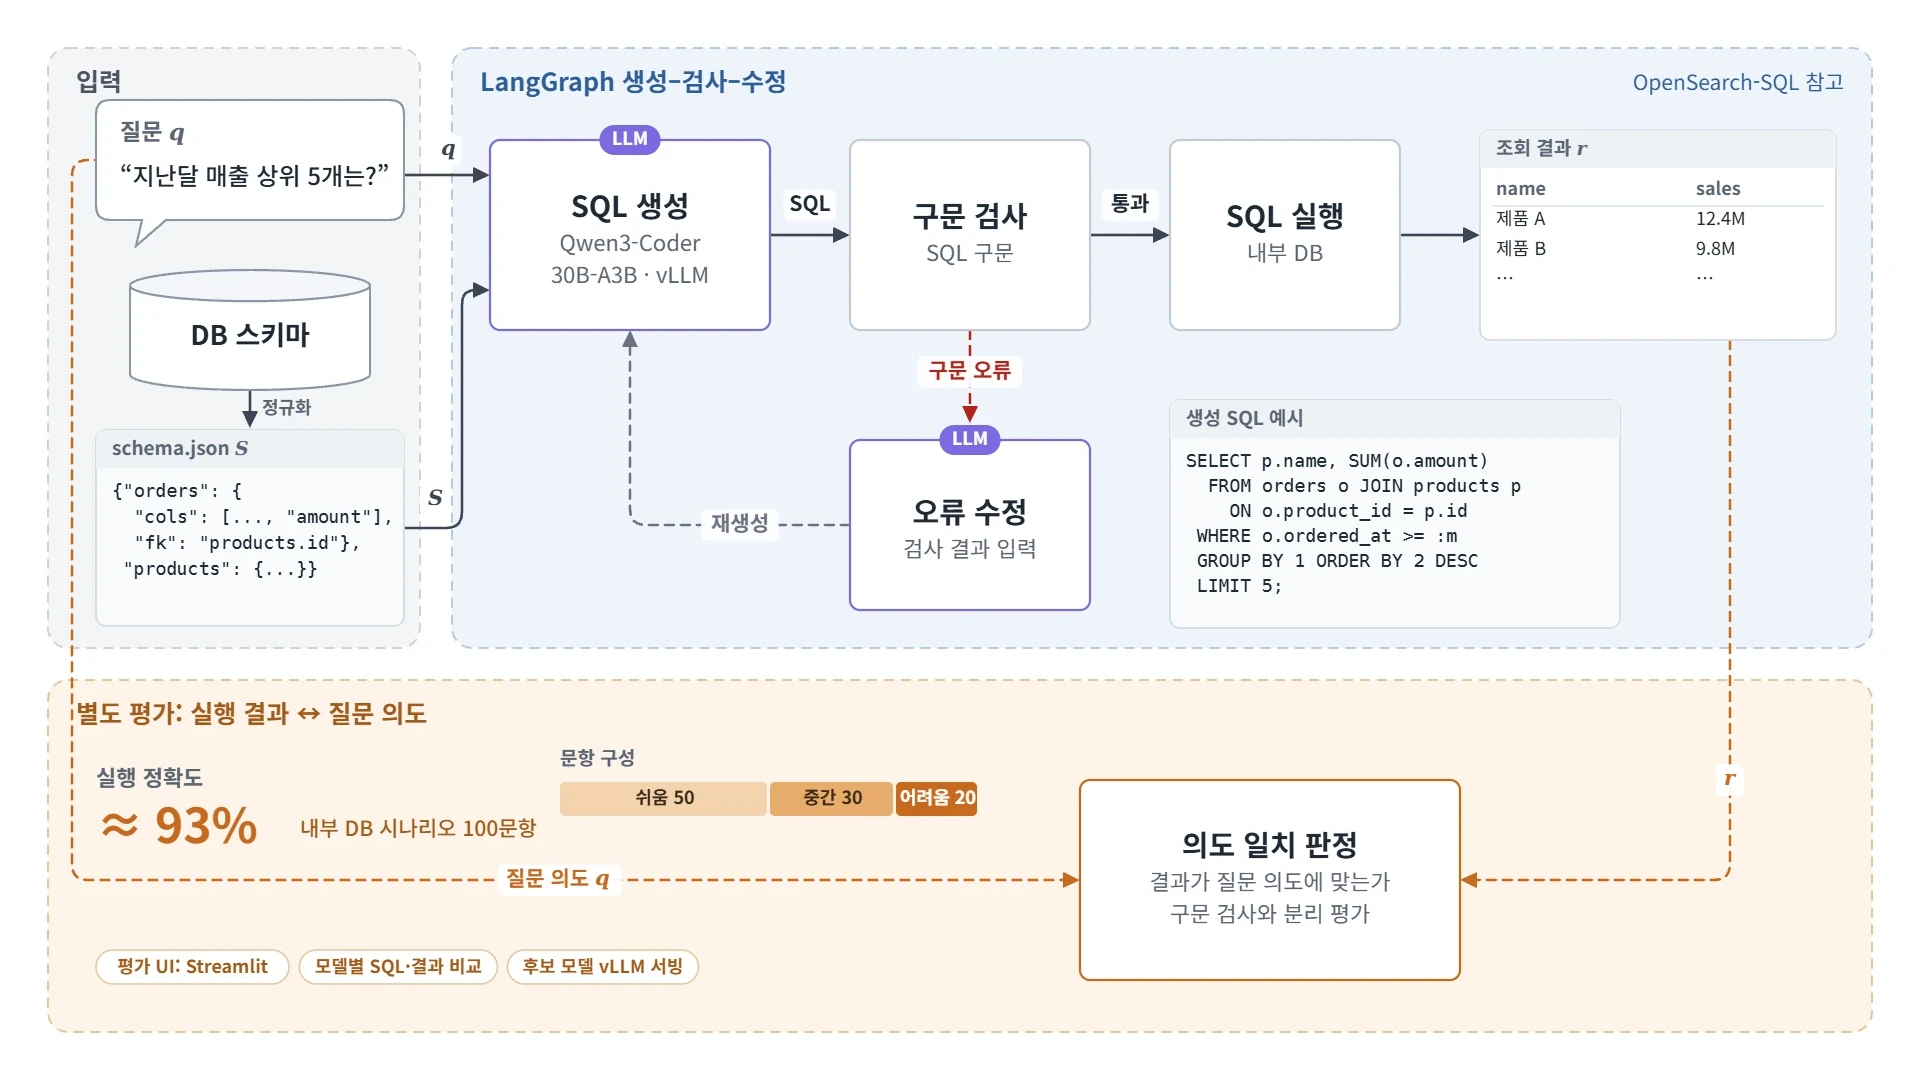
Text-to-SQL 생성·검증 프로젝트에서는 내부 DB 시나리오를 바탕으로 스키마 정규화와 SQL 생성·구문 검증·수정 흐름을 구현했다. Qwen3-Coder-30B-A3B는 내부 100문항에서 약 93%의 실행 정확도를 기록했으며, 권한별 스키마 노출과 쓰기 쿼리 차단, 실행 비용 제한은 다음 단계의 설계 과제로 남아 있다. 생성 이후의 실패 단계를 세분화해야 모델 교체, 스키마 입력 수정, 실행기 통제 중 무엇을 먼저 손볼지 우선순위를 정할 수 있다.
벤치마크 성능이 실제 환경으로 이어지지 않는 이유
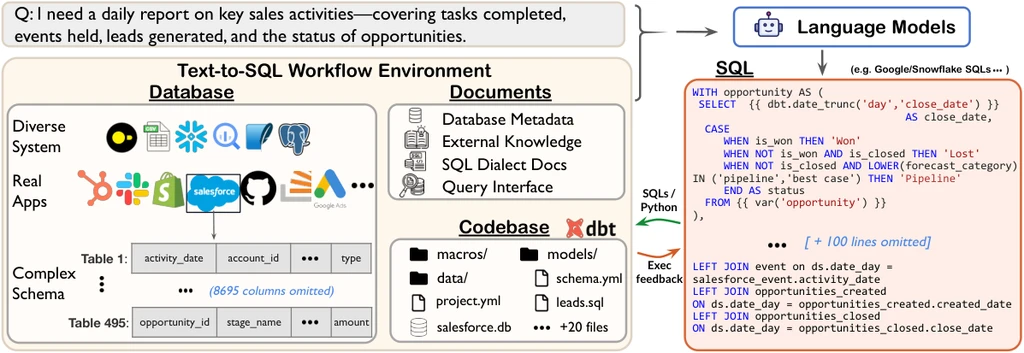
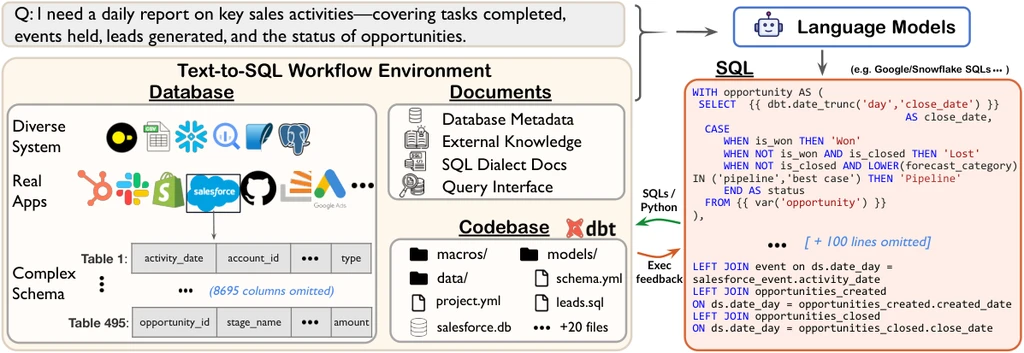
기존 Text-to-SQL 벤치마크는 질문 하나와 정돈된 스키마를 제공하지만, 실제 기업 데이터베이스 환경은 다르다. 이름이 비슷한 컬럼이 반복되고 조인 경로가 문서에만 적혀 있거나, SQL 방언과 프로젝트 규칙까지 파악해야 한다.
Spider 2.0 (https://arxiv.org/abs/2411.07763 (새 창))은 1,000개가 넘는 컬럼과 여러 SQL 방언, 긴 워크플로를 포함한 문제를 다룬다. 논문 v1(2024년 11월)에서 o1-preview 기반 코드 에이전트는 Spider 1.0에서 91.2%, Spider 2.0에서 17.0%를 기록했다. 개정판인 v2(2025년 3월)에서는 Spider 2.0 수치를 21.3%로 보고하므로 인용할 때 버전을 구분해야 한다. 실제 환경에서는 스키마 탐색과 문서 검색, 쿼리 실행 및 수정이 함께 이루어져야 하므로 성능 차이가 크게 나타난다.
따라서 평가 단위를 단순한 ‘질문 → SQL 문자열’ 변환에서 전체 파이프라인으로 넓혀야 한다.
질문
  → 의도·권한 확인
  → 관련 스키마 검색
  → SQL 생성
  → 정적 검사
  → 제한된 실행
  → 결과 검증
  → 답변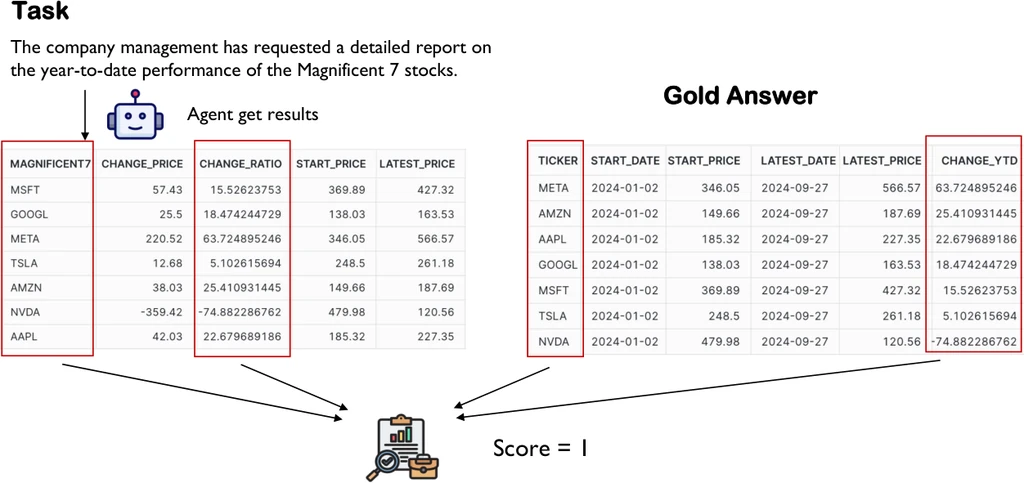
관련 스키마를 빠뜨리지 않고 좁히기
스키마 전체를 프롬프트에 넣으면 필요한 정보는 빠지지 않지만, 토큰을 많이 소모하고 이름이 비슷한 컬럼들이 모델의 판단을 흐린다. 반대로 검색 결과를 너무 좁히면 조인에 필요한 외래 키나 필터 컬럼을 놓치게 된다.
Schema Linking은 자연어 질문과 관련된 테이블, 컬럼, 관계를 먼저 추려내는 단계다. Extractive Schema Linking 연구 (https://arxiv.org/abs/2501.17174 (새 창))는 전체 스키마를 입력하는 방식이 비용뿐만 아니라 정확도 면에서도 불리할 수 있다고 지적한다. AutoLink (https://arxiv.org/abs/2511.17190 (새 창))는 처음부터 모든 스키마를 전달하지 않고 필요한 관계를 단계적으로 탐색한다.
스키마 색인에는 다음 정보를 포함한다.
- 테이블과 컬럼 이름 - 컬럼 설명과 업무 용어 동의어 - 기본 키와 외래 키 관계 - 값의 통계와 민감도 등급 - 검증된 대표 SQL과 자주 쓰는 조인 경로
검색은 테이블 단위에서 그치지 않고, 질문과 밀접한 컬럼을 찾은 뒤 그래프에서 한두 단계 떨어진 키와 조인 테이블로 확장한다. SQL 실행 정확도만 보면 검색 단계의 문제가 가려지므로, 필요한 스키마 확보 비율(Recall)과 검색한 스키마 중 필요한 항목의 비율(Precision)을 따로 기록해야 한다.
가상 질문을 하나 살펴보자. “지난달 결제된 주문의 매출”을 구하려는데 orders에는 주문 금액과 상태가, order_items에는 상품별 수량이 들어 있다. 필요한 정보가 모두 orders에 있는데도 상품 테이블까지 조인하면 결과 행의 단위가 주문에서 주문 상품으로 바뀐다. 검색을 통해 관련 테이블을 많이 모았다고 해서 좋은 입력이 되는 것은 아니다. 각 테이블의 한 행이 무엇을 나타내는지와 키의 유일성 정보도 함께 전달해야 한다.
실행 실패의 종류에 맞춰 수정하기
수정 루프에는 횟수 제한을 두어야 한다. 같은 오류를 표현만 바꿔 반복하면 비용과 지연 시간만 늘어난다. 매 시도마다 오류 종류, 변경된 SQL AST, 사용한 스키마, 처리 시간을 기록하면 재시도를 통해 문제가 해결되고 있는지 판단할 수 있다.
LitE-SQL (https://arxiv.org/abs/2510.09014 (새 창))은 Schema Linking과 실행 피드백을 결합해 이 과정을 다룬다. 다만 잘못 작성된 SQL도 에러 없이 실행될 수 있으므로, 프로덕션 환경에서는 실행 성공을 곧바로 정답으로 간주해서는 안 된다.
이 차이는 주문 두 건을 예로 들어 확인할 수 있다. 주문 A는 금액이 100이고 상품이 2개, 주문 B는 금액이 50이고 상품이 1개라고 하자. 주문 테이블만 합산하면 150이 된다. 하지만 상품 테이블과 조인한 뒤 주문 금액을 합산하면 주문 A가 두 행으로 중복되어 100 + 100 + 50 = 250이 된다. 파서와 데이터베이스는 이 SQL을 정상으로 처리하므로, 오류 메시지를 기다리는 수정 루프는 시작조차 하지 않는다.
상품 조건이 없다면 조인을 제거하는 것이 맞다. 특정 상품이 포함된 주문의 매출을 묻는다면, 상품 행을 그대로 조인해 합산하기보다 EXISTS로 포함 여부만 검사하거나 조건에 맞는 주문 ID의 중복을 먼저 제거해야 한다. SUM(DISTINCT amount)로 고치면 금액이 같은 서로 다른 주문까지 하나로 합쳐지므로 대안이 될 수 없다. 이 예시에서 검증해야 할 대상은 단순한 숫자가 아니라 “주문 하나가 합산에 한 번 참여한다”는 규칙이다.
| 실패 유형 | 예시 | 처리 방식 |
|---|---|---|
| 문법 오류 | 잘못된 함수나 SQL 방언 | 파서·dry run 결과로 한 번 수정 |
| 스키마 오류 | 존재하지 않는 컬럼 | 검색 단계로 돌아가 스키마 확장 |
| 의미 오류 | 잘못된 조인, 집계 기준 오류 | 예상 결과 형태와 업무 규칙 검사 |
| 빈 결과 | 지나치게 강한 필터 | 값 분포를 확인하되 조건을 임의로 삭제하지 않음 |
| 비용 초과 | 전체 스캔, 잘못된 Cartesian join | 실행하지 않고 차단 |
실행기에서 권한과 비용 제한하기
프롬프트에 “SELECT만 작성하라”고 적는 것만으로는 안전장치가 되지 않는다. 모델 출력을 그대로 신뢰하지 말고, 실행기가 허용된 범위의 작업만 수행하도록 통제해야 한다.
- 읽기 전용 데이터베이스 계정을 별도로 사용한다. - SQL을 AST로 파싱해 허용된 명령과 테이블만 통과시킨다. - 다중 문장, DDL, DML, 동적 SQL을 차단한다. - 실행 시간, 반환 행 수, 스캔 용량에 상한을 둔다. - 민감한 컬럼은 검색과 실행 단계에서 모두 가린다. - 질문, 생성 SQL, 수정 이력, 최종 실행을 감사 로그로 남긴다.
BigQuery는 dry run (https://cloud.google.com/bigquery/docs/running-queries (새 창))으로 실행 전에 구문 오류와 예상 처리량을 확인하고, maximumBytesBilled로 비용 상한을 설정할 수 있다. 반환되는 행 수와 실제로 읽는 데이터양은 다르기 때문에, LIMIT 100을 붙여도 스캔 비용이 100행 분량으로 줄어들지는 않는다. 외부 데이터 연합 쿼리나 행 수준 보안이 적용된 테이블은 dry run의 처리량 추정에 한계가 있어 별도로 확인해야 한다.
가령 파티션 필터링 없이 200 GB를 읽는 쿼리에 LIMIT 100을 붙였다고 하자. 반환되는 결과는 줄어들지만 읽기 작업량이 100행 수준으로 줄었다고 볼 수는 없다. 온디맨드 과금 환경에서 dry run 추정치가 200 GB이고 maximumBytesBilled를 10 GB로 설정했다면, 실행 전에 한도 초과로 쿼리를 거절하도록 구성한다. 이어지는 수정 단계에서는 LIMIT 숫자를 더 줄이는 대신, 질문의 기간 조건이 파티션 컬럼에 제대로 적용되었는지 확인해야 한다. 이 수치는 동작 방식을 설명하기 위한 가상 예시이며 실제 측정값이 아니다. BigQuery 비용 통제 문서 (새 창)에서도 반환량과 처리량을 구분해 설명한다.
파이프라인 단계별 효과를 비교할 실험안
모델·질문·스키마 스냅샷·온도를 고정하고, 격리된 평가 환경에서 각 단계의 효과를 분리해 비교한다.
- 정확도: 결과 집합이 기준 답과 일치하는가 - Schema Recall: 필요한 테이블과 컬럼을 빠짐없이 검색했는가 - Repair Yield: 첫 시도에 실패한 쿼리 중 수정으로 회복한 비율 - Unsafe Query Block Rate: 위험한 쿼리를 실행 전에 차단했는가 - Latency: 검색, 생성, 검증, 실행에 각각 얼마나 걸렸는가 - Cost: 모델 토큰과 데이터베이스 처리량이 얼마나 발생했는가
평가셋에는 존재하지 않는 지표, 모호한 기간, 권한 밖의 데이터, 비용이 큰 질문도 포함한다. SQL 생성 성공 외에 실행하지 않아야 할 질문을 올바르게 멈췄는지도 측정한다.
위 조인 오류를 평가셋에 넣을 때는 주문 금액이 서로 다른 경우만 두어서는 안 된다. 금액이 같은 주문도 함께 넣어 SUM(DISTINCT amount)처럼 잘못 수정한 경우를 걸러 낸다. 상품이 없는 주문이나 여러 조건에 동시에 부합하는 주문도 포함해 질문의 포함 규칙을 제대로 지키는지 확인한다. 특정 데이터 스냅샷에서 우연히 맞은 결과를 넘어, 조인과 집계가 유지해야 할 규칙 자체를 검증하는 방식이다.
| 구성 | 추가되는 기능 |
|---|---|
| A | 전체 스키마 + 1회 SQL 생성 |
| B | A + Schema Linking |
| C | B + 오류 유형별 Execution Repair |
| D | C + AST 검사, 읽기 전용 실행, 비용 제한 |
실패 케이스를 읽는 법
오류를 세부 단계별로 나눠야 모델 교체, 검색 개선, 규칙 추가 중 어떤 조치가 필요한지 판단할 수 있다.
- 검색 실패: 필요한 컬럼이 프롬프트에서 누락됨 - 생성 실패: 올바른 스키마가 주어졌으나 잘못된 조인을 선택함 - 검증 실패: 잘못된 SQL을 걸러내지 못하고 그대로 실행함 - 운영 실패: 결과는 맞지만 너무 느리거나 비용이 많이 듦 - 보안 실패: 정확한 데이터라도 사용자에게 조회 권한이 없음
오류가 생긴 단계부터 바꾸기
최종 정확도만 보면 검색 실패를 모델 교체로 해결하려 들거나, 실행 성공을 의미상 정답으로 오인하기 쉽다. 동일한 평가셋에서 스키마 검색 누락, 수정 회복률, 위험 쿼리 차단, 지연·비용을 분리해 기록해야 오류가 발생한 단계에 맞춰 정확히 개선할 수 있다.
참고 자료
Spider 2.0: Evaluating Language Models on Real-World Enterprise Text-to-SQL Workflows (https://arxiv.org/abs/2411.07763 (새 창))
Extractive Schema Linking for Text-to-SQL (https://arxiv.org/abs/2501.17174 (새 창))
AutoLink: Autonomous Schema Exploration and Expansion for Scalable Schema Linking (https://arxiv.org/abs/2511.17190 (새 창))
LitE-SQL: Vector-based Schema Linking and Execution-Guided Self-Correction (https://arxiv.org/abs/2510.09014 (새 창))
Google Cloud: Run a query with BigQuery dry run (https://cloud.google.com/bigquery/docs/running-queries (새 창))