검색 벡터를 합치면 무엇이 사라질까: 토큰 풀링과 MaxSim의 손실
문서 벡터를 합치면 저장량은 줄지만 MaxSim 순위가 바뀔 수 있다. 작은 좌표 예시로 손실을 계산하고 압축 학습의 효과와 평균·상한 설정의 차이를 설명한다.
문서의 토큰마다 벡터를 저장해 검색하면 세부 표현까지 비교할 수 있지만 색인 크기가 커진다. 비슷한 벡터를 합치면 저장량은 줄어든다. 그러나 각각은 비슷해 보이는 벡터라도 합치고 나면 질문이 찾던 방향과 멀어질 수 있다. 토큰 풀링의 비용은 벡터 개수뿐 아니라 검색 점수가 어떻게 달라지는지까지 따라가야 제대로 보인다.
Tom Aarsen의 2026년 11월 11일 설명 (새 창)은 압축한 표현으로도 검색할 수 있도록 학습하는 방법을 소개한다. 이 글에서는 그 방법의 손실을 작은 벡터 예시로 풀어본다. 아래 좌표와 경쟁 문서는 설명을 위한 가정일 뿐, 실제 모델 추론이나 GPU 학습을 실행한 결과가 아니다.
최댓값을 주던 벡터가 평균 속으로 들어간다
MaxSim은 질문의 각 벡터마다 내적이 가장 큰 문서 벡터를 찾고, 그 최댓값들을 모두 더한다. 문서 전체를 하나의 벡터로 만든 뒤 한 번만 비교하는 방식과는 다르다. 공식 사용 예제 (새 창)의 토큰 풀링은 인코더 계산이 끝난 문서 벡터들을 묶는다. 기본 설정에서는 질문 벡터를 합치지 않는다.
질문 벡터 하나 q=(1, 0)과 문서 A의 두 벡터 a=(1, 0), b=(0, 1)을 가정하자. 모두 길이가 1이다. 풀링 전 내적은 각각 1과 0이므로 A의 MaxSim 점수는 1이 된다. 두 벡터를 한 묶음으로 합친다고 가정하면 평균은 (0.5, 0.5)이고, 이를 정규화한 벡터는 약 (0.7071, 0.7071)이다. 질문과의 내적은 약 0.7071로 낮아진다.
경쟁 문서 B의 유일한 벡터를 (0.8, 0.6)으로 두면 점수는 0.8이다. 풀링 전에는 A가 앞서지만, 합친 뒤에는 B가 앞선다. 정규화하더라도 A의 순위는 돌아오지 않는다. 벡터 길이가 아니라 질문과 일치하던 방향 자체가 바뀌었기 때문이다. 실제로 이 두 벡터가 합쳐질지는 다른 벡터들과 압축 설정에 달려 있다. 이 계산은 특정 문서가 반드시 잘못 검색된다는 예측이 아니다.
| 문서 | 풀링 전 | 풀링 후 |
|---|---|---|
| A | 1 | 약 0.7071 |
| B | 0.8 | 0.8 |
| 순위 | A > B | B > A |
같은 16개라도 상한과 평균은 다르다
고정 커밋의 구현 (새 창)은 Ward 군집화로 묶음 안의 제곱거리 증가가 작은 병합을 선택하고, 각 묶음의 평균을 정규화한다. 기본적으로 맨 앞 토큰 하나는 병합에서 보호된다. 앞의 2차원 예시는 이 보호 토큰을 제외한 두 벡터의 병합만 떼어 본 것이다.
문서마다 최대 16개를 원한다면 max_tokens=16을, 길이에 비례해 대략 4분의 1을 남기려면 pool_factor=4를 고른다. distance_threshold는 같은 Ward 거리 기준으로 자르므로 문서의 벡터 배치에 따라 남는 수가 달라진다. 세 제어 방식은 하나씩 선택한다.
공식 문서의 보정 절차 (새 창)에서 target_tokens=16은 표본 문서의 평균을 목표로 삼는다. 모든 문서를 16개 이하로 제한한다는 뜻이 아니다. 가령 두 문서가 각각 8개와 24개를 남겨도 평균은 16개다. 문서별 상한이 필요한 저장 구조에 이 평균 목표를 그대로 적용하면 긴 문서가 한도를 넘길 수 있다. 이 숫자는 실제 보정 결과가 아니라 의미를 설명하기 위한 예시다.
짧은 문서가 많으면 max_tokens=16으로 얻은 실제 평균도 16보다 작아진다. 같은 저장 예산에서 적응형 풀링과 비교하려면 먼저 상한 방식의 실제 평균을 구한 뒤 그 값에 맞춰 보정한다. 새 자료가 들어와 벡터 분포가 바뀌면 예전의 거리 임계값이 같은 평균을 보장하지는 않는다.
원래 표현과 합친 표현을 함께 학습한다
풀링은 인코더 뒤에서 일어나므로 벡터를 합쳤다고 해서 인코더의 입력 토큰 계산량이 줄어들지는 않는다. 줄어드는 것은 주로 저장하고 비교할 문서 벡터의 수다. 오히려 군집화 계산이 추가된다. 따라서 검색 지연 시간과 색인 생성 시간을 같은 절약률로 계산할 수 없다.
공식 학습 예제 (새 창)는 원래 표현의 검색 손실과 pool_factor=4로 압축한 표현의 검색 손실을 같은 가중치로 더한다. 이미 계산한 임베딩을 두 경로에서 재사용하므로 풀링 설정마다 인코더를 다시 돌리지는 않는다. 추가 비용은 군집화와 점수 계산 등에서 발생한다.
앞의 A가 정답이고 B가 오답인 학습 쌍을 떠올려 보면, 압축 후 A가 밀리는 현상도 손실에 반영할 수 있다. 이는 합친 표현으로도 정답을 구분할 수 있게 인코더를 바꾸는 방향이다. 이미 평균으로 합쳐져 사라진 정보를 검색 시점에 복원하는 장치는 아니다. Ward의 이산적인 묶음 선택 자체를 미분하지 않고, 풀링 결과의 기울기를 구성 토큰으로 전달하는 straight-through estimator를 사용한다.
곡선이 올라가도 압축 손실이 없어지지는 않는다
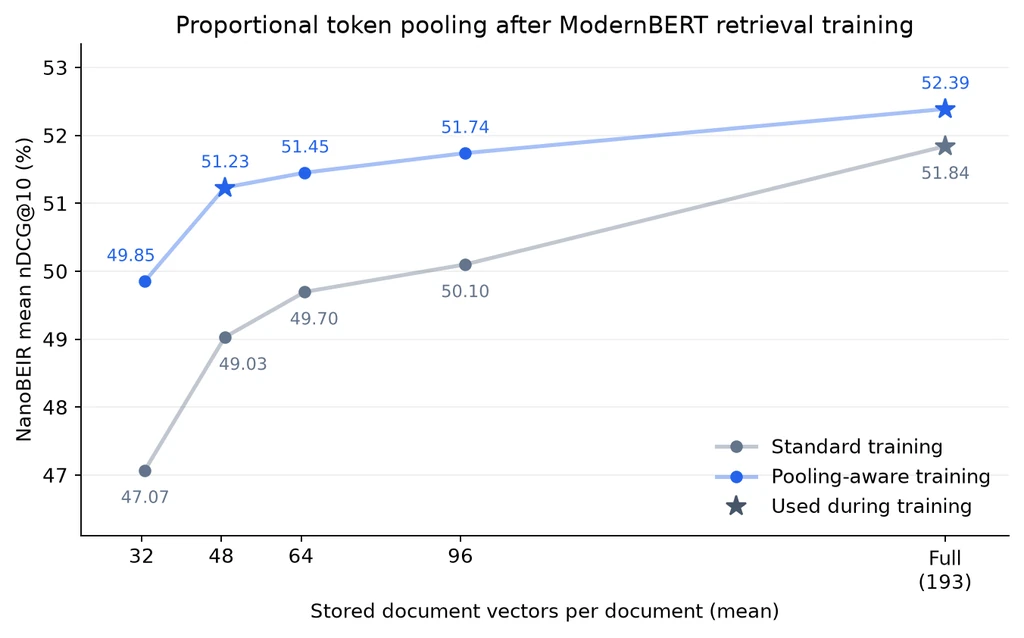
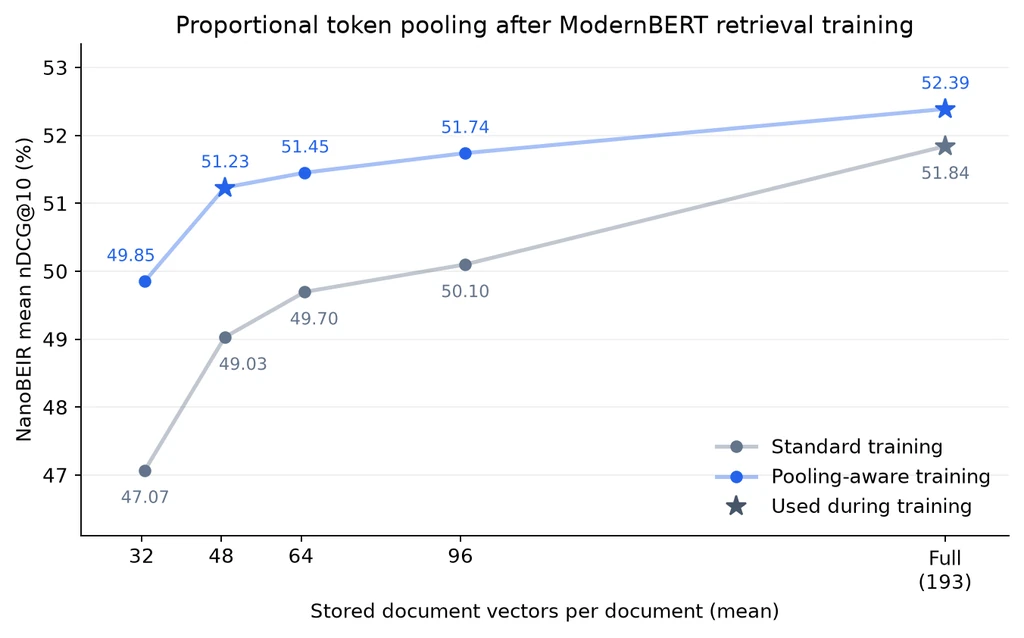
공식 실험 (새 창)은 같은 ModernBERT 초기화·데이터·최적화 조건에서 손실만 바꾼 두 모델을 비교한다. 아래 그림의 가로축은 문서당 평균 벡터 수, 세로축은 NanoBEIR 평균 nDCG@10(%)다. 회색은 일반 학습, 파란색은 풀링을 고려한 학습이며 별은 학습에 사용한 표현을 뜻한다. 처리 시간 그래프가 아니다.
평균 약 48개 지점에서 파란색 51.23은 회색 49.03보다 높다. 같은 압축량에서 학습 목적의 차이를 보여주는 비교다. 반면 파란색의 원래 표현은 52.39다. 51.23을 이 값과 비교해 보면 압축 손실이 여전히 남아 있음을 알 수 있다. 파란 선이 회색 선보다 높다는 사실을 무손실 압축으로 받아들여서는 안 된다.
실무에서는 같은 질문·정답 문서로 압축 전후 순위가 바뀐 사례부터 살펴볼 수 있다. 앞의 A처럼 희소한 조건을 맞추던 벡터가 합쳐졌는지, 저장 예산을 조금 늘리면 정답이 돌아오는지 비교하는 방식이다. 여기서 제안하는 평가는 실제로 실행하지 않았다. 벡터 수와 검색 품질의 맞교환을 먼저 확인하고, 인코딩·군집화·검색 시간을 별도로 측정해야 도입할 압축 수준을 정할 수 있다.