GraphRAG로 일부 질문을 해결해도 전체 정확도가 떨어질 수 있는 이유
관계 탐색이 복구한 질문과 새로 틀린 질문을 함께 세고, 동일한 검색 조건에서 그래프의 순효과와 갱신 비용을 비교한다.
그래프를 도입하면 관계 추출 오류와 운영 부담이 따른다. 공개된 연구와 문서를 바탕으로 어떤 질문에 추가 경로가 필요한지 판단할 기준을 정리한다.
HopRAG와 Microsoft GraphRAG는 관계를 표현하고 검색하는 방식이 다르다. 아래 비교는 두 연구를 참고한 설계 제안이다.
비교 대상
제대로 비교하려면 생성 모델, 임베딩 모델, 청크 크기와 최종 컨텍스트 예산을 고정해야 한다. 다음 표는 구성 예시다. 초기 검색 방식이 밀집 벡터와 하이브리드로 서로 다르므로, 순수하게 그래프만의 효과를 확인하려면 하이브리드 검색에 그래프 탐색을 추가한 조건과 그렇지 않은 조건도 비교해야 한다.
GraphRAG가 엔티티 그래프 하나만 뜻하는 것은 아니다. HopRAG는 패시지와 논리적 관계를 활용해 유사도 검색에서 놓칠 수 있는 근거를 탐색한다. 이 방식을 적용할 때는 초기 검색과 그래프 확장의 역할을 구분해야 한다.
| 구분 | Vector RAG | GraphRAG |
|---|---|---|
| 인덱스 | 문서 청크의 임베딩 | 청크 + 논리 관계를 가진 패시지 그래프 |
| 초기 검색 | 밀집 벡터 유사도 기반 top-k | 밀집·희소 벡터 하이브리드 검색 |
| 확장 | 없음 또는 재정렬 | 검색된 패시지에서 관련 간선을 따라 멀티홉 탐색 |
| 최종 컨텍스트 | 유사도 상위 청크 | 초기 검색 + hop으로 찾은 근거를 가지치기 |
정확도 평가 기준
RAG를 단일 정답률로만 평가하면 실패 지점을 파악하기 어렵다. 검색 실패, 추론 실패, 출처 오류를 분리해서 봐야 한다.
평가는 다음 여섯 가지 축으로 나눈다.
Evidence Recall: 정답에 필요한 근거가 최종 컨텍스트에 들어왔는가
Answer Correctness: 답의 핵심 사실이 맞는가
Faithfulness: 답의 각 주장이 검색된 근거로 뒷받침되는가
Citation Accuracy: 표시한 출처가 실제 주장과 일치하는가
Latency: 검색, 탐색, 생성을 합친 p50/p95 응답 시간
Cost: 인덱싱 비용과 질의당 LLM·임베딩·토큰 비용
특히 Evidence Recall과 Answer Correctness는 분리해야 한다. 근거가 컨텍스트에 있는데도 답이 틀렸다면 검색 문제가 아니다. 반대로 자연스러운 답을 내놓았지만 필요한 근거가 없었다면 생성 모델이 빈칸을 임의로 메운 것이다.
질문 유형별 검색 방식 검토
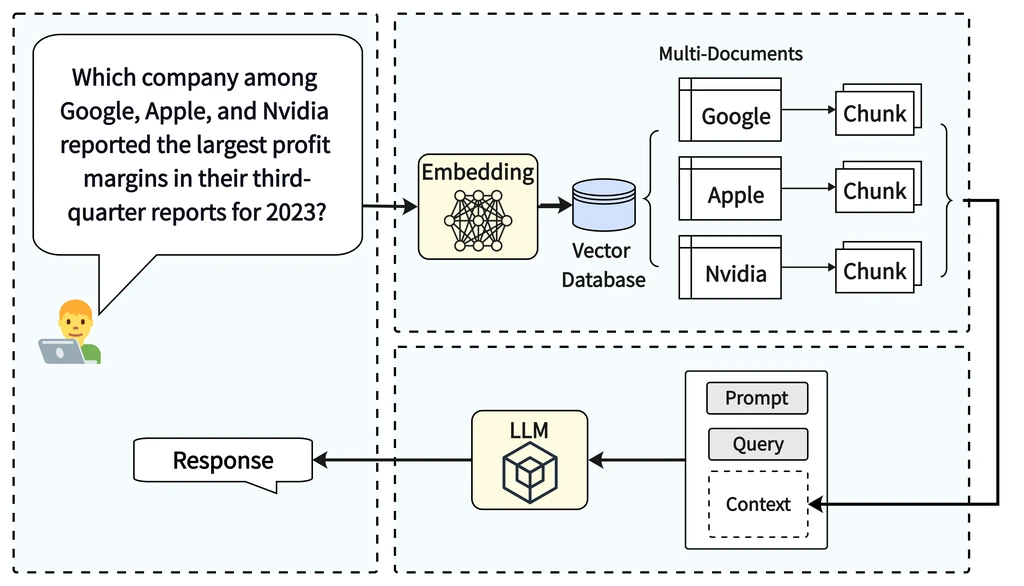
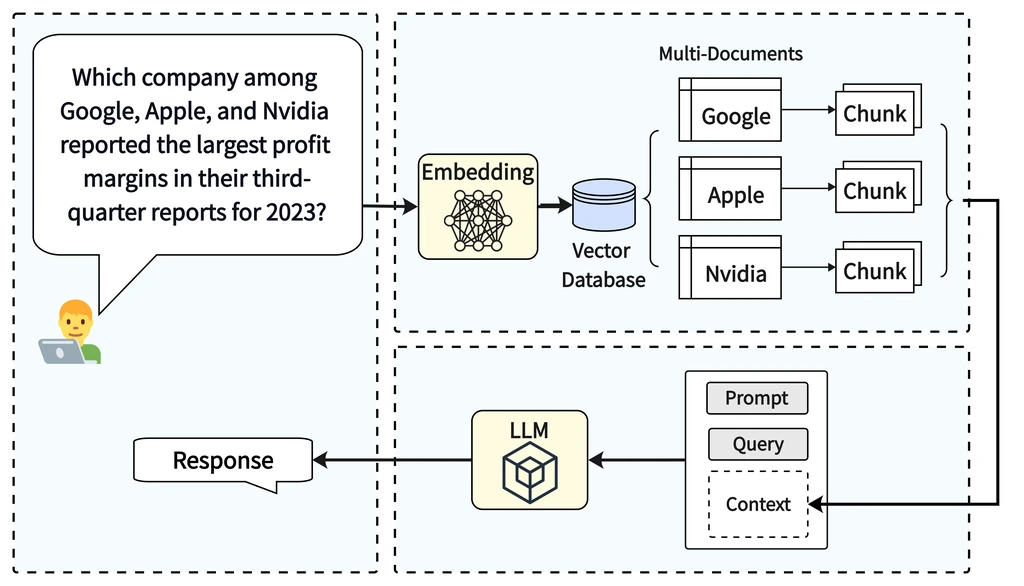
비교 평가에서 멀티홉 질문은 별도 유형으로 분리해야 한다. 여러 문서의 조건을 동시에 만족하는 답을 찾아야 할 때, 질문과 닮은 청크를 모으는 것만으로 필요한 중간 근거를 모두 확보할 수 있는지 확인이 필요하다.
GraphRAG는 첫 번째 검색 결과가 완벽하지 않아도 이를 징검다리로 삼을 수 있다. 고객 → 제품 → 계약 조건 → 지원 정책으로 이어지는 경로를 따라가며 직접적인 유사도가 낮은 근거에 도달한다. 이는 유사도와 논리적 관련성이 다르다는 HopRAG의 지적과 맞닿아 있다. 다만 실제 업무 문서에서도 같은 효과가 나는지는 별도로 평가해 봐야 한다.
| 질문 유형 | 검토 후보 | 이유 |
|---|---|---|
| 단일 사실 조회 | Vector RAG | 정답 청크가 질문과 의미적으로 가깝다 |
| 정확한 제품명·코드 검색 | Hybrid Vector RAG | 정확한 식별자 검색에 keyword 결합을 검토할 수 있다 |
| 두 문서의 조건 비교 | GraphRAG | 각 조건의 근거를 연결해 가져오기 쉽다 |
| 원인 → 정책 → 결과 추적 | GraphRAG | 중간 패시지를 징검다리로 사용할 수 있다 |
| 문서군 전체의 공통 주제 요약 | GraphRAG | 커뮤니티 또는 관계 구조가 전역 질문에 맞다 |
| 최근 추가·수정된 문서 조회 | Vector RAG | 증분 인덱싱이 단순하고 그래프 노후화 위험이 작다 |
관계 탐색이 추가 오류를 만드는 경우
단일 사실 질문에서는 초기 검색만으로 정답 청크를 찾을 수 있다면 그래프 탐색이 불필요할 수 있다. 후보를 늘리는 과정에서 비슷한 제품이나 오래된 정책이 컨텍스트에 섞여 들어오는지도 평가해야 한다.
여러 근거를 결합해야 하는 질문은 GraphRAG의 효과를 검증하기 좋은 후보다. 단, 그래프가 올바른 관계를 담고 있어야 한다. 엔티티 연결이나 간선 생성이 잘못되면 오히려 엉뚱한 경로를 더 확신하며 따라가게 된다. 검색 재현율이 높아진다고 해서 충실도가 자동으로 높아지는 것은 아니다.
따라서 정확도를 비교할 때는 전체 평균보다 쿼리 slice를 들여다보는 것이 중요하다. 최소한 단일 홉, comparison, causal, temporal, global-summary는 따로 측정해야 한다. 전체 질문의 대부분이 단일 사실 조회라면, 소수의 멀티홉 성능을 높이자고 전체 시스템을 GraphRAG로 바꾸는 것은 과한 설계일 수 있다.
예를 들어 가상의 평가셋에 단일 사실 질문 900개와 관계 결합 질문 100개가 있다고 해보자. 그래프 확장으로 후자의 정답이 10개 늘더라도 전자의 정답이 18개 줄면 전체 정답은 8개 감소한다. 멀티홉 유형의 10%포인트 개선만 보고 전체 시스템을 교체하면 이 손실을 놓치게 된다. 이는 논문 수치가 아니라 질문 분포가 의사결정에 미치는 영향을 보여 주는 예시다.
관계 질문만 골라내는 라우터 역시 공짜가 아니다. 그래프가 필요한 질문을 놓친 비율과 불필요하게 그래프를 호출한 비율을 따로 집계하고, 라우터까지 포함한 최종 정답 수와 비용을 비교한다. 정답 유형을 미리 알려 주는 이상적인 라우팅 결과는 상한선으로만 삼고 실제 분류기의 결과와 구분한다.
동일한 하이브리드 검색 결과를 출발점으로 삼아 확장 없음, 후보 수 확대, 그래프 확장을 비교하면 원인을 더 좁힐 수 있다. 문서 버전과 최종 토큰 예산을 고정하고, 그래프가 가져온 중간 근거가 실제 답변 생성에 쓰였는지도 확인한다. 연결된 근거가 늘었다는 관찰과 답이 나아졌다는 관찰은 별개의 결과다.
중간 근거를 놓친 질문에서 확장 효과 측정
Vector 검색은 질문과 닮은 문장을 잘 찾아내고, 그래프 탐색은 그 근거 다음에 무엇을 봐야 하는지를 표현한다.
멀티홉 평가 문제는 다음과 같은 형태로 구성할 수 있다.
한 문서의 제품 사양과 다른 문서의 계약 조건을 결합하는 질문
과거 회의록의 결정이 최신 정책에 어떻게 반영됐는지 묻는 질문
고객, 제품, 장애 원인, 해결 방법을 순서대로 추적하는 질문
표나 이미지에서 추출한 값과 본문 설명을 함께 써야 하는 질문
동일한 컨텍스트 예산 안에서 단순 top-k 확대와 관계 탐색을 비교한다. 관계를 따라 찾은 근거가 단순히 검색량을 늘린 결과보다 실제로 더 유용한지 확인해야 한다.
질의 지연과 인덱싱·갱신 비용
Vector RAG는 임베딩, 벡터 search, rerank, 생성으로 이어져 경로가 짧다. 반면 GraphRAG는 간선 검색, hop별 판단, 후보 가지치기가 추가된다. 탐색 과정에 LLM을 사용하면 hop 수만큼 응답 시간도 길어진다.
질의 비용뿐만 아니라 인덱싱 비용도 고려해야 한다.
엔티티·관계 또는 의사 질의 추출을 위한 LLM 호출
간선 후보 생성과 품질 필터링
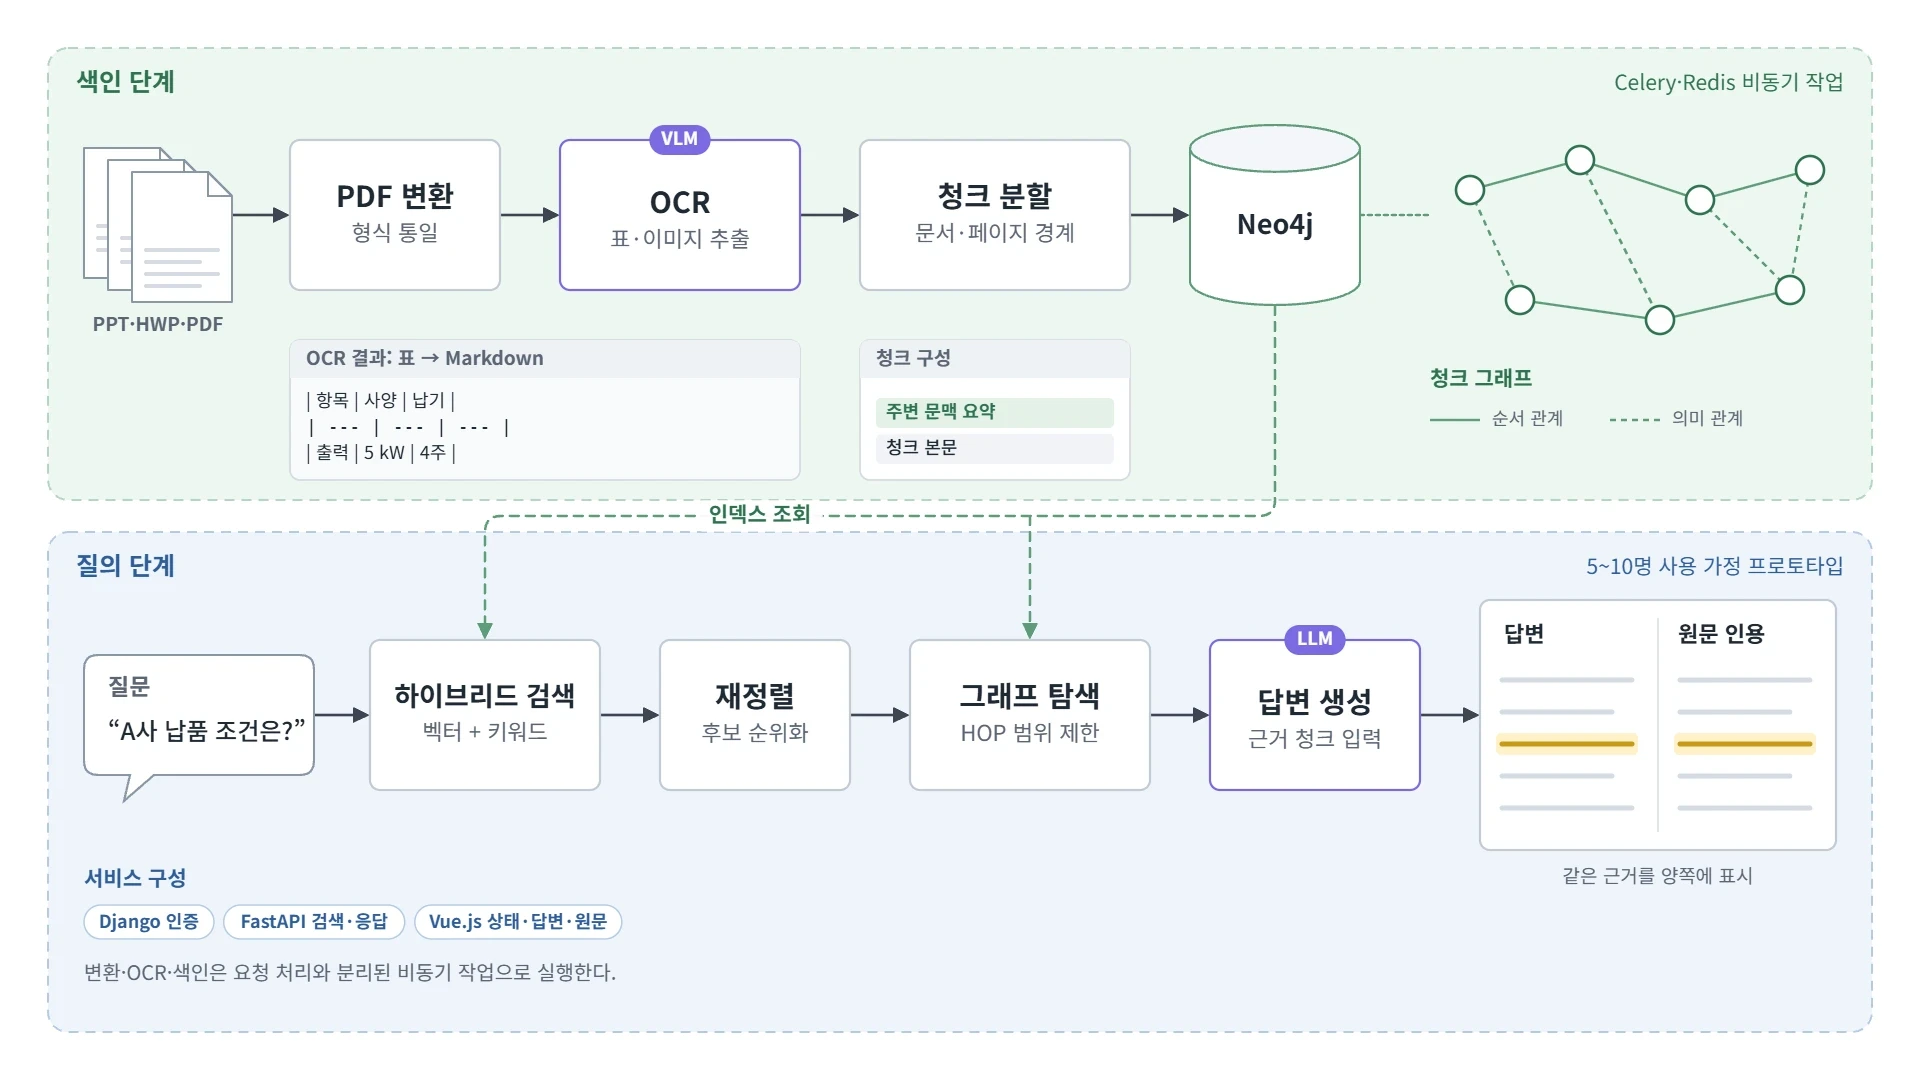
그래프 저장소와 벡터 index의 동시 운영
문서 변경 시 영향받은 노드와 간선의 재계산
검색 결과뿐 아니라 탐색 경로 자체를 디버깅하기 위한 관측성 확보
Microsoft GraphRAG 문서에서도 표준 방식의 그래프 추출이 인덱싱 비용의 상당 부분을 차지한다고 설명한다. 데이터가 자주 바뀌는 서비스라면 초기 구축비보다 그래프를 최신 상태로 유지하는 비용이 더 큰 부담이 된다.
질문 유형별 라우팅도 고려해 볼 만한 설계 후보다. 단일 사실 질문은 Vector RAG로 처리하고 관계 탐색이 필요한 질문만 그래프로 보내는 방식을 비교해 볼 수 있다. 충분한 근거를 찾았을 때 탐색을 멈추는 조건도 함께 평가한다.
관계의 출처와 갱신 이력까지 운영하기
Vector RAG는 청크와 임베딩의 품질이 핵심이다. 반면 GraphRAG는 여기에 ontology, 엔티티 resolution, 간선 스키마, 탐색 policy가 더해진다.
그래프를 도입하는 순간 단순한 검색 파이프라인이 아니라 데이터 모델을 운영하게 된다. 관계가 왜 만들어졌는지, 언제 낡았는지, 어떤 문서에서 왔는지 추적할 수 있어야 한다. 이 메타데이터가 없으면 오답이 발생했을 때 원인을 찾기 어렵다.
| 운영 항목 | Vector RAG | GraphRAG |
|---|---|---|
| 증분 업데이트 | 변경 청크 재임베딩 | 노드·간선 영향 범위 재계산 |
| 디버깅 | 질의와 top-k 비교 | 초기 검색 + 이동 경로 + 가지치기 확인 |
| 품질 모니터링 | 검색 드리프트 | 검색 드리프트 + 그래프 드리프트 |
| 스키마 변경 | 영향이 작음 | 재추출·마이그레이션 가능성 |
| 장애 지점 | 파서, 임베딩, 벡터 DB | 왼쪽 항목 + 추출기, 연결기, 그래프 DB, 탐색 |
점검할 실패 가능성
그래프 확장의 위험
첫째, OCR이 불안정한 문서. 표의 열이 섞이거나 제품 코드가 잘못 읽히면 잘못된 엔티티와 간선이 만들어진다. Vector RAG에서는 단일 청크의 오류로 끝날 수 있지만, 그래프에서는 오류가 이웃 노드로 전파된다.
둘째, 관계가 약한 문서군. FAQ나 독립적인 매뉴얼처럼 각 문서가 그 자체로 완결되어 있으면 연결 구조가 별다른 가치를 만들지 못한다.
셋째, 빠르게 변하는 정책. 새 문서를 임베딩하는 속도보다 그래프 갱신이 늦어지면 최신 청크와 오래된 간선이 충돌한다.
넷째, 모호한 엔티티. 약어, 동명이인, 버전명이 많은 도메인에서는 엔티티 resolution이 핵심 병목이 된다. 잘못 합친 노드는 검색 범위를 불필요하게 넓히고, 잘못 나눈 노드는 필요한 탐색 경로를 끊어 버린다.
Vector RAG의 한계
첫째, 질문에 정답 표현이 직접 등장하지 않는 경우. 논리적으로 필요한 중간 문서는 semantic similarity가 낮아 top-k 밖으로 밀려난다.
둘째, 여러 문서의 제약 조건을 동시에 만족해야 하는 경우. 개별 근거는 찾더라도 그것들이 같은 고객·제품·시점에 대한 내용인지 연결하기 어렵다.
셋째, 전역 질문. 전체 고객군에서 반복되는 장애 패턴은?처럼 문서 집합 전체의 구조를 묻는 질문은 개별 청크 검색만으로 대표성을 확보하기 어렵다.
도입 기준
도입 여부는 다음 순서로 검토한다.
Vector RAG를 먼저 구축하고 파서, 청킹, 메타데이터, 하이브리드 검색, reranker를 안정화한다.
실패한 질문을 수집한다. Vector RAG가 실제로 놓친 근거를 모은다.
멀티홉 비중을 측정한다. 필요한 근거가 둘 이상이고 문서 간 연결이 필수인 질문의 비율을 확인한다.
작은 그래프 계층을 붙인다. 전면 교체하기보다 핵심 엔티티와 관계만 구성하고 벡터 검색 결과에서 1~2 hop만 확장한다.
라우팅한다. 단일 홉은 벡터로, 멀티홉과 전역 질의만 그래프로 보낸다.
같은 예산으로 평가한다. 동일한 최종 컨텍스트 토큰과 지연 시간 예산 안에서 비교한다.
GraphRAG 도입 여부를 판단하는 신호는 시각화가 아니라, Vector RAG가 실패한 질문 중 올바른 관계 탐색으로 복구되는 비율이다. 이 복구로 얻는 이득이 인덱싱·운영·지연 비용을 감수할 만큼 클 때 그래프 도입을 검토한다.
실패 질문으로 그래프 확장 필요성 판단
먼저 현재 검색기가 놓친 질문과 근거를 모은다. 동일한 초기 검색 결과에서 그래프 확장 유무만 달리해 비교하면 하이브리드 검색과 그래프의 효과가 뒤섞이는 것을 줄일 수 있다.
복구된 질문의 비율과 함께 추가로 발생하는 지연·인덱싱·갱신 비용을 기록한다. 특정 유형에서만 이득이 확인된다면 해당 질문에만 그래프를 호출하는 구성을 제안한다.
참고: Microsoft GraphRAG Overview (https://microsoft.github.io/graphrag/index/overview/ (새 창)) · GraphRAG Indexing Methods (https://microsoft.github.io/graphrag/index/methods/ (새 창)) · HopRAG: Multi-Hop Reasoning for Logic-Aware RAG (https://arxiv.org/abs/2502.12442 (새 창)) · MultiHop-RAG Benchmark (https://arxiv.org/abs/2401.15391 (새 창))
참고 자료
Microsoft GraphRAG Overview (https://microsoft.github.io/graphrag/index/overview/ (새 창))
HopRAG: Multi-Hop Reasoning for Logic-Aware RAG (https://arxiv.org/abs/2502.12442 (새 창))
MultiHop-RAG Benchmark (https://arxiv.org/abs/2401.15391 (새 창))