이상 패턴을 메모리에 넣으면 다음 경보는 낮아질까: TimeRep의 갱신 위험
중간 표현 기반 이상 점수의 원리와 메모리 오염을 구분하고, 미래 데이터 대기 시간과 검증 분할을 함께 점검한다.
중간 표현과 정상 메모리로 이상 점수 만들기
마지막 출력이 이상 탐지에 가장 적합한가
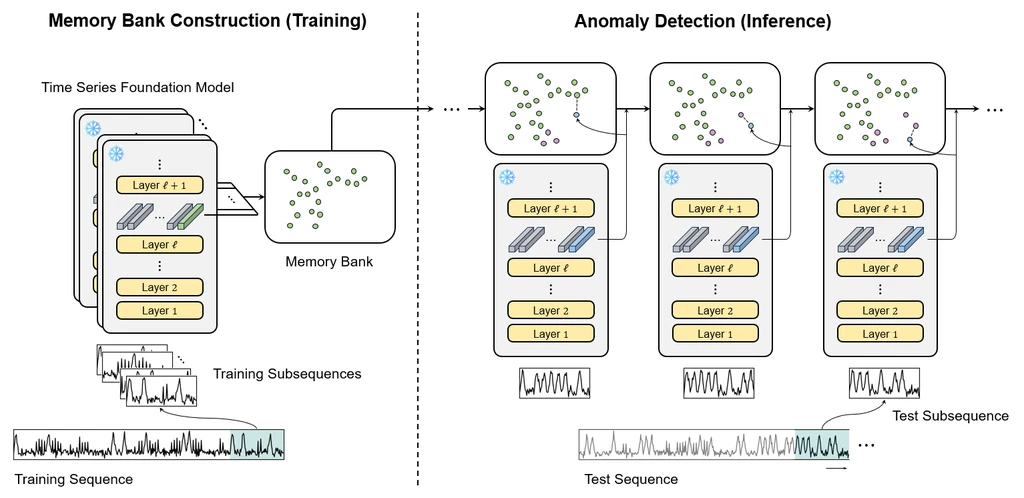
시계열 파운데이션 모델(TSFM)은 사전학습의 예측·복원 목적과 이상 탐지 목적 사이에 차이가 있고, 데이터 분포 변화에도 영향을 받는다. 마지막 레이어는 사전학습 목적에 맞춰져 있으므로 이상 탐지에는 중간 레이어의 표현이 더 적합할 수 있다.
재구성이나 예측 오류가 이상 여부와 항상 일치하지는 않는다.
Reconstruction head: 이상 패턴까지 과도하게 복원해 이상을 정상처럼 재현한다.
Forecasting head: 미래가 불안정한 구간에서 예측 실패율이 급증한다.
또한 학습 후 기준을 고정하면 정상 데이터 분포가 바뀔 때 대응하기 어렵다. 이 때문에 TimeRep은 테스트 중에 메모리를 갱신하는 방식을 결합한다.
레이어·윈도우 정렬·거리 함수의 선택
레이어 선택 근거는 다음과 같다.
초기 레이어: 지역적이고 단순한 저수준 특징에 머문다.
후반 레이어: 사전학습 목적에 과도하게 편향된다.
중간 레이어(16/24): 가장 일반화된 표현을 제공하며, 이전 NLP/CV 연구 결과와도 일치한다.
윈도우 정렬 방식에 따른 성능(Top-1) 차이는 다음과 같다.
Last-aligned (현재 시점이 윈도우 끝): 72.8%
Center-aligned (현재 시점이 윈도우 중앙): 77.6%
미래 컨텍스트를 함께 볼 수 있는 구조가 표현 품질을 높이지만, 실시간 스트리밍에서는 지연(latency)이 발생한다.
거리 함수 비교에서 Mahalanobis는 역행렬 계산에 실패한 20개를 제외한 230개 시계열 기준이며, Euclidean과 밀도 기반 거리 수치도 이 조건을 감안해 해석해야 한다.
Core-set 압축과 적응형 메모리
Core-set 압축을 쓰면 메모리 뱅크를 줄이면서도 정확도를 유지할 수 있다. 다만 장치별 실제 속도와 메모리 사용량은 배포 환경에서 측정해야 한다.
Test-Time Adaptive Memory Bank(TTAMB)는 모델 파라미터를 동결(gradient 불필요)한 채, 새로운 표현이 기존 뱅크와 충분히 다를 때만(80th percentile 임계값) 메모리에 추가한다. 이때 새로운 패턴을 걸러내는 Novelty threshold와 이상을 판별하는 Anomaly threshold의 역할은 명확히 분리한다.
250개 단변량 시계열의 평가 범위
TimeRep은 파인튜닝 없이 중간 표현만으로 250개 단변량 시계열에서 높은 성능을 냈다. 다른 파운데이션 모델, 다변량 데이터, 실시간 스트리밍 조건에서도 같은 우위가 유지되는지는 별도 검증이 필요하다.
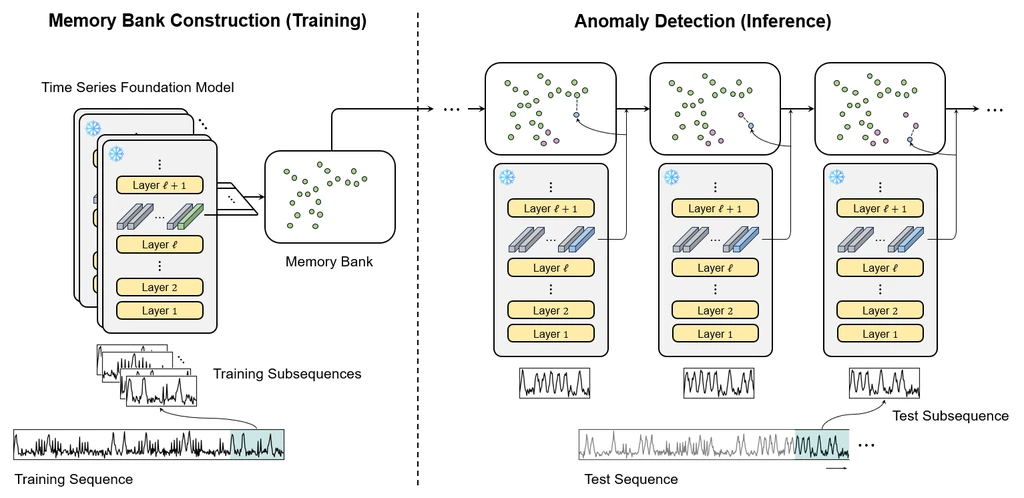
Pre-trained TSFM (MOMENT-Large, 24 layers)
        ↓
  Intermediate Layer 선택 (16번째 레이어 → 실험적 최적)
        ↓
  Patch-level Representation 추출
        ↓
  Memory Bank 구성 (Training 정상 데이터 기반)
        ↓
  Core-set 압축 (k-Center greedy, NP-hard 근사)
        ↓
  Inference: 거리 기반 Anomaly Score 계산
        ↓
Test-Time Adaptive Memory Bank (Concept Drift 대응)| 방법 | 특징 | 성능 |
|---|---|---|
| Euclidean | 단순, 안정적 | 69.6% (기본) |
| Mahalanobis | 공분산 반영, 역행렬 불안정 | 67.4% (데이터 부족 시 실패) |
| Density-aware | 이웃 밀도 반영 | 69.6~70.8% |
| 카테고리 | 최강 baseline | TimeRep (center) |
|---|---|---|
| non-DL | DAMP: 63.2% | 77.6% |
| DL | TimeVQVAE-AD: 66.8% | 77.6% |
| Foundation (fine-tuning) | MOMENT: 32.8% | 77.6% |
논문 설정을 옮길 때 확인할 항목
메모리와 속도의 트레이드오프
Core-set 크기는 환경에 맞게 조절(1k~10k)한다. 크기를 1k로 줄여도 center-aligned 기준 75% 이상의 성능을 유지해 메모리 축소 가능성을 보였지만, 엣지 장치에서의 실제 지연 시간과 메모리 사용량은 별도로 측정해야 한다.
실시간 스트리밍 적용 조건
Center-aligned 방식은 미래 데이터를 요구하므로 지연을 허용할 수 있는지부터 판단해야 한다. 즉각적인 실시간 처리가 필요하다면 정확도를 일부 양보하고 Last-aligned(72.8%) 방식을 택한다.
TTAMB 메모리 관리
테스트 중 메모리에 항목이 계속 추가되면 뱅크 크기가 무한정 커질 수 있으므로, 상한선을 설정하고 오래된 항목을 지우는 eviction 정책을 별도로 설계해야 한다.
거리를 이상 점수로 쓰는 단순 예시로, 정상 메모리에 0이라는 표현만 있고 새 표현이 10이라고 하자. 최근접 거리는 10이다. 그런데 단지 새롭다는 이유로 10을 메모리에 추가하면, 다음에 같은 10이 들어왔을 때 거리는 0이 된다. 모델 파라미터를 바꾸지 않아도 기준 집합이 바뀌면서 경보가 낮아지는 것이다. 이는 TimeRep의 실제 수치가 아니라 메모리 오염 가능성을 설명하는 1차원 반례다.
새 패턴이 정상적인 계절 변화인지 지속되는 이상인지는 거리만으로 자동 확정되지 않는다. 같은 시간순 데이터에서 고정 메모리, 제한 없이 갱신한 메모리, 별도 검토나 지연을 둔 갱신 정책을 비교할 수 있다. 나중에 정답이 확인된 이상 구간이 메모리에 들어간 비율과, 같은 유형에서 뒤이어 발생한 누락을 연결해 기록한다. 평가용 미래 라벨로 과거의 갱신 여부를 미리 결정하면 실제 온라인 운영 조건과 달라진다.
미래 문맥을 쓰는 정렬에는 비용도 따른다. 예를 들어 1초 간격의 관측에서 현재 시점 이후 30개가 필요한 창이라면 최소 30초의 데이터 대기가 생긴다. 모델 계산이 1ms라고 해서 경보 지연도 1ms인 것은 아니다. 데이터 대기·전처리·모델·후처리를 합쳐 보고, 지연을 허용할 수 없는 업무라면 과거만 사용하는 조건을 별도로 평가한다.
| 컴포넌트 | 선택 사항 | 근거 |
|---|---|---|
| TSFM | MOMENT-Large | encoder-only, open source |
| Layer hook | 16번째 (24개 중) | 실험적 최적 |
| Similarity search | FAISS (faiss-cpu) | 대규모 NN 탐색 효율 |
| Core-set | k-Center greedy | NP-hard 문제의 실용적 근사 |
| Distance | Euclidean | 안정성과 성능의 균형 |
| Threshold | 분포 기반 (80th pct) | 하이퍼파라미터 최소화 |
검증이 필요한 확장 제안
여러 레이어를 결합하거나 메모리를 갱신한다고 해서 정확도가 자동으로 높아지지는 않는다. 따라서 구조를 확장할 때는 같은 데이터에서 표현 선택·탐지 임계값·메모리 오염을 함께 비교해야 한다.
① Multi-layer 앙상블: 단일 레이어(16번째) 대신 여러 레이어의 표현을 가중 합산하거나 이어 붙여 다양한 추상화 수준의 정보를 활용한다. CKA(Centered Kernel Alignment)로 레이어 간 상보성을 측정해 가중치를 설계한다.
② Patch 위치 앙상블: Center patch 하나만 쓰지 않고 주변 패치들의 표현을 max-pooling이나 attention 가중치로 결합해 표현의 견고함을 높인다.
③ TTAMB Eviction 전략: 메모리 뱅크 크기가 상한을 넘을 때 항목을 제거하는 정책을 추가한다. LRU(Least Recently Used) 기반 제거, 밀도 기반 중복 항목 정리, 계절성 주기를 반영한 시간 가중 제거를 적용할 수 있다.
④ Multivariate 확장: 다변량 시계열로 확장할 때는 채널 간 상관관계를 표현에 반영하는 방식과, 채널별 독립 Memory Bank 및 통합 Bank 사이의 트레이드오프를 고려해야 한다. CATCH(ICLR 2025)의 channel-aware 접근법을 참고할 수 있다.
⑤ Adaptive Layer Selection: 도메인이나 데이터셋마다 최적 레이어가 다를 수 있으므로, 소량의 라벨 데이터나 검증 세트를 활용해 레이어를 동적으로 선택하는 메타러닝 방식을 적용한다.
⑥ Distance Function 개선: 고차원 공간에서 분별력이 떨어지는 Euclidean 거리의 한계를 보완하기 위해 코사인 유사도 기반 정규화 거리, 대조 학습(contrastive learning)으로 사전학습한 거리 지표, 계층적 구조를 포착하는 쌍곡 공간(Hyperbolic space) 거리를 대안으로 검토한다.
⑦ Representation Quality 평가 체계: 이상 라벨 없이도 레이어나 패치의 품질을 평가할 수 있도록 고유 차원(Intrinsic dimensionality)이나 등방성(isotropy) 같은 지표로 최적 레이어를 자동 선택한다.
⑧ Foundation Model 다양화: MOMENT-Large 외에 Chronos, Timer, Sundial 등 다른 TSFM의 중간 레이어 표현 품질을 비교하고, 어떤 사전학습 방식이 이상 탐지에 유리한 표현을 만드는지 분석한다.
⑨ Concept Drift 유형별 대응: 점진적(gradual) 변화와 급격한(abrupt) 변화에 따라 novelty threshold나 eviction 정책을 다르게 조정한다. 이때 이상 패턴이 정상 메모리에 편입되어 이후 이상 점수가 낮아지는 메모리 오염 위험을 반드시 함께 점검해야 한다.
실시간 조건과 메모리 오염부터 확인하기
실시간 환경에 도입하기 전에는 미래 구간을 쓰지 않는 정렬 조건에서 고정 메모리와 갱신 메모리의 성능을 비교해야 한다. 250개 UCR 단변량 시계열 결과를 제조·의료·IT 인프라에 적용할 때는 데이터별 임계값, concept drift에 따른 오탐·누락, 이상 표현의 메모리 편입 위험을 함께 검증해야 한다.
참고 자료
Leveraging Intermediate Representations of Time Series Foundation Models for Anomaly Detection (https://arxiv.org/abs/2509.12650 (새 창))