CANVAS는 무엇을 기억하고 바꾸나: 재등장 장면의 기준과 소품 상태
같은 인물과 장소는 유지하되 컵의 위치는 행동에 따라 바뀌어야 한다. 네 장면의 상태를 추적하며 CANVAS의 기준 이미지 검색과 선택 후 메모리 갱신이 맡는 역할을 설명한다.
Google Research의 Yale Song과 Yiwen Song은 2026년 9월 24일 긴 영상 생성 연구 소개 (https://research.google/blog/coherent-long-form-video-generation/ (새 창))에서 Ishani Mondal 외 저자들이 2026년 4월 15일 제출한 CANVAS 논문 (https://arxiv.org/abs/2604.13452 (새 창))을 다뤘다.
직전 장면만 기억하면 재등장한 장소를 놓친다
한 인물이 작업실에서 복도로 나갔다가 돌아오는 이야기를 만들 때, 직전 복도 이미지는 다음 동작을 이어 주지만 작업실의 창과 탁자 위치까지 알려 주지는 않는다. 같은 인물인지 확인할 기준과 다시 찾은 장소의 배치를 불러올 기준이 각각 필요하다.
논문의 제안 방법 (https://arxiv.org/html/2604.13452v1#S3 (새 창))은 전체 대본에서 인물의 외형 상태, 장소, 소품의 변화를 먼저 계획한다. 이어지는 장면에는 직전 프레임과 인물 기준을, 장소가 다시 등장하는 장면에는 해당 장소와 현재 인물 외형의 기준 이미지를 가져온다. 후보를 생성한 뒤에는 계획에 맞는지 질문·응답 방식으로 검사하고, 선택 결과로 기억을 갱신한다.
이 방식은 기존 이미지 생성 모델 위에서 동작하는 학습 없는 오케스트레이션이다. 별도 모델 학습은 없지만 생성과 평가 호출은 발생하므로, 도입 시 기준 이미지 저장 비용과 함께 후보 생성 횟수 및 평가 호출 비용을 실행 예산에 반영해야 한다.
같은 컵이라도 위치까지 고정하면 이야기가 틀어진다
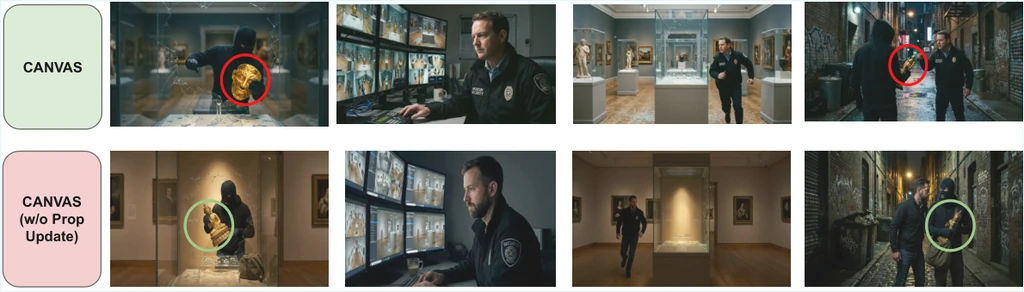
일관성 유지는 고정과 변경을 모두 포함한다. 같은 컵의 모양이 갑자기 달라지면 오류지만, 인물이 컵을 탁자에 내려놓은 뒤에도 여전히 손에 들려 있다면 그 역시 오류다. CANVAS는 소품이 사라진 배경을 갱신하고 대본에 필요한 여러 외형 상태를 보존한다. 이는 과거 이미지를 단순히 더 많이 참조하는 것만으로는 해결할 수 없다.
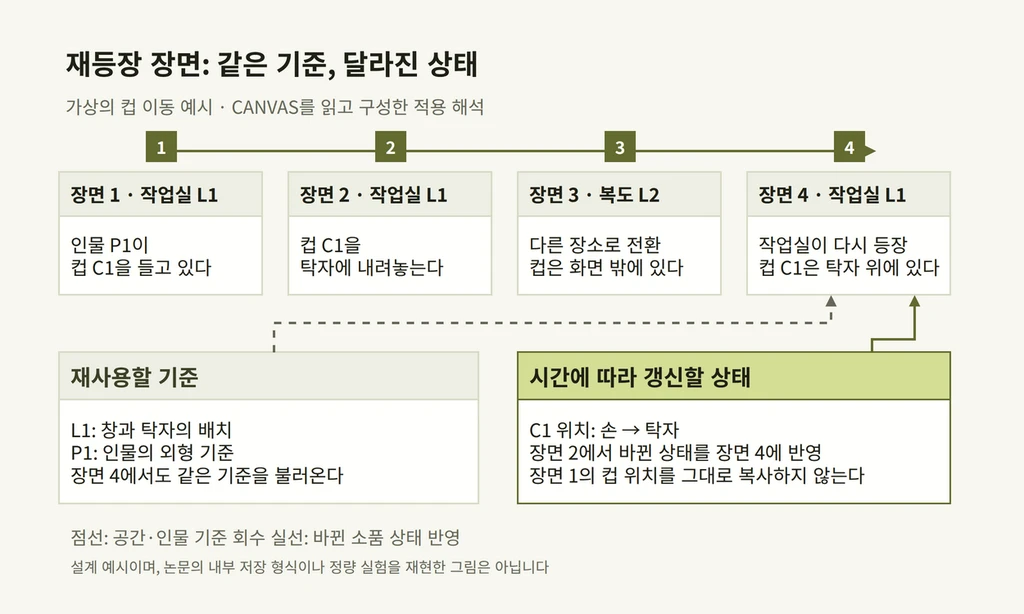
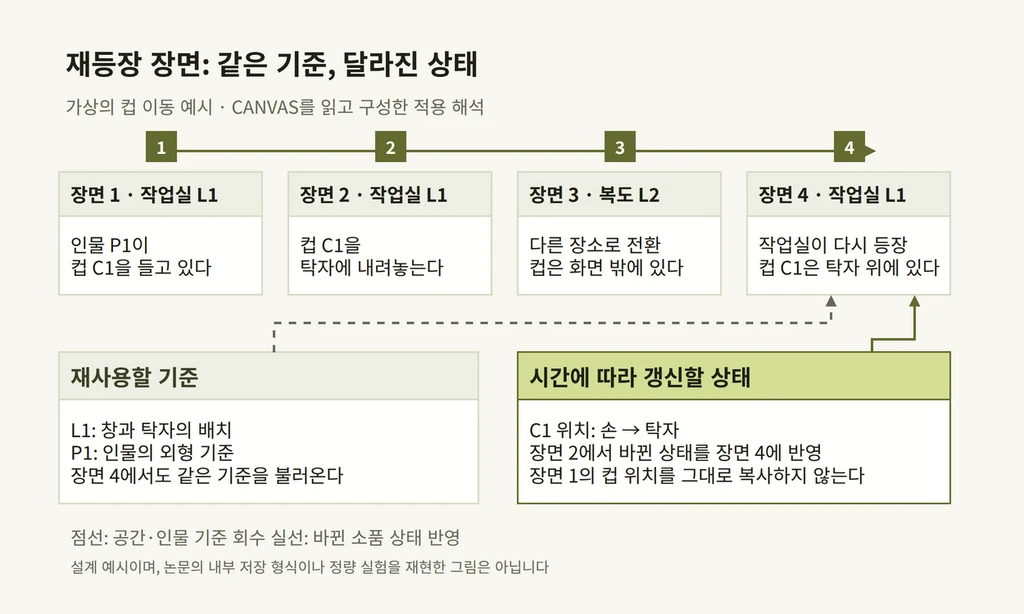
아래 도식은 작업실 배치와 인물 기준은 재사용하되, 컵의 위치는 행동 이후의 상태를 반영하는 원리를 보여준다.
실제 서비스로 구현할 때는 인물·장소·소품에 식별자를 부여하고 기준 이미지와 현재 상태를 구분해 저장할 수 있다. 상태 변경의 근거가 된 대본 구간과 선택 이미지를 함께 기록하면, 다음 장면에서 오류가 났을 때 검색 실패와 갱신 실패를 분리해 파악하기 쉽다.
도식의 네 장면을 가상으로 추적해 보자. 첫 장면의 상태는 “인물 P1, 작업실 L1, 컵 C1은 손에 있음”이다. 두 번째 장면에서 컵을 내려놓으면 위치만 탁자로 바뀐다. 세 번째 장면은 복도 L2다. 네 번째 장면에서 작업실로 돌아올 때 복도 프레임만 쓰면 작업실 배치를 잃고, 첫 작업실 이미지만 그대로 복원하면 컵이 다시 손에 생길 수 있다. 따라서 장소 L1의 배치 기준과 컵 C1의 최신 상태를 함께 조건으로 써야 한다.
후보 그림을 기억에 넣는 시점도 중요하다. 컵이 손에 남아 있는 후보와 탁자에 놓인 후보를 만들었다면 대본의 상태 변화에 맞는 쪽을 선택한 뒤 기억을 갱신해야 한다. 잘못된 후보를 먼저 기준으로 저장하면 다음 장면에서 그 오류를 일관되게 재현할 수 있다. 일관성이 높다는 평가만으로 대본에 맞는 진행까지 보장할 수 없는 이유다. 이 예시는 논문의 생성 결과를 재현한 것이 아니라 계획·검색·선택·갱신 단계의 역할을 설명한다.
4.83점은 무엇을 평가한 결과인가
논문 Table 2 (https://arxiv.org/html/2604.13452v1#S3.T2 (새 창))에서 ViStoryBench-Lite의 비연속 배경 일관성 점수는 Gemini-CT 4.00, CANVAS 4.83이다. 20개 이야기를 대상으로 Gemini-3-pro-image가 만든 스토리보드를 Gemini-2.5-Flash가 ContinuityEval의 1~5점 척도로 평가했다. 이때 Gemini-CT에는 직전 프레임과 인물 기준 이미지가 제공된다.
0.83점이라는 차이는 성공률의 퍼센트포인트 차이나 전체 영상의 품질 향상률이 아니며, 다른 기준선도 동일한 생성 모델로 재구현해 비교했으므로 모든 상용 서비스와의 우열을 뜻하지도 않는다. 논문 초록의 개선율보다 평가 대상과 척도가 분명한 이 점수 쌍으로 확인하는 편이 정확하다.
주요 평가는 스토리보드에 집중돼 있다. 부록의 영상 실험 (https://arxiv.org/html/2604.13452v1#A1.T17 (새 창))은 Veo-3.1-preview에 기준 프레임을 넣어 만든 짧은 클립을 약 1.5분 영상으로 연결한 결과다. CANVAS 자체가 임의 길이의 영상을 직접 생성하거나 복잡한 물리 동작까지 보장한다는 뜻은 아니다.
메모리를 늘리기 전에 재등장 실패부터 측정한다
도입을 판단할 때는 개별 장면의 품질과 이야기 전체의 연속성을 분리해 평가해야 한다. 제작 조건을 먼저 정의하고, 장소가 이어지는 경우와 다른 장소를 거쳐 돌아오는 경우를 나눈다. 옷을 갈아입거나 물건을 옮기는 의도된 변화도 평가에 포함해야, 모든 요소를 단순 고정한 결과가 높은 점수를 받는 왜곡을 막을 수 있다.
비교 실험은 동일한 생성 모델과 대본에서 다음 세 구성을 시험한다.
직전 프레임만 전달하는 구성
직전 프레임에 인물·장소 기준을 추가하는 구성
기준 이미지와 대본에 따른 상태 갱신을 함께 쓰는 구성
각 구성에 동일한 전체 호출 예산을 배정하고 생성 후보 수와 평가 호출 수를 기록한다. 오류는 인물 외형, 장소 배치, 소품의 현재 상태로 나눠 집계한다. 자동 평가 외에 표본 장면의 인적 검증, 완료 시간, 채택 장면당 비용을 함께 비교해야 기억 구조 자체의 효과와 추가 생성 예산의 효과를 구분할 수 있다.
짧고 같은 장소에서 끝나는 작업은 직전 프레임만으로 충분할 수 있다. 반복 등장하는 자산이 많고 재등장 오류가 잦다면 기준 회수와 상태 갱신을 도입할 이유가 있다. 반대로 상태 추출이 자주 틀리거나 추가 호출 비용이 품질 개선 폭보다 크다면 도입을 보류한다.
기억의 품질도 평가 대상이다
논문의 평가 범위는 제한적이다. HardContinuityBench는 합성 이야기 5개 (https://arxiv.org/html/2604.13452v1#A1.T8 (새 창))로 구성됐고, 선호도 평가에는 연구 그룹 내부 평가자 15명이 참여했다. 자동 평가 점수가 높았다는 결과를 모든 제작 환경의 보편적 신뢰성으로 일반화할 수는 없다. 모호한 대본에서의 상태 추출, 세밀한 물리 상호작용과 복잡한 움직임 구현, 대형 생성 모델의 호출 비용도 과제로 남아 있다.
도입 평가는 메모리의 크기보다 재등장 장면에서 잘못된 기준을 가져오는 오류와 이미 바뀐 상태를 되돌리는 오류가 줄어드는지에 초점을 맞춰야 한다. 두 오류가 줄어들고 시간과 비용이 허용 범위에 들어오는지가 채택의 기준이다.