ColGrep-Agent는 토큰을 어디서 줄일까: 검색 위임과 재탐색의 손익
ColGrep-Agent가 반복 탐색 문맥을 줄이는 과정을 계산하고, API 토큰 감소와 로컬 계산·대기 비용을 구분한다. 필요한 코드 위치의 완전성과 실패 후 재탐색의 손익까지 살핀다.
코드 검색을 작은 모델에 맡겨 API 토큰은 줄였는데 답이 늦게 온다면 실패한 최적화일까. 아낀 것은 상위 모델에 보내는 탐색 문맥이고 새로 쓴 것은 로컬 탐색 시간이다. 성격이 다른 두 비용을 하나의 숫자로 합치면 판단이 흐려진다.
이 글에서는 ColGrep-Agent의 위임 경로와 실제 발표 수치를 살펴보고, 재탐색이 발생할 때의 손익을 간단한 계산으로 확인한다. 본문의 가상 문맥·시간 예제는 설명을 돕기 위한 것이며, 직접 도구를 설치하거나 저장소 검색을 실행한 결과는 아니다.
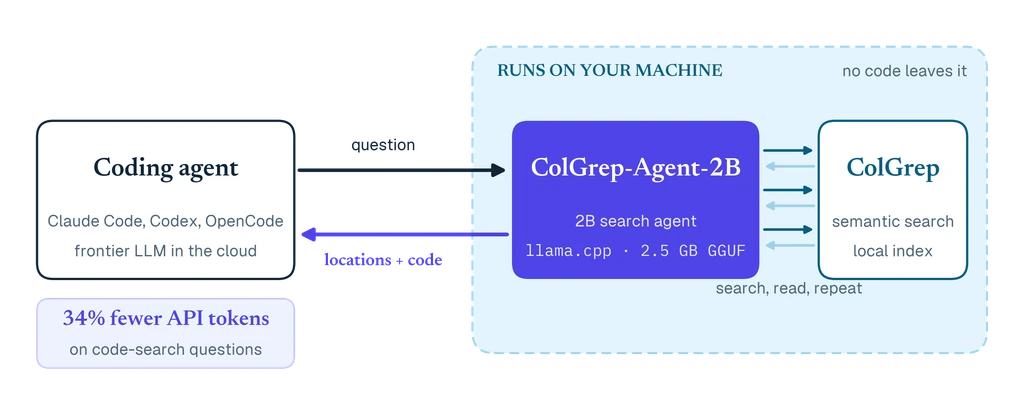
질문을 넘기고 경로·줄 범위·코드를 돌려받는다
LightOn 발표 (새 창)는 로컬 2B 모델이 의미 검색을 수행하고 유망한 파일과 참조를 따라간 뒤, 근거 위치와 코드를 상위 에이전트에 돌려주는 구조를 소개한다. 상위 모델은 탐색의 매 단계를 직접 수행하는 대신, 전달받은 근거로 답을 작성하거나 부족한 위치만 추가로 확인한다.
가상 질문이 “설정이 비었을 때 기본값은 어디서 정해지는가”라면 함수 이름을 바로 알기 어렵다. 후보 파일의 파서만 찾아서는 부족할 수 있다. 빈 값을 처리하는 분기, 기본값 정의, 그 값을 실제로 사용하는 호출부를 서로 연결해야 동작을 설명할 수 있다. 따라서 검색 모델의 반환값은 단순 요약이 아니라 이 연결을 검증할 수 있는 근거여야 한다.
반면 이름을 이미 아는 함수의 정의 위치를 묻는 질문은 문자열 검색 한 번으로 끝날 수도 있다. 이런 질문에까지 로컬 모델의 탐색 루프를 거치면 줄어드는 상위 탐색 단계는 적고 새 단계의 비용만 더해질 수 있다. 위임할 질문의 종류가 성능 조건에 포함되는 이유다.
같은 문맥을 다시 보내는 횟수가 줄어든다
가상으로 상위 모델의 기본 문맥이 20,000토큰이고 검색 결과가 매번 2,000토큰씩 쌓인다고 하자. 세 번의 호출에서 20,000·22,000·24,000토큰을 읽으면 누적 입력은 66,000토큰이다. 반면 위임 요청과 결과 확인으로 두 번만 호출해 20,000·22,000토큰을 읽는다면 42,000토큰으로 약 36.4% 줄어든다.
이 수치는 발표 결과를 재현한 식이 아니다. 출력 토큰과 도구 메시지 형식, 캐시 할인, 실제 문맥 길이를 생략한 설명용 계산이다. 또한 로컬 모델이 탐색하며 생성한 토큰은 상위 API 입력 합계에 포함되지 않았다. API 토큰 감소를 전체 계산량 감소로 해석하면 로컬에서 추가된 작업이 사라진 것처럼 보인다.
캐시가 적용된 입력과 새 입력, 출력의 단가가 다를 수도 있으므로 토큰 절감률이 곧 비용 절감률과 같을 필요도 없다. 처리 시간을 따질 때도 상위 호출을 줄여 아낀 시간에서 로컬 탐색과 결과 확인에 쓴 시간을 빼야 한다.
34.3% 토큰 절감과 8.6초 추가 대기가 함께 나왔다
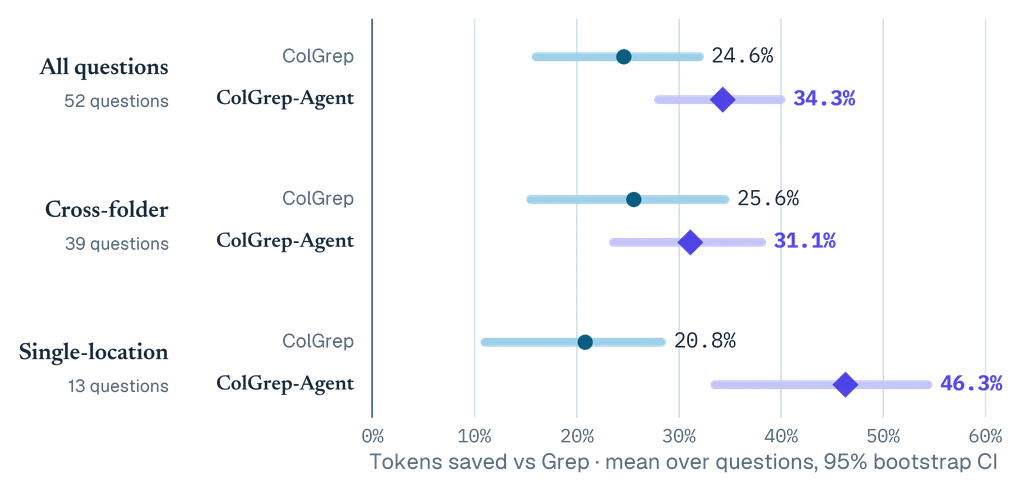
공식 평가는 13개 저장소의 52개 코드 검색 질문을 구성별로 세 번씩 실행했다. Grep 대비 ColGrep-Agent의 API 토큰은 34.3% 줄었지만, 평균 질문 시간은 13.0초에서 21.6초로 늘었다. 차이는 8.6초로, 기준 대비 약 66.2% 더 걸린 셈이다. 이 집계에서는 로컬 모델의 생성 토큰을 제외했으며, 코드 수정과 테스트 완료까지 이어지는 작업은 측정하지 않았다.
아래 Figure 5의 점선은 Grep의 기록인 13.0초다. ColGrep 15.0초, Balanced 17.7초, ColGrep-Agent 21.6초가 모두 그 오른쪽에 자리한다. 이 평가에서는 검색을 위임할수록 평균 대기 시간이 늘었지만, 이 그래프 하나로 모든 장비와 질문에서 같은 순서가 나온다고 보장할 수는 없다.
평균 정답률은 Grep이 83.3%, ColGrep-Agent가 80.8%였다. 발표에서 추정한 차이의 95% 신뢰구간은 −10.9~+5.1%p다. 구간에 0이 포함된다는 사실이 두 방식의 동등성을 입증하지는 않는다. 품질 손실 가능성도 열려 있는 구간이므로 토큰 절감 효과와 함께 실패 사례를 검토해야 한다.
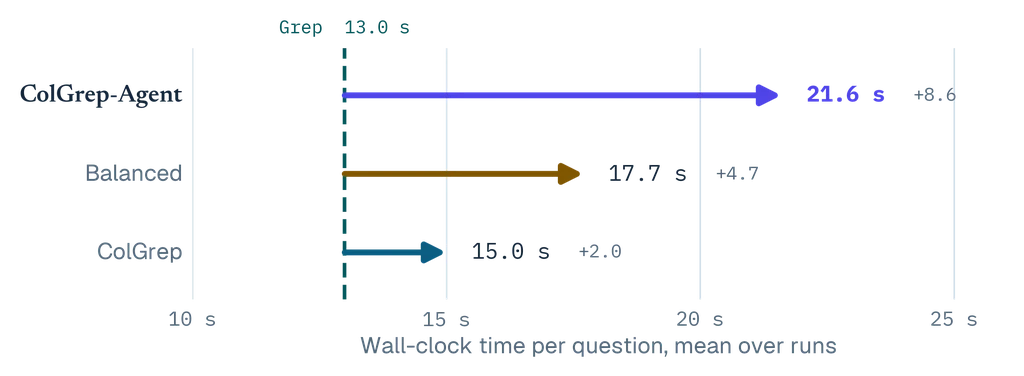
파일 하나를 찾는 것과 필요한 호출 경로를 찾는 것은 다르다
가상 정답이 세 위치이고 반환된 세 위치 중 두 개만 맞았다면 위치 단위 정밀도와 재현율은 모두 2/3다. 그 정도로도 유용한 출발점이 될 수 있지만, 빠진 한 곳이 기본값을 덮어쓰는 호출부라면 최종 동작 설명은 틀릴 수 있다. 위치 점수와 질문을 완결하는 성공 판정을 구분하는 이유다.
공식 평가는 여러 위치를 요구하는 질문에서 필요한 위치를 모두 찾았을 때만 정답으로 본다. 도입 시험에서도 이 기준을 유지하면 단순히 관련 파일을 많이 반환하는 방식이 완전한 답처럼 평가받는 일을 줄일 수 있다. 같은 커밋과 질문에서 반환된 경로·줄 범위가 실제로 존재하고 주장에 필요한 분기를 포함하는지도 함께 확인한다.
검색 위임이 실패하면 상위 에이전트의 재탐색이 뒤따른다. 가상 위임 시간이 8초이고 실패 확률을 p, 실패 후 추가 탐색을 10초라고 두면 평균 소요 시간은 8+10p초다. 직접 검색에 10초가 걸린다면 p가 0.2보다 작아야 이 모형에서 위임이 더 빠르다. 이는 실패를 즉시 발견하고 추가 비용이 일정하다는 가정 아래의 계산이며, 실제 실패율의 추정치는 아니다.
최종 비용에는 색인과 실패 복구도 들어간다
검색 질문을 함수 이름이 명확한 경우와 동작만 설명하는 경우로 나누고, 같은 커밋에서 기존 검색·의미 검색·위임을 비교하면 어떤 질문에서 탐색이 줄었는지 드러난다. 첫 색인 생성과 변경 파일 갱신, 로컬 메모리 사용, 결과 검증과 재탐색 시간을 따로 기록하면 반복 사용에 따르는 비용도 파악할 수 있다.
대화형 작업은 추가 대기 시간에 민감하고, 일괄 작업은 API 사용량에 더 큰 비중을 둘 수 있다. 어느 쪽이든 필요한 근거를 빠뜨린 채 아낀 토큰은 후속 작업에서 다시 지불하게 될 수 있다. 결국 위임의 단위는 모든 검색이 아니라, 필요한 위치를 충분히 돌려주면서 추가 계산 비용을 회수할 수 있는 질문이다.