전문가처럼 답해도 정답은 아닐 수 있다: 페르소나의 정확도와 말투 평가
PRISM의 선택적 페르소나 적용을 살펴보고, 지식 정확도와 답변 선호 점수를 섞을 때 생기는 판단 오류를 분석한다.
6개 모델로 살펴본 페르소나 효과
USC의 Zizhao Hu, Mohammad Rostami, Jesse Thomason 연구진은 논문에서 전문가 페르소나의 효과를 분석하고, 이를 바탕으로 효과적인 설정만 모델에 내재화하는 파이프라인 PRISM(Persona Routing via Intent-based Self-Modeling)을 제안한다.
실험은 명령어 튜닝 모델(Qwen2.5-7B, Llama-3.1-8B, Mistral-7B-v0.3), MoE 모델(Mixtral-8x7B), 추론 증류 모델(R1-Distill-Qwen-7B, R1-Distill-Llama-8B) 등 총 6개 모델을 대상으로 진행했다. 평가는 생성 품질(MT-Bench), 판별 정확도(MMLU), 안전 정렬(HarmBench, JailbreakBench, PKU-SafeRLHF)의 세 축으로 나누어 측정했다. 페르소나는 작업별 전문가 8종과 행동형 4종을 합쳐 총 12개를 구성하고, 각각 세 가지 길이(full ~150토큰, short ~75토큰, min ~5토큰)로 준비했다.
관측된 효과와 해석
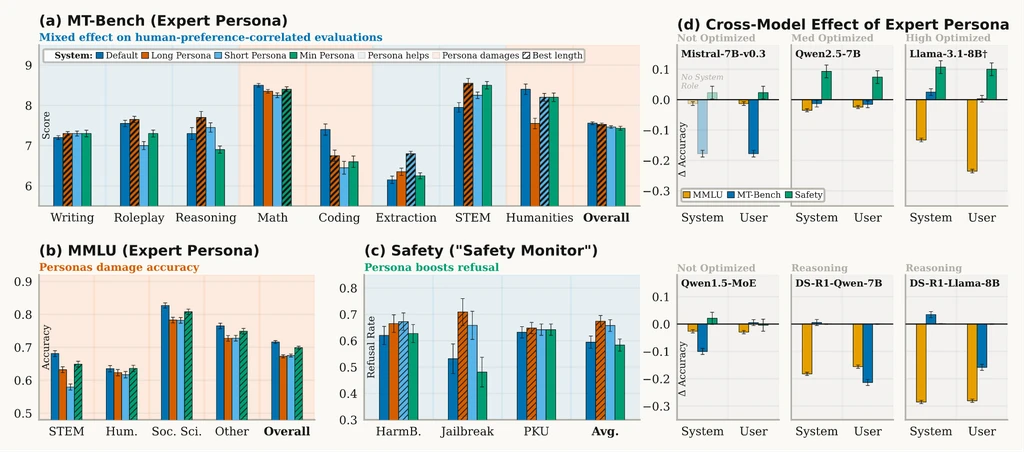
논문은 평가 대상이 사전학습 능력인지 명령어 튜닝 능력인지에 따라 페르소나 효과가 갈린다고 본다. 저자들은 실험 결과를 명령어 튜닝으로 학습된 행동이 증폭되면서 지식 회상을 방해한 것으로 해석한다.
MMLU와 일부 생성 범주의 점수 하락
최소 길이 페르소나를 적용했을 때 MMLU 전체 정확도는 68.0%로 기본 모델(71.6%)보다 낮았다. 저자들은 이를 사실을 떠올리는 과정과 지시를 따르는 과정이 서로 간섭한 결과로 풀이한다.
MT-Bench에서도 사전학습 능력에 의존하는 인문학(−0.20), 수학(−0.10), 코딩(−0.65) 범주에서 점수가 떨어졌다. 예컨대 Mistral은 페르소나가 없을 때 주사위 두 개의 합이 3 이상일 확률을 거의 맞혔으나(9/10), "수학자" 페르소나를 적용하자 점수가 1.5/10로 낮아졌다.
대화 형식과 안전 평가 개선
반대로 명령어 튜닝에 의존하는 작업에서는 페르소나가 도움이 되었다. MT-Bench 8개 범주 중 글쓰기, 역할극, 추론(+0.40), 추출(+0.65), STEM(+0.60) 등 5개 범주에서 점수가 올랐다.
안전 정렬 벤치마크에서는 "Safety Monitor" 페르소나가 공격 거부율을 높였으며, JailbreakBench에서는 거부율이 53.2%에서 70.9%로 +17.7%p 상승했다.
길이에 따른 이득과 손실 변화
지식 작업에서는 짧은 페르소나의 손해가 적었고(MMLU 68.0% vs 긴 페르소나 66.3%), 정렬 작업에서는 긴 페르소나가 더 큰 도움이 되었다(JailbreakBench 긴 안전 페르소나 +17.7%p vs 최소 변형 +8.9%p).
모델 최적화 수준에 따른 차이
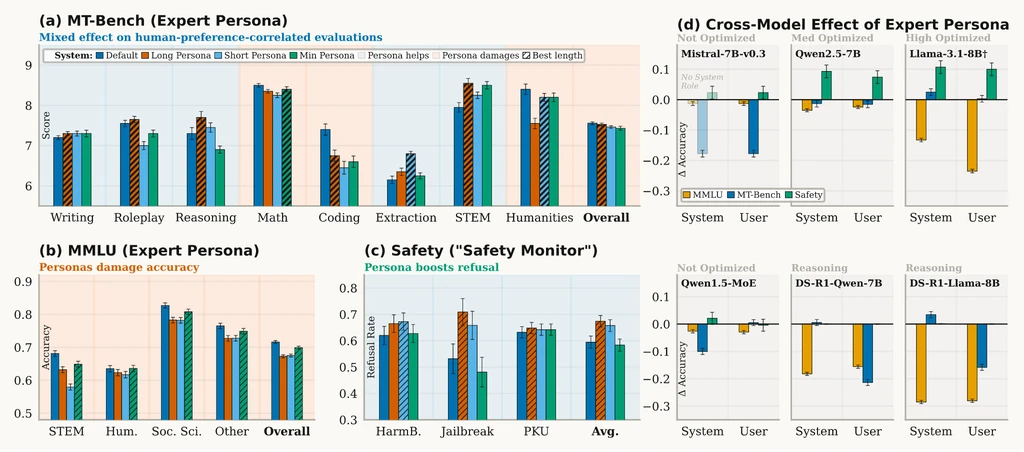
페르소나 민감도는 모델이 시스템 프롬프트에 최적화된 수준에 따라 커진다. Llama처럼 시스템 프롬프트에 잘 최적화된 모델일수록 페르소나로 인한 이득과 손실의 폭이 모두 컸다. 페르소나를 시스템 프롬프트와 사용자 프롬프트 중 어디에 넣는지도 결과에 영향을 미쳤다.
추론 증류 모델(R1 계열)은 페르소나를 적용했을 때 추론, 코딩, STEM 세 범주에서 점수가 올랐다. 저자들은 이를 증류 학습 데이터의 구성과 연결 지으며, 전문가 역할 자체보다는 구조화된 맥락이 영향을 주었을 가능성을 제시한다.
질의별 PRISM 적용
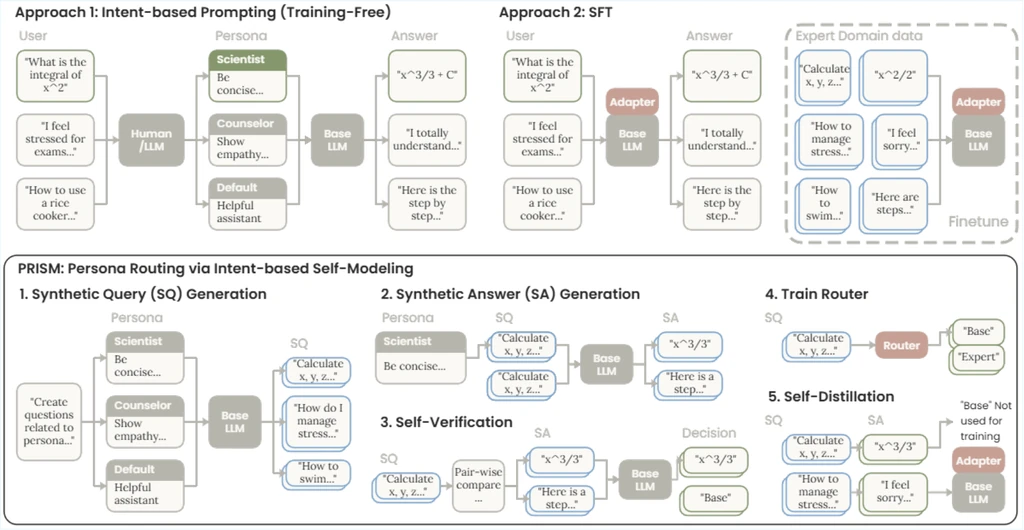
PRISM은 모든 요청에 똑같은 전문가 지시를 붙이는 대신, 질의마다 어댑터를 작동할지 판단한다.
이 파이프라인은 외부 데이터 없이 베이스 모델, 도메인 이름 목록, 페르소나 템플릿만 사용하며 이진 게이트가 달린 LoRA 어댑터를 활용한다. 전체 과정은 ① 페르소나에 맞는 질의 생성, ② 페르소나 적용 및 미적용 답안 생성, ③ 두 답안의 순서를 바꿔 비교하는 자기 검증, ④ 이진 게이트 학습, ⑤ KL 발산으로 LoRA에 증류해 프롬프트 없이도 같은 품질의 답안을 내는 다섯 단계로 이루어진다.
게이트는 첫 번째 트랜스포머 층(layer 0)의 은닉 상태를 입력으로 받고, LoRA는 상위 층에 적용된다.
전체 평균과 개별 지표 분석
표의 Overall은 MT-Bench 8개 범주, MMLU 4개 범주, 안전 평가 3개 거부율 등 15개 지표를 단순 평균한 값이다. 따라서 범용 정확도나 실제 업무 성공률과는 일치하지 않는다.
Qwen2.5-7B에서 PRISM은 MMLU 정확도(71.7%)를 유지하면서 MT-Bench 점수를 7.56에서 7.76으로 끌어올렸다. 전문가 프롬프트를 썼을 때 점수가 떨어졌던 Mistral에서도 PRISM은 기본 모델의 성능을 넘어섰다. 추론 증류 모델에서는 게이트가 대부분의 질의(R1-Llama 97.6%, R1-Qwen 99.4%)를 원본 모델로 라우팅해 점수 하락을 막았다.
게이트는 작업 유형을 따로 학습하지 않았음에도 작업별 페르소나 효과와 높은 상관관계(Pearson r=0.65, Spearman ρ=0.75)를 보였다.
| 모델 | 기본(Overall) | 전문가 프롬프트 | PRISM |
|---|---|---|---|
| Qwen2.5-7B | 71.8 | 72.2 | 73.5 |
| Mistral-7B | 79.9 | 71.4 | 81.5 |
| Llama-3.1-8B | 67.5 | 64.6 | 70.3 |
한계
PRISM 실험은 주로 7~8B급 모델에 한정되어 있어 70B급 모델에서의 검증이 필요하다. 또한 이진 게이트가 LoRA 어댑터와 강하게 결합되어 있어 표준 LoRA 병합 기법과는 호환되지 않는다. MoE 모델은 희소 활성화 특성 때문에 적용하기 어렵고, 이미 특정 도메인에 고도로 특화된 모델은 페르소나 라우팅으로 얻을 수 있는 이득이 적다.
페르소나 없는 조건을 기준선으로 삼기
실제 사용할 모델과 질문으로 페르소나 유무를 비교하고 사실 정확도, 답변 형식, 안전성을 따로 채점하는 편이 안전하다. 전체 평균이 올랐더라도 특정 업무에서 발생한 손해가 가려질 수 있기 때문이다. PRISM을 도입할 때도 소형 모델의 연구 결과를 그대로 믿기보다, 대상 작업에서 선택적 사용이 실제로 이득을 주는지 먼저 검증해야 한다.
이해를 돕기 위해 사실 문제 100개 중 기본 조건이 80개, 전문가 역할 조건이 75개를 맞혔다고 가정해 보자. 별도로 진행한 문체 평가가 5점 만점에 3점에서 4점으로 올랐더라도 정답이 다섯 개 줄었다는 사실은 변하지 않는다. 두 점수를 임의로 평균 내어 “전체 품질 향상”이라고 부르기 전에, 해당 업무에서 허용할 수 있는 정확도 손실의 기준을 먼저 정해야 한다. 이 숫자는 논문의 실험 결과가 아니라 서로 다른 척도의 평가를 합칠 때의 문제를 보여주는 반례다.
페르소나의 효과를 분리해 보려면 역할 이름만 바꾼 조건과, 역할 부여 없이 동일한 출력 형식 및 근거 요구만 명시한 조건을 함께 비교할 수 있다. 이득의 원인이 “전문가”라는 단어에 있는지, 아니면 길어진 지침이나 구조화된 답변 요구에 있는지 구분하기 위해서다. 모델 버전과 질문, 생성 설정을 통일하고 채점자에게 어떤 조건이 적용되었는지 숨기면 문체가 주는 선입견을 줄일 수 있다.
라우터를 추가한 뒤에는 전체 평균만 보지 말고, 페르소나가 도움이 되는 질문을 놓친 경우와 오히려 손해가 나는 질문에 페르소나를 적용한 경우를 나누어 본다. 원본 모델로 보내는 비율이 높다는 이유만으로 게이트가 불필요하다고 단정할 수는 없지만, 그 소수의 적용으로 얻은 이득이 학습과 운영 비용을 감수할 만한 수준인지는 확인해야 한다.
참고 자료
Expert Personas Improve LLM Alignment but Damage Accuracy: Bootstrapping Intent-Based Persona Routing with PRISM (https://arxiv.org/abs/2603.18507 (새 창))