PDF 숫자는 맞는데 답은 왜 틀릴까: Nemotron Parse의 영역·좌표·표 구조
Nemotron Parse의 재읽기 후보와 좌표 변환을 따라가며, 숫자가 맞아도 표의 머리글 관계가 사라지면 검색 답변이 틀리는 이유를 설명한다.
PDF의 숫자를 모두 정확히 읽었더라도 질문에 틀린 답을 낼 수 있다. 표에서 120이라는 값을 추출했어도 이 값이 어느 연도·분기·단위에 해당하는지 연결하지 못하면 검색에 필요한 정보가 완성되지 않는다. 문서 파싱은 글자를 옮기는 일과 정보 간의 관계를 보존하는 일을 함께 다룬다.
Nemotron 3.5 Parse의 단일·이중·삼중 패스를 영역 탐지와 재읽기 관점에서 따라가 보자. 본문의 가상 표와 처리 시간 예제는 구조를 설명하기 위한 것이며, 이 글에서 모델을 직접 실행하거나 한글 PDF 품질을 측정한 결과는 아니다.
처음 놓친 표는 다시 읽을 목록에도 없을 수 있다
모델 카드 (새 창)에 따르면 단일 패스는 전체 페이지를 한 번 파싱한다. 이중 패스는 그 결과에서 표·차트 영역을 골라 잘라낸 이미지를 다시 읽는다. 삼중 패스는 별도의 탐지 요청을 추가해, 파서와 탐지기가 찾은 영역의 합집합을 정밀하게 읽는다. 이때 전체 페이지 파싱과 영역 탐지는 겹쳐서 실행할 수 있다.
가상 페이지에 표 A와 작은 차트 B가 있다고 하자. 첫 파서가 A만 찾았다면 이중 패스의 재읽기 후보는 A뿐이다. 이 단계에서 A의 셀은 더 정확히 읽을 수 있어도, 후보에 없는 B를 직접 복구하지는 못한다. 반면 탐지기가 B를 찾아낸다면 삼중 패스는 A와 B를 모두 후보로 삼을 수 있다.
반대로 탐지기와 파서가 둘 다 B를 놓치면 합집합에도 B는 들어가지 않는다. 탐지기가 표가 아닌 그림 C를 후보로 넣었다면 추가 처리 비용이 생길 수도 있다. 따라서 패스를 늘리는 것과 모든 누락을 없애는 것은 다른 문제다. 발견한 영역을 더 잘 읽는 능력과 읽어야 할 영역을 찾아내는 능력은 나누어 봐야 한다.
잘라낸 그림의 좌표를 원래 페이지로 되돌린다
모델 카드 설명에 따르면 출력에는 내용 기준으로 정규화된 바운딩 박스가 포함되며, x 좌표에는 평가한 이미지의 너비를, y 좌표에는 높이를 곱한다. 텍스트만 남기는 대신 어느 영역에서 추출한 내용인지 추적할 단서가 된다.
가상 이미지가 1,000×2,000픽셀이고 박스가 (0.1, 0.2, 0.4, 0.3)이라면 픽셀 범위는 (100, 400, 400, 600)이다. 너비 300, 높이 200인 영역을 다시 읽는 셈이다. 만약 x 좌표에도 높이를 곱하면 박스 위치가 어긋나므로 좌표계와 이미지 크기가 같은 기준인지 확인해야 한다.
잘라낸 영역을 확대해 읽었다면 결과 좌표는 잘린 그림 기준의 좌표일 수 있다. 예를 들어 원본에서 (100, 400)을 시작점으로 잘라 두 배 확대했다면, 확대된 그림의 (20, 30)은 원본의 (110, 415)에 대응한다. 이는 설명을 위한 좌표 변환 예시이며 해당 모델 내부의 모든 후처리 단계를 재현한 코드는 아니다. 크롭 좌표와 페이지 좌표를 구분하지 않으면 올바른 텍스트에 틀린 근거 위치를 붙일 수 있다.
추가 점수와 줄어든 처리량을 같은 조건에서 읽는다
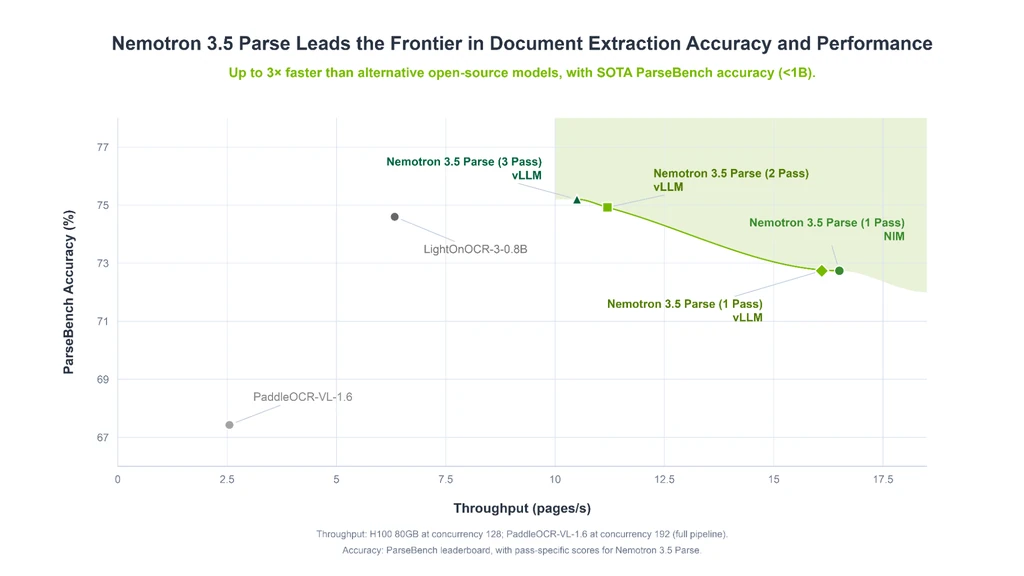
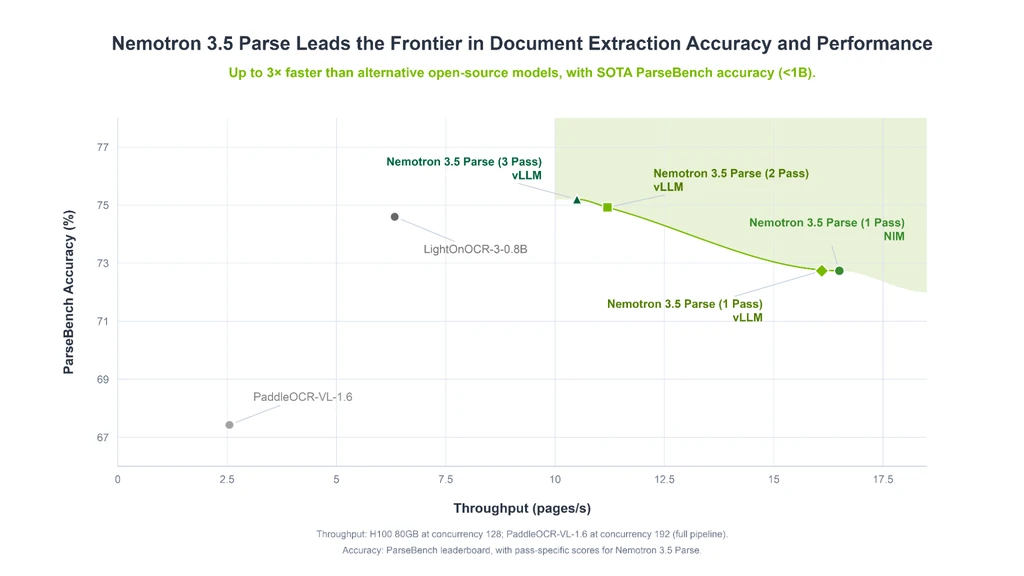
NVIDIA 발표의 표 2 (새 창)는 단일·이중·삼중 패스의 점수를 각각 72.74, 74.92, 75.20으로 제시한다. 같은 표에서 H100 한 장당 처리량은 16.1, 11.2, 10.5 pages/s다. 이중 패스에서 점수는 2.18점 오르고, 삼중 패스에서는 추가로 0.28점 오른다.
가상으로 이 처리량이 1,000페이지 동안 일정하게 유지된다고 보고 나누면 각각 약 62.1초, 89.3초, 95.2초가 걸린다. 이는 단순 처리량 환산일 뿐 실제 PDF 한 건의 응답 시간을 예측한 값은 아니다. 준비 과정·큐 대기·페이지별 난도·동시 실행 조건에 따라 실제 걸리는 시간은 달라진다.
아래 그림에는 vLLM과 NIM 설정이 따로 표시되어 있다. H100 80GB·동시성 128 조건이며, PaddleOCR 비교는 동시성 192 조건이다. 모델 카드의 별도 처리량 표와는 수치가 다르므로 여기서는 발표 자료의 표 2 안에서만 계산했다. 여러 자료에서 가장 높은 점수와 가장 빠른 속도만 골라 하나의 설정인 것처럼 조합해서는 안 된다.
숫자 120보다 중요한 것은 120에 붙은 머리글이다
가상 표의 윗줄에서 “2025년”이 두 열을 묶고, 아랫줄에는 Q1·Q2가 있으며 한 행의 값이 100·120이라고 하자. 검색에 쓰일 관계는 “2025년 Q1=100, 2025년 Q2=120”이다. 만약 “2025년, Q1, Q2, 100, 120”처럼 단어 목록만 남기면 어떤 값이 어느 열에 속하는지 흐려질 수 있다.
후처리 안내 (새 창)에서는 HTML과 계층형 JSON은 병합 셀 구조를 보존하고, 평평한 구조의 Markdown·CSV·레코드 JSON은 병합 범위를 펼쳐서 표현한다고 설명한다. 형식을 바꾸는 것 자체가 잘못은 아니다. 평평한 구조로 만들더라도 각 값에 상위 머리글을 연결해 주면 필요한 관계를 보완할 수 있다. 다만 실제 변환 결과가 그 관계를 제대로 유지했는지는 별도로 확인해야 한다.
앞선 예제에서 두 번째 열에 상위 머리글을 붙이지 못하면 120을 다른 연도의 Q2 값으로 답할 수 있다. 단위가 백만원인데 원으로 잘못 읽는 경우도 텍스트 존재 여부만으로는 잡아내지 못한다. 따라서 숫자 일치, 행·열 연결, 단위, 읽기 순서, 근거 페이지를 나누어 검사한다. 파싱 모델을 바꾸더라도 이후 변환 단계에서 관계를 잃어버리면 최종 답은 여전히 틀릴 수 있다.
문자·관계·검색의 실패를 나눠 고친다
문서 검색의 실패 원인은 세 단계로 나누어 추적해 볼 수 있다. 원본 영역을 놓쳤다면 탐지와 입력 이미지를, 영역은 찾았지만 값을 틀렸다면 재읽기를, 값은 맞는데 다른 열과 연결했다면 구조와 후처리를 확인한다. 검색 단계에서 올바른 표를 찾지 못한 문제는 그다음에 다룰 일이다. 이 모든 문제를 단순히 OCR 오류로 묶어 버리면 정작 필요한 수정 지점이 흐려진다.
가상 도입 시험에서는 일반 본문, 병합 셀 표, 작은 차트, 낮은 품질의 스캔 문서를 구분하고 같은 문서에서 모드별 누락과 관계 오류를 기록한다. 추가 패스가 어느 유형의 실패를 줄였는지 확인한 뒤 해당 유형에 맞춰 적용 범위를 넓힐 수 있다. 평균 점수만으로는 개별 표의 누락이나 한글 스캔 문서의 정확도를 보장하지 않는다.
삼중 패스는 단순히 같은 글을 두 번 더 읽는 스위치가 아니라, 다시 읽을 후보를 어떻게 보완할지에 관한 선택이다. 필요한 표를 찾고, 값을 읽고, 관계를 유지해 검색에 넘기는 경로 중 어디가 끊겼는지 알아야 추가 계산을 투입할 곳도 정할 수 있다.