MEMTO는 이상을 어떻게 점수로 바꾸나: 메모리 거리와 재구성 오차
정상 패턴에서의 거리와 재구성 오차를 곱하면 이상 시점의 순위가 바뀐다. MEMTO의 점수 계산을 따라가며 윈도우 길이·임계값·point adjustment가 경보 해석에 미치는 영향을 살핀다.
MEMTO는 정상 패턴을 저장한 메모리와 용량을 제한한 디코더를 결합해, 이상 입력까지 그대로 복원해 버리는 문제를 줄인다. 다만 논문의 성능 수치는 다섯 데이터셋에 point adjustment를 적용한 결과이므로, 실제 배포 전에는 임계값 설정과 분포 변화를 별도로 검증해야 한다.
산업 음향 이상 탐지와 평가 조건
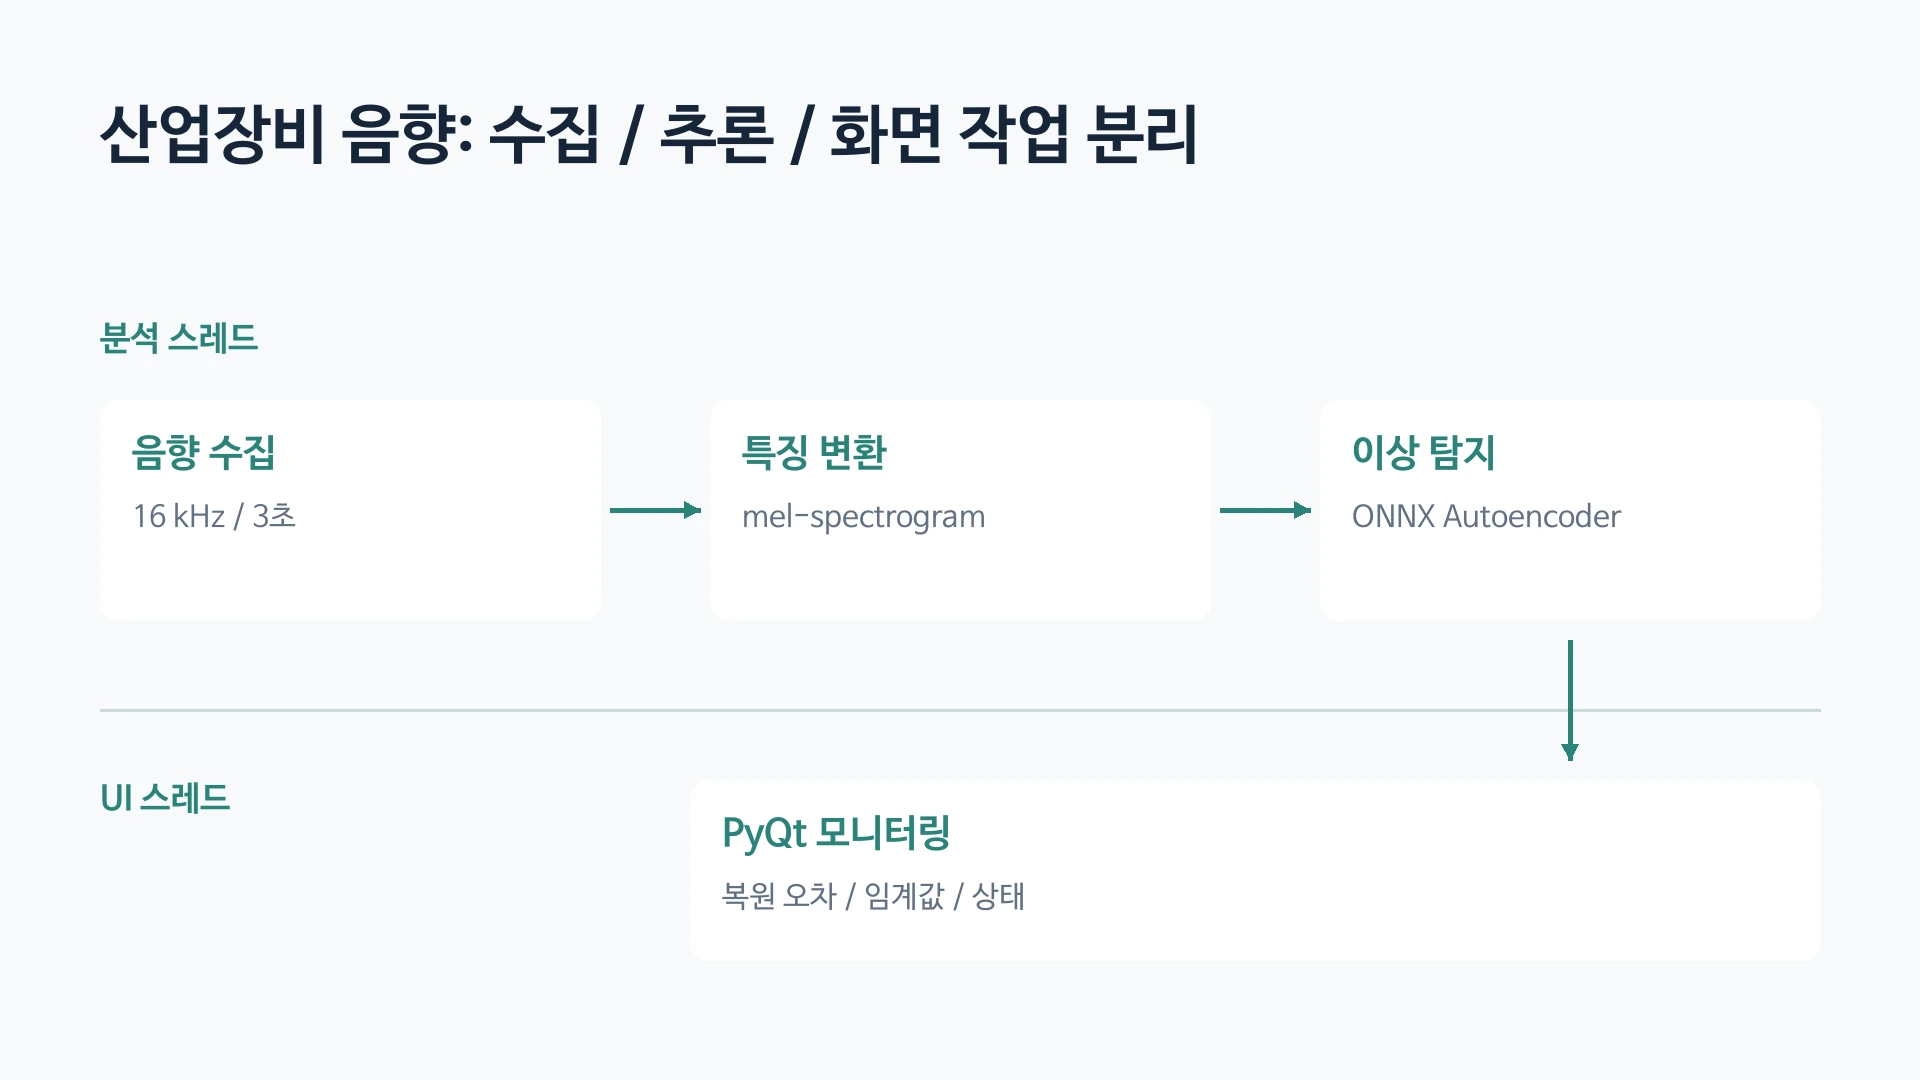
산업장비 음향: 수집에서 이상 탐지·모니터링까지 연구에서는 정상 소리를 학습하는 Autoencoder와 데이터 수집·추론·모니터링 파이프라인을 구현해 검증 AUC 0.9877을 확인했다. 단, 데이터 규모나 설비 분할 기준, 장기 운영 시의 현장 오탐률에 따라 실제 경보 품질은 달라질 수 있다.
MEMTO의 point adjustment 기반 F1과 위 연구의 AUC는 평가 방식과 데이터가 달라 직접 비교할 수 없다. 이상 탐지 모델을 현장에 도입할 때는 탐지 단위와 임계값, 분포 변화 조건을 먼저 맞춰야 한다.
정상 패턴 메모리로 과도한 재구성을 제한하기
Point Adjustment 방법론 의존성
MEMTO 논문의 성능 수치는 모두 point adjustment를 적용한 결과다. 이상 구간에서 한 시점만 탐지해도 구간 전체를 정답으로 처리하므로, 개별 시점의 실제 탐지 품질과는 차이가 있을 수 있다. PA%K나 시간 오차를 허용하는 지표(time-tolerant metrics)와 함께 비교해야 운영에 맞는 탐지 성능을 판단할 수 있다.
이상 입력까지 잘 복원하면 탐지가 어려워진다
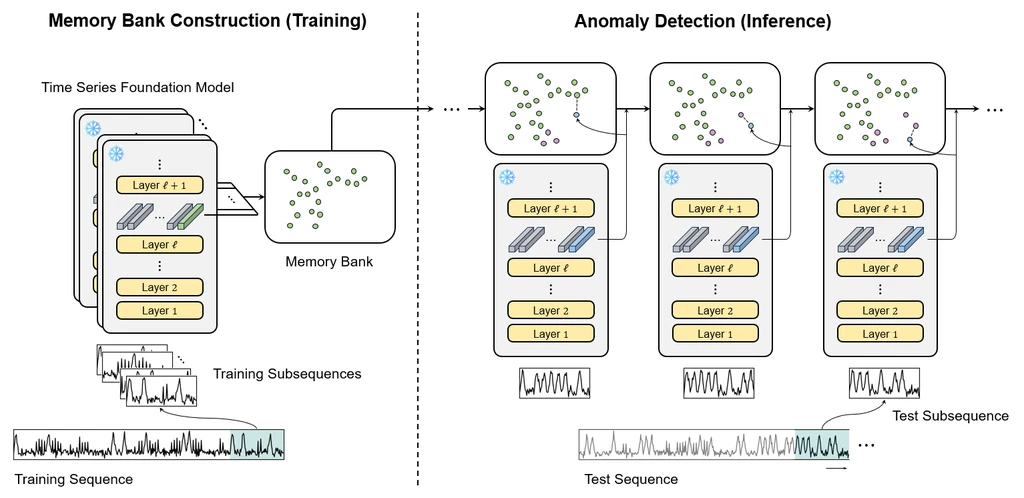
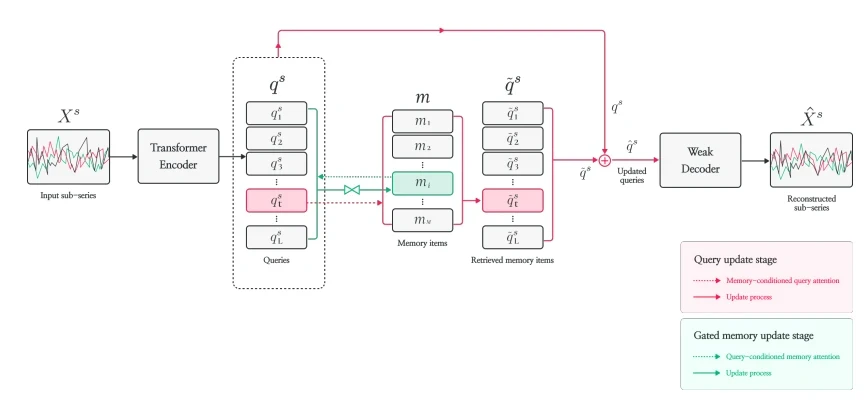
재구성 기반 이상 탐지는 정상 데이터로 학습한 모델이 이상 입력을 잘 복원하지 못할 때 유효하지만, 이상 입력까지 복원하는 over-generalization이 생길 수 있다. MEMTO는 정상 패턴의 대표 벡터를 메모리에 저장하고, 여기서 검색한 패턴으로 쿼리를 갱신해 인코더와 디코더 두 경로에서 생기는 문제를 줄인다.
- 인코더 경로: 인코더가 이상 데이터의 고유 특성(unique feature)을 그대로 추출함 - 디코더 경로: 디코더의 표현력이 과도해 이상 인코딩 벡터에서도 원본을 그대로 복원함
원래 쿼리와 검색한 정상 패턴을 결합한다
디코더 입력으로는 원본 쿼리 qˢ를 지우거나 덮어쓰지 않고, 메모리에서 검색한 정상 패턴 q̃ˢ를 이어 붙인 업데이트 쿼리 qˆˢ를 사용한다.
게이트가 메모리 갱신 비율을 학습한다
새 정보를 별도 제어 없이 단순 누적하는 기존 메모리 모듈(MemAE, MNAD)과 달리, MEMTO는 LSTM의 forget/input gate와 유사한 업데이트 게이트 ψ를 학습한다. ψ가 0에 가까우면 기존 메모리를 유지하고, 1에 가까우면 새 패턴으로 대체한다.
사전학습과 K-means로 메모리 초기화하기
랜덤 초기화로 인해 학습이 불안정해지는 문제를 막기 위해 2단계 학습을 사용한다.
1. 1단계: 메모리 없이 순수 재구성 사전학습으로 의미 있는 latent 공간 형성 2. K-means 삽입: 인코더 출력(쿼리)을 클러스터링해 각 centroid를 메모리 항목의 초기값으로 설정 3. 2단계: 초기화된 메모리 항목으로 본 학습
이 초기화 방식을 MemAE와 MNAD에 적용했을 때 성능이 각각 14.7%p, 15.4%p 향상됐다.
재구성 오차에 메모리 거리를 가중치로 결합하기
이상 점수는 잠재 공간 거리(LSD)를 softmax로 정규화한 뒤, 이를 입력 공간 재구성 오차(ISD)의 가중치로 곱해 계산한다. 메모리에서 멀리 떨어진 시점에 상대적으로 큰 가중치(0~1 사이)를 주되, 원래 ISD 값을 1배보다 크게 증폭하지는 않는다. 비교 실험에서 ISD와 LSD를 단독으로 썼을 때 평균 F1은 각각 69.23%, 60.16%였으나, 두 값을 결합했을 때는 95.73%를 기록했다(point adjustment 적용).
두 시점의 점수 변화를 따라가 보자. 설명을 위한 가상 예시로, 두 시점의 재구성 오차가 각각 4와 4이고 정규화된 메모리 거리 가중치가 각각 0.2와 0.8이라면 결합 점수는 0.8과 3.2가 된다. 재구성 오차만으로는 구분되지 않던 두 시점이 메모리에서 얼마나 벗어났는지에 따라 나뉘는 것이다. 반대로 첫 시점의 재구성 오차가 20이라면 결합 점수는 4가 되어 두 번째 시점보다 커진다. 즉, 메모리 거리가 먼 시점이 무조건 더 이상하다고 판단하는 규칙이 아니라 두 신호의 곱으로 순위를 매기는 구조다.
또한 softmax 가중치는 같은 윈도우 내 다른 시점들의 값에도 영향을 받는다. 두 시점의 입력 점수가 같다면 가중치는 각각 0.5가 되지만, 동일한 점수를 가진 시점 2개가 더 들어오면 가중치는 각각 0.25로 줄어든다. 재구성 오차가 그대로여도 최종 곱셈 점수는 절반이 되는 셈이다. 윈도우 길이를 기본 설정인 100에서 다른 길이로 바꿨을 때 기존 절대 임계값을 그대로 재사용하기 어려운 이유가 여기에 있다. 이는 softmax 정규화 방식을 설명하기 위해 계산한 예시이며, 논문의 성능 실험 결과는 아니다.
메모리 항목 mᵢ ← mᵢ + Σ(가중합된 쿼리)게이트 ψ = sigmoid(mᵢUψ + Σ(vᵢₜ·qˢₜ)Wψ)
mᵢ ← (1-ψ) ◦ mᵢ + ψ ◦ Σ(vᵢₜ·qˢₜ)| 단계 | Attention 방향 | 용도 |
|---|---|---|
| Gated Memory Update | 메모리 → 쿼리 방향 (vˢᵢₜ) | 메모리 항목과 관련된 쿼리 파악 |
| Query Update | 쿼리 → 메모리 방향 (wˢₜᵢ) | 쿼리에 결합할 메모리 검색 |
LSD(t) = ||qˢₜ - m^pos||²   # latent space: 가장 가까운 메모리 항목과의 거리
ISD(t) = ||Xˢₜ - X̂ˢₜ||²    # input space: 재구성 오차

A(Xˢ) = softmax([LSD(t)]) ◦ [ISD(t)]
재현할 때 고정할 설정
데이터 전처리 파이프라인
논문에서는 길이 100의 non-overlapping 슬라이딩 윈도우로 서브시리즈를 생성했다. 실제 구현에서는 학습 데이터 양과 연산 비용 사이의 트레이드오프를 고려해 데이터셋 크기에 따라 overlap 여부를 조정한다.
메모리 모듈 설계 포인트
메모리 항목 수 M은 클러스터 수와 같게 둔다. 논문은 성능과 계산 비용을 고려해 M=10을 기본값으로 선택했으며, Figure 4 기준 20~100 범위에서 성능이 비교적 안정적이다. M이 너무 작으면 다양한 정상 패턴을 충분히 표현하지 못하고, 너무 크면 항목 간 중복이 늘고 연산 비용이 증가한다. 따라서 원논문 4.4절 (새 창)을 참고해 실제 데이터에 맞는 항목 수와 비용을 비교해야 한다.
Weak Decoder의 중요성
디코더의 표현력이 강력할수록 이상 입력까지 잘 복원해 버리므로, 메모리 모듈의 효과를 유지하기 위해 디코더 용량을 FC 2층으로 제한한다.
Entropy Loss 설계 의도
Attention 분포 Wˢ가 dense하면 이상 데이터도 여러 메모리 항목의 조합으로 복원될 수 있다. Entropy loss는 sparse attention을 유도해 각 쿼리가 소수의 메모리 항목에 집중하도록 돕는다(참조 개수를 고정하는 규칙은 아님). 이때 가중치를 λ=0.01로 낮게 설정해 reconstruction loss를 주 목적함수로 유지한다.
Threshold 설정
논문은 학습·검증 데이터의 이상 점수 분포에서 상위 p%를 임계값으로 사용한다(SMD: 0.5%, SWaT: 0.1% 등). 레이블이 없는 실제 배포 환경에서는 도메인 지식을 활용하거나 별도의 threshold calibration 방법을 적용해야 한다.
온도 파라미터 τ
τ=0.1로 설정해 softmax 분포를 날카롭게(sharp) 만들고, entropy loss와 함께 sparse retrieval을 유도한다. τ가 크면 모든 메모리 항목에 균등하게 접근하게 되어 over-generalization 위험이 커진다.
추론 단계의 메모리 처리
학습 시에는 역전파를 통해 Gated Memory Update를 학습하지만, 추론 시에는 메모리 항목을 고정하고 Query Update Stage만 작동시켜 갱신 비용을 줄인다.
배포 검증과 확장 방향
배포 전에는 탐지 지표와 임계값을 먼저 검증하고, 운영 중에 확인된 문제에 맞춰 확장 방안을 검토한다.
동적 임계값 설정
오프라인에서 상위 p%를 수동으로 지정하는 대신, 스트리밍 환경의 점수 분포 변화에 맞춰 이동 평균과 분산으로 임계값을 조정할 수 있다. 단, 자동 조정 과정에서 실제 이상 구간이 정상으로 흡수되지 않는지 확인해야 한다.
메모리 항목의 해석 가능성
각 메모리 항목이 나타내는 정상 패턴을 시각화하거나 항목별 활성화 빈도를 분석하면 도메인 전문가가 결과를 해석하는 데 도움이 된다.
초기화 전략 비교
K-means 외에도 GMM, DBSCAN, 계층적 클러스터링 등으로 정상 패턴을 초기화하는 방법을 동일한 데이터·메모리 수·평가 조건에서 비교해 볼 수 있다.
온라인·연속 학습 지원
제조 환경처럼 정상 패턴이 서서히 변하는(concept drift) 경우에는 신뢰할 만한 정상 샘플로 메모리를 점진적으로 갱신하는 연속 학습을 검토할 수 있다. 이때 이상 샘플이 메모리에 섞여 들어갈 위험을 검증해야 한다.
이상 유형 분류로 확장
단순 이진 탐지를 넘어 메모리 항목과의 거리 패턴이나 활성화된 항목을 분석하면, 이상 유형을 클러스터링하는 원인 진단(root cause analysis)으로 확장할 수 있다. 실제 설비에 적용할 때는 이상 유형 레이블과 진단 정확도를 별도로 검증해야 한다.
멀티스케일 메모리
단일 해상도 메모리 대신 THOC처럼 여러 시간 해상도의 정상 패턴을 학습하는 계층적 메모리를 도입해, 단기 스파이크와 장기 드리프트를 함께 다루는 실험을 고려할 수 있다.
이론적 분석과 연산 비용 한계
논문은 게이트 메커니즘과 bi-dimensional criterion(LSD를 ISD의 가중치로 결합하는 조건)에 대한 이론적 분석을 향후 과제로 남겼다. 또한 Transformer 인코더는 시퀀스 길이에 대해 O(L²) 연산이 필요하므로, 수만 타임포인트 이상의 긴 시계열에서는 Linear Transformer나 State Space Model(Mamba 계열)로 대체하는 방향이 실용적이다.
배포 환경을 검증할 때는 먼저 고정 메모리 기준선을 세워 디코더 용량, 메모리 초기화, attention 분포를 재현한다. 그다음 실제 데이터의 임계값과 분포 변화에 따른 오탐·누락을 확인한 뒤, 동적 임계값이나 온라인 갱신 도입 여부를 결정한다.
탐지 점수와 실제 경보 품질의 차이는 간단한 예시에서도 드러난다. 연속된 이상 시점 100개 중 마지막 1개만 임계값을 넘었다면, 해당 구간에서 실제로 탐지된 시점은 1개뿐이다. 하지만 point adjustment는 한 시점만 탐지해도 구간 전체를 맞힌 것으로 보정하므로 구간 내 재현율이 1%에서 100%로 바뀐다. 그렇다고 해서 첫 경보가 마지막 시점에야 울렸다는 사실이 달라지지는 않는다. 이상 발생 시 장비를 일찍 멈춰야 하는 현장이라면 PA F1뿐만 아니라 첫 탐지 지연 시간도 함께 봐야 한다.
따라서 메모리 갱신 기능부터 추가하기보다는, 점수 계산에 사용한 윈도우 길이와 임계값을 먼저 고정하고 보정 전 시점별 오탐·누락과 사건별 탐지 지연을 비교하는 순서가 맞다. 점수 분포만 이동한 것인지, 정상 패턴 자체가 달라진 것인지를 먼저 구분한 뒤에 임계값 조정과 재학습 중 적절한 대응책을 고를 수 있다.
참고 자료
MEMTO: Memory-guided Transformer for Multivariate Time Series Anomaly Detection (https://arxiv.org/abs/2312.02530 (새 창))