에이전트 연결선을 줄이면 비용도 줄까: Codebook의 구조 선택과 실행 비용
연결선 개수 대신 전달 메시지 길이와 실행 토큰을 센다. 두 후보 구조의 효용·비용 점수를 계산해 고정 구조와 학습 선택기를 비교하는 기준을 설명한다.
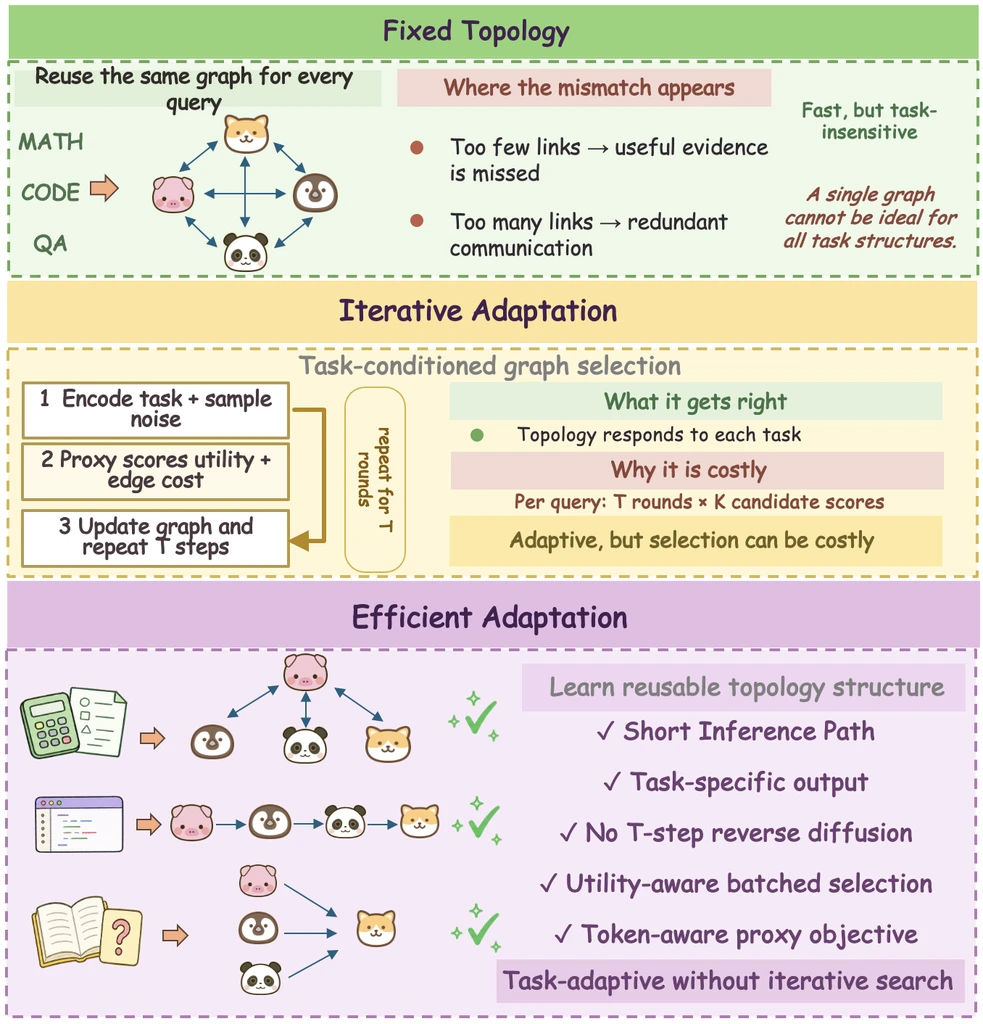
Codebook Agent는 에이전트 연결 구조를 매번 새로 탐색하는 대신, 학습해 둔 후보 중에서 고른다. 다만 이를 도입하기 전에는 고정 구조마다 잘 푸는 질문이 실제로 다른지부터 비교해 볼 필요가 있다.
2026년 9월 2일 공개된 Codebook Agent (https://arxiv.org/abs/2609.02264 (새 창))는 질문이 들어올 때마다 연결 구조를 새로 찾지 않고, 미리 학습한 후보 중에서 선택하는 방식을 제안한다.
후보를 만드는 비용과 실행하는 비용
연결 구조는 각 에이전트가 어떤 중간 답변을 넘겨받을지 정한다. 모든 에이전트를 연결하면 전달되는 정보가 늘어나고, 일렬로 연결하면 앞 단계의 결과에 의존하게 된다. 어느 쪽이 유리한지는 문제와 실행 방식에 따라 달라진다. 연결선 개수만 세어 실제 비용을 판단하기 어려운 이유다.
논문은 성공한 연결 구조를 코드북에 압축해 두고, 질문별 후보에 예상 효용과 토큰 비용으로 순위를 매겨 실행한다. 그림 1은 구조를 선택하는 세 가지 방식의 차이를 보여 준다. 학습과 온라인 선택의 세부 모듈은 원문 그림 2에서 확인할 수 있다.
가상의 검색 R·작성 W·검토 V 세 역할을 생각해 보자. R→W→V 두 연결이 각각 1,000토큰을 전달하면 전달되는 입력은 총 2,000토큰이다. 반면 다른 구성에서 R→W, R→V, W→V 세 연결이 각각 200토큰씩 전달하면 600토큰이다. 연결선은 더 많아도 전달량은 오히려 적다. 이는 출력 토큰·반복 실행·시스템 프롬프트를 뺀 설명용 계산이므로 총요금 비교에는 쓰지 않는다. 연결선 수만으로 비용을 가늠할 수 없다는 반례다.
선택 점수 역시 가정에 따라 바뀐다. 설명을 위해 효용에서 정규화 비용의 λ배를 빼는 점수를 쓰고, 후보 A의 효용·비용이 0.9·0.8, B가 0.8·0.2라고 하자. λ=0.1이면 A는 0.82, B는 0.78이 되어 A를 고른다. 반면 λ=0.3이면 A는 0.66, B는 0.74가 되어 B를 고른다. 이는 논문의 학습 가중치나 실험 결과를 복제한 것이 아니라, 품질과 비용의 맞바꿈을 설명하기 위한 예시다. 실제로 구조를 선택할 때는 예측 점수가 아니라 실행 뒤에 확인한 정답과 토큰을 바탕으로 비교해야 한다.
단일 평가의 평균 차이를 읽는 범위
논문 표 1에서 gpt-4o-mini를 사용한 여섯 벤치마크의 평균 점수는 Codebook Agent가 84.62, 비교 방식인 GTD가 83.02이다. 코드 생성 과제는 Pass@1로 평가했다. 설정별 평가를 한 번씩만 수행했으므로, 이 차이를 반복 실험으로 검증된 안정적인 우위라고 단정하기는 어렵다. 원문의 실험 설정과 결과 (https://arxiv.org/html/2609.02264v1#S5 (새 창))를 함께 살펴봐야 한다.
특히 연결 구조를 생성하는 시간과 전체 응답 시간은 구분해서 봐야 한다. 선택기가 아무리 빨라도 뒤에서 호출하는 LLM과 도구가 느리면 사용자가 체감하는 지연은 크게 줄지 않을 수 있다. 논문 결과를 한국어 업무 데이터나 다른 모델의 성능으로 그대로 옮겨 해석할 근거도 아직 없다.
우리 서비스라면 무엇부터 비교할까
가상의 사내 문서 질의응답 서비스를 가정해 보자. 검색·답변 작성·근거 검토 역할의 연결을 질문마다 바꾸기 전에, 단일 에이전트와 고정된 다중 에이전트 구성을 같은 질문으로 먼저 비교한다.
같은 질문 묶음에 대해 모델 버전, 검색 결과, 도구 권한, 최대 출력 길이를 동일하게 맞춘다. 정답 여부만 보지 않고 근거 문서에 없는 답, 재시도, 입력·출력 토큰, 전체 지연도 함께 기록한다. 내부 문서를 평가에 쓰려면 사용 권한과 외부 전송 가능 범위부터 확인한다.
고정 구조마다 잘 푸는 질문이 실제로 다를 때에야 선택기가 의미를 갖는다. 이때는 학습용 질문과 검증용 질문을 분리하고, 단순한 규칙 기반 선택기도 비교 대상에 넣는다. 학습된 선택기가 더 복잡한 만큼, 그 성능 차이가 늘어나는 운영 부담을 상쇄하는지 확인하는 절차다.
반대로 한 가지 구조가 대부분의 질문에서 충분하거나 요청량이 적다면 고정 구성을 유지할 이유가 크다. 역할과 도구를 자주 바꾸는 서비스라면 후보 구조와 학습 데이터를 계속 관리해야 하는 부담도 생긴다. 새로운 방법이라는 이유만으로 운영 요소를 늘릴 필요는 없다.
연결 최적화가 권한 검토를 대신하지는 않는다
에이전트끼리 주고받는 정보에는 접근 권한 문제도 걸려 있다. 아무리 비용이 적게 드는 연결이라도 특정 역할이 읽어서는 안 되는 문서를 넘긴다면 사용할 수 없다. 허용된 연결 범위를 먼저 정하고, 그 안에서 품질과 비용을 비교한다.
첫 비교에서는 모델과 도구를 고정하고 연결 구조만 바꿔 본다. 고정 구조 간에 질문 유형별 차이가 확인될 때 단순 규칙 선택기와 학습 선택기를 비교하면, 추가 운영 부담을 감수할 만한 이유가 있는지 판단할 수 있다.
참고 자료
Codebook Agent: Amortized Topology Design for LLM Multi-Agent Systems (https://arxiv.org/abs/2609.02264 (새 창)) — Jinxi Yu 외, 2026년 9월 2일. 방법 설명은 4절, 평가 조건과 결과는 5절을 참고했습니다. 2026년 9월 8일 확인했습니다.