4.1배 빠른 모델이 서비스에서는 얼마나 빨라질까: Exact·Fast·Big의 검증
순전파 가속과 전체 처리 시간을 나누어 계산하고 Exact·Fast·Big의 서로 다른 합격 조건을 설명한다. 오차의 평균과 최악 입력, 실행 가능성과 예측 품질을 구분한다.
Anthropic은 2026년 9월 17일 공식 연구 블로그 글과 139쪽 분량의 기술 보고서, 그리고 Apache-2.0 라이선스의 코드 저장소를 함께 공개했다.
세 모드는 서로 다른 것을 보장한다
Exact·Fast·Big은 순차적으로 적용하는 단계가 아니다. 더 큰 입력을 처리할 수 있다고 해서 정확도까지 보장되는 것도 아니다.
표에 있는 세 조건을 모두 '최적화됨'으로 뭉뚱그리면 속도 향상 효과와 회귀 위험을 구분하기 어렵다. 기준 모델보다 빨라졌는지뿐만 아니라, 각 모드가 약속한 결과를 제대로 유지하는지도 함께 확인해야 한다.
| 모드 | 보존·확장 목표 | 확인할 조건 |
|---|---|---|
| Exact | 결과 동일성 | 결정적 조건에서 기준 출력과 비트 단위 비교 |
| Fast | 허용 범위 안의 수치 차이 | 같은 과제의 분야별 지표와 허용 오차 |
| Big | 더 큰 입력의 실행 가능성 | 입력 크기별 실행 가능성과 정확도 |
4.1×는 어느 모델과 실행 구간의 평균인가
Anthropic에 따르면 기술 인력 두 명의 감독 아래 Claude가 4주도 채 안 되는 기간 동안 30개가 넘는 오픈소스 모델의 36개 구현체를 최적화했다. 감독자들은 생체분자 모델링 경험은 있었지만 추론 최적화나 커널 엔지니어링 경험은 없었다. 다만 이 수치는 제공자 측의 보고일 뿐, 독립적으로 재현된 결과는 아니다.
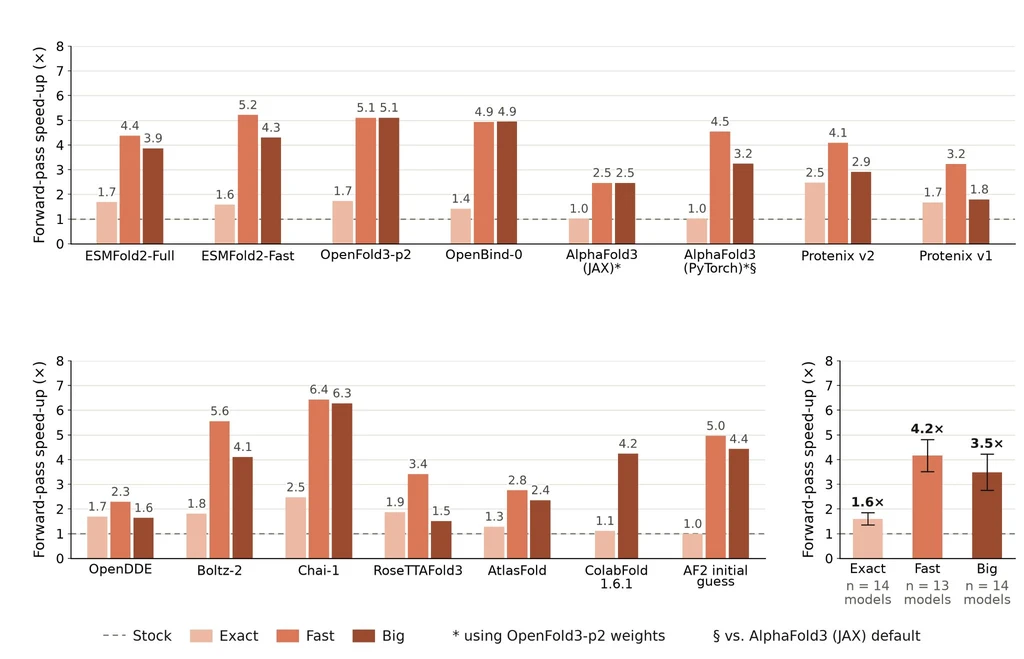
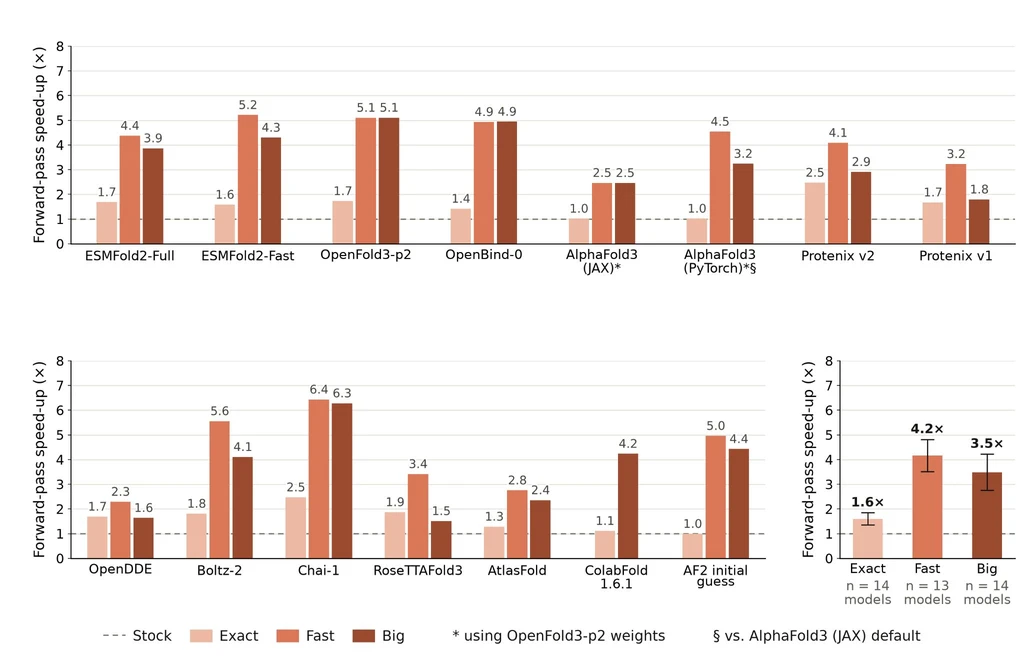
대표 수치인 4.1×는 NVIDIA H100 80 GB 환경에서 구조 예측 모델 13개의 순전파(forward pass) 속도를 비교한 기하평균이다. 비교 기준인 default 역시 단순한 원본 실행이 아니다. 동일한 GPU에서 숙련된 사용자가 선택할 수 있는 가장 빠르고 올바른 설정으로, 원본 구현에 포함된 융합 커널이나 GPU 자원을 충분히 활용하는 배치 설정이 포함될 수 있다. 따라서 이 수치를 전체 처리 지연 시간이나 다른 GPU 환경에서의 예상치로 확대 해석해서는 안 된다.
가령 가상 파이프라인에서 순전파가 41초, 전처리와 결과 저장이 59초 걸려 전체 시간이 100초라고 해보자. 순전파만 4.1배 빨라지면 해당 구간이 10초로 줄어들어 전체 시간은 69초, 즉 약 1.45배 가속된다. 같은 4.1배 가속이라도 순전파가 전체의 90%를 차지하는 다른 작업이라면 90/4.1+10≈31.95초가 되어 약 3.13배 빨라진다. 이는 실제 모델을 측정한 값이 아니라, 어느 구간이 단축되었는지에 따라 전체 체감 효과가 어떻게 달라지는지 보여주는 계산 예시이다.
활성화 실패를 드러내는 실행 방식
공개된 도구는 원본 릴리스와 가중치의 버전·커밋·해시를 고정하고 실행 모드를 명시한다. Exact는 계산 방식은 바꾸되 결정론적(deterministic) 실행 조건에서 default와 비트 단위로 똑같은 출력을 내는 것을 목표로 한다. Fast는 낮은 정밀도 연산이나 융합 커널의 반올림 과정에서 발생하는 미세한 수치 차이를 허용한다. Big은 중간 텐서를 쪼개 처리하거나 단일 호스트 내 여러 GPU에 쌍 표현(pair representation)을 분산해 최대 메모리 사용량을 줄인다.
모드가 정상 적용되면 도구는 ACTIVE mode=…를 출력한다. 만약 해당 장비에서 모드를 적용할 수 없으면 원인과 함께 NOT ACTIVE를 출력하고 종료 코드 3을 반환하며 끝난다. 문제가 생겼을 때 소리 없이 원본 코드로 되돌아가는(fallback) 동작을 막아, 벤치마크에서 켜졌던 최적화가 실제 운영 환경에서도 그대로 적용되는지 확인할 수 있게 했다.
속도 향상과 예측 품질은 별도로 읽어야 한다
Exact는 구조 예측 모델 14개의 순전파에서 평균 1.6×, Fast는 해당 모드를 지원하는 모델 13개에서 평균 4.1× 빨랐다. Exact는 출력 동일성을 최우선으로 삼고, Fast는 모델별 허용 기준 내의 수치 차이를 감수하는 대신 더 큰 가속을 얻는다.
자료 간 표기 차이도 짚고 넘어가야 한다. 이 글에서 인용한 Fast 평균 4.1×와 Big 3.4×는 기술 보고서 본문을 기준으로 삼았다. 반면 위 공식 블로그 그림의 요약 막대그래프에는 각각 4.2×와 3.5×로 표기돼 있다. 본문에서는 두 자료의 숫자를 하나로 섞어 쓰지 않았으며, 공개된 자료만으로는 차이의 원인을 단정할 수 없었다. 기술 보고서의 Figure 3 및 해당 본문 (https://www-cdn.anthropic.com/e96b5807039a88168733d9687afe41dfbbd5de13.pdf (새 창))
후속 과제 검증에서는 FoldBench-Lite의 모델 설정 13개와 모델–대상 쌍 1,925개를 모아 테스트했다. acceptable interface 비율은 default 54.8%, Exact 55.0%, Fast 54.5%, Big 54.2%로 나타났다. 전체 결과를 종합한 변화량의 95% 신뢰구간은 모두 0을 포함했다. 하지만 이것이 모든 모델의 성능이 동등하다는 뜻은 아니다. 일부 모델에서는 감소 추정치가 2.2~3.5%p에 달했고, 신뢰구간에는 더 큰 폭의 손실도 포함됐다. 실제로 RoseTTAFold3 Big의 변화량은 -3.5%p였으며, 95% 신뢰구간은 -7.7~0.0%p였다.
Big 모드의 결과는 실행 가능성과 예측 능력은 별개라는 점을 잘 보여준다. GPU 8개를 장착한 단일 노드에서 10,000 tokens가 넘는 복합체를 정확히 예측한 사례도 있었지만, B300 GPU 8개 환경에서 실행한 31,000~70,320 residues 규모의 예측은 정확하지 않았다. 메모리 부족(OOM) 문제를 해결하더라도 학습 시 다뤘던 범위를 벗어난 입력까지 정확히 예측하리라는 보장은 없다.
출력 보장과 실제 병목에 맞춰 모드 고르기
회귀 검사나 기준 파이프라인처럼 출력 동일성이 중요하고 결정적인 기준 출력을 만들 수 있다면 Exact가 출발점이다. 처리량이 병목이고 도메인별 지표의 허용 오차와 복구 기준을 명확히 정해 두었다면 Fast 도입을 검토할 수 있다. 대상 입력이 GPU 메모리에 다 올라가지 않을 때는 Big을 검토하되, 실제 입력 크기 분포에서 정확도와 지연 시간을 다시 측정해야 한다.
배포 검증은 원본 버전, 가중치 해시, GPU 모델, 배치, 입력 크기를 고정하는 것부터 시작한다. 순전파뿐만 아니라 전처리와 I/O를 포함한 전체 소요 시간을 측정하고, 모드가 제대로 활성화되었는지 로그와 지표로 확인한다. 동일한 작업에서 기준 출력이나 도메인별 허용 지표를 비교하고, 활성화에 실패하거나 허용 기준을 벗어나면 최적화 실행을 중단한 뒤 명시적으로 default 모드로 복구한다.
CPU·I/O가 시간을 지배하거나 허용 기준이 없고 대상 GPU에서 재측정할 수 없거나 기준 릴리스를 관리할 책임자가 없다면 도입을 보류해야 한다. 기존 커널과 배치 설정만으로 목표를 충족한다면 별도 최적화의 빌드 조합과 컴파일 캐시를 관리할 필요도 줄어든다.
검증 결과 역시 모드별로 다르게 해석한다. 예를 들어 가상의 두 출력이 기준 [1.000, 2.000]과 수정 [1.000, 2.001]이라면, 단 하나의 값만 달라도 비트 단위 동일성을 요구하는 Exact에서는 합격 근거가 될 수 없다. 반면 Fast에서는 이 차이가 허용 오차 이내인지, 그리고 후속 과제 결과가 허용 범위 안에 들어오는지를 각각 따져본다. 물론 이 예시의 숫자가 실제 생물학적 허용 오차를 뜻하는 것은 아니다. Big에서는 동일한 입력이 메모리에 정상적으로 적재되는지가 별도의 검사 항목이 되며, 실행에 성공했다고 해서 출력 비교 과정을 생략해서는 안 된다.
평균 오차가 작더라도 특정 크기나 구조를 가진 입력에서 손실이 크게 발생할 수 있다. 따라서 입력 크기별 결과와 함께 가장 크게 어긋난 사례(worst-case)를 기록으로 남겨둔다. 출력 보존, 과제 품질, 메모리 한도라는 세 가지 합격 조건을 명확히 구분해 두면 단순히 속도가 빠르다는 이유로 다른 보장을 암묵적으로 포기하는 일을 줄일 수 있다.
가속해도 남는 메모리와 유지보수 부담
이번에 공개된 속도와 메모리 측정 결과는 H100 환경과 특정 모델 버전에 종속되어 있다. Exact와 Fast가 default보다 메모리를 최대 3.2× 더 많이 사용한 사례도 있었고, 유전체 모델과 단백질 언어 모델은 후속 생물학 과제의 정확도를 측정하는 대신 default 출력과의 비교만 수행했다. 일부 구조 생성 모델은 허용 기준 검사를 끝마치지 못했다. 공개된 코드 저장소 역시 장기적인 유지보수를 보장하지 않는 참조용(reference) 릴리스이다.
두 명의 전문가가 감독하고 Anthropic이 평가한 이 사례만으로 성능 엔지니어의 대체를 주장할 수는 없다. 배포 판단에는 가속률과 함께 모드별 출력 보장, 실제 활성화, 분야별 정확도, 메모리 사용량이 필요하다. 어느 항목을 보존하고 어느 차이를 허용할지 먼저 정해야 빠른 코드를 운영에 쓸 수 있다.
참고 자료
How Claude is uplifting biomolecular modeling (새 창)
· Anthropic, 2026-09-17
Accelerating open-source biomolecular models with Claude (새 창)
· Anthropic, 2026-09-17
Inference optimization kits (새 창)
· Anthropic GitHub, 2026-09-17