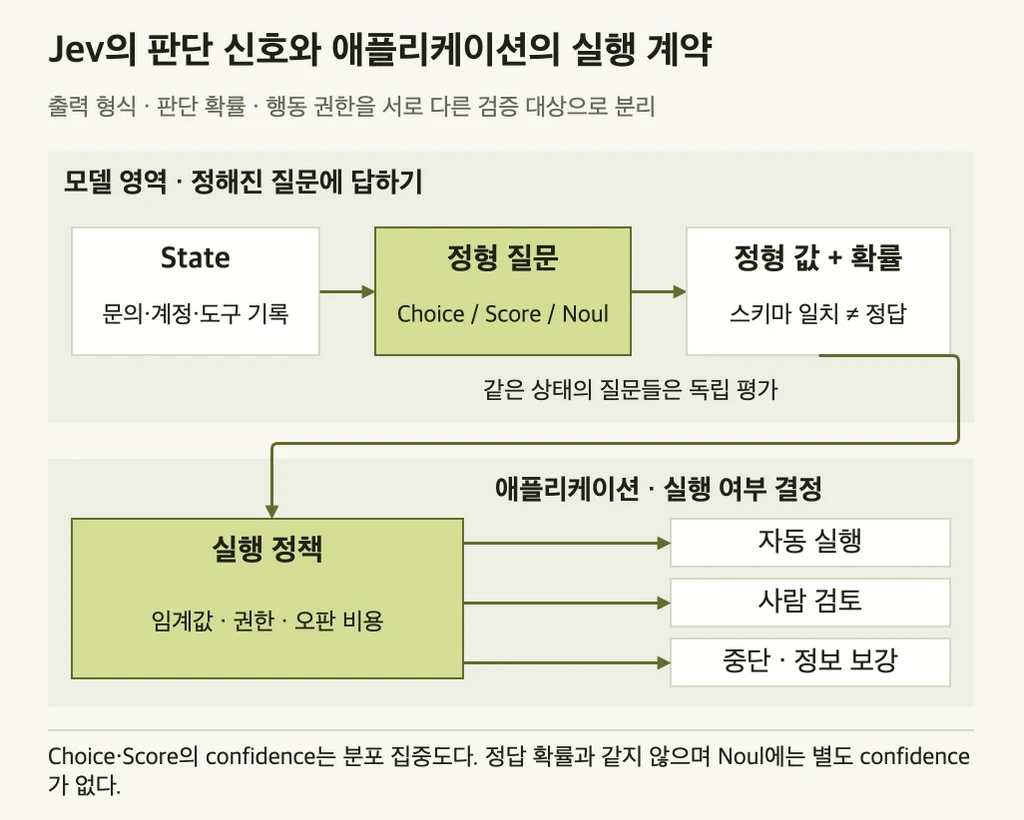
선택 확률 90%는 어디서 나왔을까? 판단 모델의 정규화와 confidence
허용 답의 원래 확률 합이 1%여도 선택 확률은 90%가 될 수 있다. AnyDecisionModel 코드와 가상 계산으로 정규화·confidence·온도 보정의 차이를 설명한다.
선택지 A의 확률이 90%라고 해서 모델이 전체 어휘 중 90%의 확률을 A에 배정했다는 뜻은 아니다. 허용된 답만 남기고 다시 정규화하면, 원래 아주 작았던 확률도 큰 비율처럼 보일 수 있다. AnyDecisionModel의 MLX 다음 토큰 백엔드를 따라가며 선택 확률, 허용 답의 확률 합, confidence가 어떻게 달라지는지 계산해 보자.
답 이름을 A와 B 토큰에 연결한다
“같은 주문이 두 번 결제됐어요”라는 가상의 환불 문의를 결제 부서와 계정 부서 중 어디로 보낼지 고른다고 하자. A는 결제, B는 계정이다. 이는 모델을 실제로 실행한 결과가 아니라 아래 계산에 사용할 입력이다.
패키지 발표 (새 창)는 답변 문자열을 생성해 파싱하는 대신 선택지의 확률을 바로 읽는 Swift API를 소개한다. 여기서는 모든 백엔드를 일반화하지 않고 MLXDecisionModel의 다음 토큰 방식만 살펴본다. 별도의 결정 헤드를 쓰는 모델과도 구분한다.
TokenScoring.tokenMap (새 창)은 답 라벨의 대소문자와 앞 공백 변형 가운데 단일 토큰으로 표현되는 것들을 모은다. 같은 라벨에 속한 토큰의 확률은 모두 더하고, 라벨끼리 같은 토큰을 공유하거나 단일 토큰 표현이 없으면 오류를 낸다. 따라서 다음 예시에서 A의 확률은 특정 토큰 하나가 아니라 A에 연결된 토큰들의 확률 합이다.
MLX 평가 코드 (새 창)는 프롬프트의 마지막 실제 위치에서 전체 어휘의 log-softmax를 구한 뒤, 허용 답에 해당하는 토큰만 가져온다. 입력 처리와 캐시 배치가 남아 있으므로, 이 확률 읽기를 두고 요청 전체가 언제나 모델 호출 한 번으로 끝난다고 해석하지는 않는다.
분모를 1에서 0.01로 바꾸면 90%가 된다
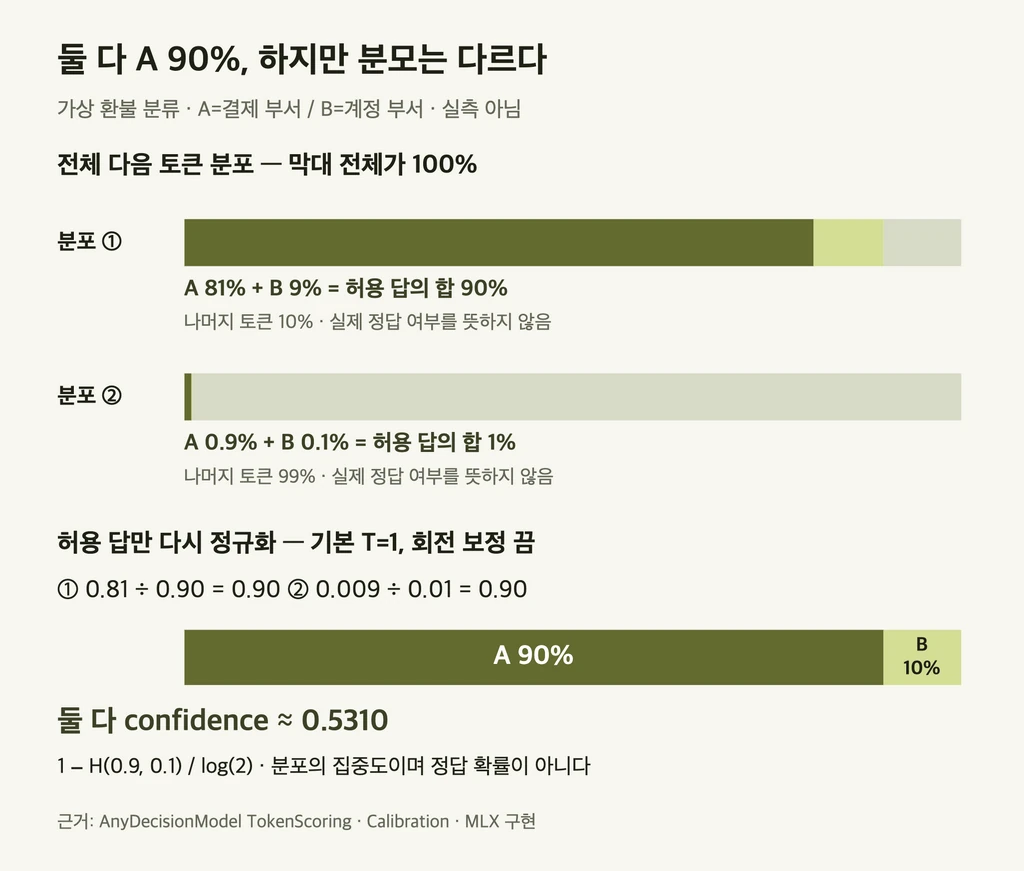
같은 문의에 대한 두 가지 가상 출력 분포를 비교해 보자. 첫 번째 분포는 A에 0.81, B에 0.09, 나머지 토큰에 0.10을 준다. 허용 답인 A와 B의 확률 합은 0.90이다. 두 번째 분포는 A에 0.009, B에 0.001, 나머지에 0.99를 준다. 이때 허용 답의 합은 0.01뿐이다.
보정을 하지 않는 기본 설정에서는 허용 답끼리의 합이 1이 되도록 정규화한다. 첫 번째 분포에서 A는 0.81/0.90=0.90이고, 두 번째 분포에서도 A는 0.009/0.01=0.90이다. 두 결과 모두 A 90%, B 10%를 반환하지만, 모델이 허용 라벨에 배정한 원래 확률은 크게 다르다.
TokenScoring.logMasses는 라벨별 로그 확률을 log-sum-exp로 합산하고, 전체 허용 답의 합을 allowedAnswerMass에 따로 남긴다. MLX 응답은 이 값을 진단 정보에 포함한다. 아래 그림은 같은 높이의 100% 막대에서 이 두 분포를 비교한다. 예시 수치는 실측 성능이나 정확도가 아니다.
나머지 99%가 반드시 올바른 제3의 답을 뜻하지는 않는다. 설명을 시작하는 토큰이나 공백 등 여러 토큰에 확률이 흩어졌을 수 있다. 낮은 allowedAnswerMass는 모델이 기대한 라벨 형식에 확률을 적게 배정했다는 관찰 결과다. 프롬프트나 토큰 매핑, 선택지 구성을 점검할 근거는 되지만 그 자체가 오답 판정은 아니다.
confidence도 정규화된 두 숫자만 본다
concentration 함수 (새 창)는 선택 확률 p에 대해 1−H(p)/log(n)을 계산한다. 여기서 H는 −Σ p·log(p)이고, n은 선택지 수다. 균등 분포면 0이고 한 선택지에 전부 몰리면 1이 된다. 이 값은 정답을 확인한 비율이 아니라 분포가 한쪽으로 몰린 정도를 나타낸다.
A가 0.9, B가 0.1이면 H는 약 0.3251, log(2)는 약 0.6931이므로 confidence는 약 0.5310이다. 앞서 본 두 가상 출력은 정규화 후의 값이 같으므로 confidence도 같다. 원래 나머지 토큰에 10%를 줬는지 99%를 줬는지는 이 계산에 반영되지 않는다. 즉 A의 선택 확률 90%, confidence 약 53.1%, allowedAnswerMass 1%가 동시에 나올 수 있다.
저장소 테스트 (새 창)에도 허용 답의 총확률은 낮은데 confidence는 높은 경우를 확인하는 예제가 있다. 이는 진단 값을 두 종류로 나눈 이유를 잘 보여 준다. 높은 confidence만 기준으로 삼아 자동 분류하면 라벨 밖으로 확률이 새어 나가는 요청을 구분하지 못한다.
온도를 바꿔도 사라진 확률 합은 돌아오지 않는다
Calibration.probabilities (새 창)는 선택 문제에서 라벨별 로그 확률을 온도 T로 나눈 뒤 softmax를 적용한다. 예시에서 T=2를 적용하면 A:B의 비율 9:1이 제곱근 비율인 3:1로 바뀐다. 그 결과 선택 확률은 0.75와 0.25가 되고, confidence는 약 0.1887이 된다. 이 역시 설명을 위한 계산일 뿐 실제 데이터로 온도를 맞춘 결과는 아니다.
원래의 두 분포는 모두 9:1 비율이므로 온도 보정을 거친 뒤에도 같은 결과를 낸다. MLX 코드에서 allowedAnswerMass는 이 보정 단계보다 먼저 계산되므로 여전히 각각 0.90과 0.01로 남는다. 온도는 선택지 간 분포의 날카로움을 조절할 뿐, 라벨 밖의 확률이 왜 높았는지는 해결하지 않는다. 이 글의 예시는 rotationDebiasing을 끈 단일 질문 기준이다.
환불 문의를 자동 분류하는 서비스라면 선택 결과와 함께 이 진단 값을 기록해 둘 수 있다. 라벨 확률 합이 낮은 요청은 입력과 선택지 매핑을 먼저 점검하고, 집중도가 낮은 요청은 두 부서의 영역이 실제로 겹치는지 살펴볼 수 있다. 두 지표 모두 정답을 보장하지는 않으므로, 실제 정답이 있는 별도 자료에서 자동 처리 비율과 오분류를 대조해야 한다. 보정에 쓴 자료와 평가 자료도 분리한다. 이 글은 현재 구현과 가상 확률의 계산 과정을 설명한 것이며, 한국어 분류 성능을 측정한 결과는 아니다.