MoE 전문가를 두 개 지울 때: 개별 중요도만으로는 놓치는 상호작용
HOPE의 전문가 쌍 점수를 가상 계산으로 풀어 개별 순위와 조합 선택의 차이를 설명한다. 행렬 관측·연속 완화의 한계와 메모리 절감 후 서빙 검증을 구분한다.
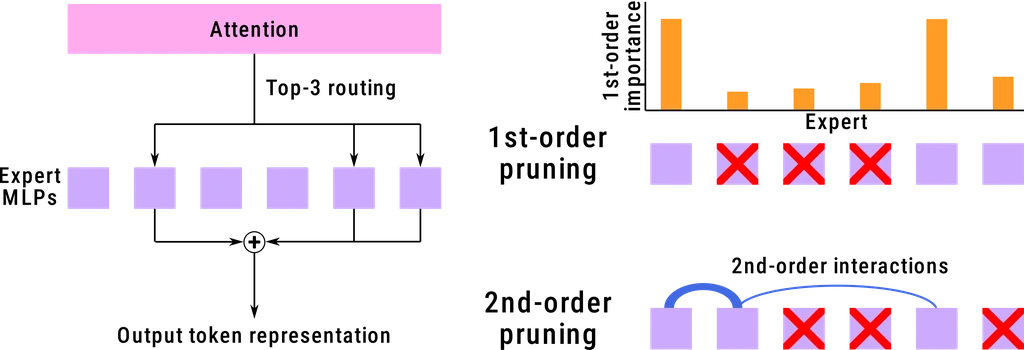
MoE 모델에서 덜 중요한 전문가를 골라 지우면 가중치 메모리를 줄일 수 있다. 하지만 개별 평가 점수가 낮다고 해서 그 전문가들을 함께 지우는 선택까지 좋은 것은 아니다. 삭제할 개수가 같더라도 어떤 조합을 고르느냐에 따라 손실이 달라질 수 있다.
2026년 11월 9일 공개된 HOPE 설명 (새 창)은 삭제를 결정할 때 전문가 쌍의 상호작용을 반영한다. 여기서는 가상의 전문가 세 개 중 두 개를 지우는 계산을 통해 개별 순위와 조합의 차이를 살펴본다. 아래 숫자는 원리를 설명하기 위한 예시이며, 실제 모델을 압축하거나 벤치마크한 결과가 아니다.
토큰을 보낸 횟수와 함께 만든 출력은 다르다
MoE의 라우터는 토큰마다 일부 전문가를 고르고, 선택된 전문가들의 출력을 가중합한다. 전문가를 영구적으로 제거하면 원래 선택됐을 전문가 대신 다른 전문가가 선택될 수 있다. 단순히 사용 횟수가 적은 항목을 지우는 문제와 다른 이유가 여기에 있다.
공식 개념 그림 (새 창)의 왼쪽은 Top-3 라우팅을, 오른쪽 위는 개별 중요도 순위에 따른 삭제를 보여 준다. 오른쪽 아래에서는 파란 연결선을 고려하면서 남기는 전문가가 바뀐다. 이 연결선은 신경망에 새 통신선을 추가했다는 뜻이 아니라 함께 작동하는 관계를 나타낸다.
HOPE 논문 (새 창)은 삭제에 따른 변화 전체를 직접 최적화하는 대신, 계산 가능한 대리 목적함수에 전문가 쌍의 항을 포함한다. 실제 출력 변화에는 대체 전문가와 라우팅 변화도 얽혀 있다. 따라서 아래 계산의 점수를 실제 답변 오류율로 읽어서는 안 된다.
가장 낮은 두 점수를 골랐는데 조합 비용은 더 크다
설명을 위해 전문가 A·B·C의 대각 점수를 각각 1, 1.2, 2라고 놓자. 쌍의 점수는 F_AB=F_BA=0.8이고 나머지 비대각 항은 0이라고 가정한다. 정확히 두 개를 제거하며, p에서 제거할 전문가는 1, 남길 전문가는 0으로 표시한다.
개별 점수만 보면 합이 1+1.2=2.2로 가장 작은 A와 B를 지우게 된다. 그러나 조합 목적함수 pᵀFp에는 A·B가 함께 제거될 때의 두 항도 들어간다. 이때 A·B의 값은 1+1.2+0.8+0.8=3.8이다. 반면 A·C는 1+2=3이고 B·C는 1.2+2=3.2다. 세 조합을 모두 비교하면 이 예시에서는 A·C를 제거할 때의 대리 비용이 가장 작다.
C는 B보다 개별 점수가 높지만, B를 남기면 A·B를 동시에 지울 때 발생하는 비용을 피할 수 있다. 핵심은 “점수가 낮은 전문가를 무조건 보존한다”가 아니라, 고정된 삭제 개수 안에서 조합을 비교한다는 점이다. 반대로 F_AB가 0.1이면 A·B의 값은 2.4가 되어 다시 가장 작아진다. 상호작용의 크기가 충분히 작으면 개별 순위와 같은 결론이 나올 수 있다.
행렬을 만드는 단계와 삭제 집합을 고르는 단계를 나눈다
고정 버전의 solve.py (새 창)는 관측된 norm_prod_sums를 coselect_counts로 나누어 행렬을 만든다. 함께 선택된 횟수가 0인 칸은 0으로 처리한다. 이 구현에서 0은 관측된 공선택이 없었다는 결과일 수 있으므로, 모든 입력에서 관계가 없다는 뜻으로 확대 해석하면 안 된다.
같은 코드의 목적함수는 b @ matrix @ b이며, 선택 개수의 합을 고정한다. 먼저 각 값을 0과 1 사이에 두는 연속 완화를 SLSQP로 풀고, 그 결과에서 큰 값부터 정해진 개수만큼 1로 바꾼다. 앞선 세 전문가 예시에서는 모든 조합을 직접 비교했지만, 이 구현이 큰 모델의 모든 이진 조합을 열거하는 것은 아니다. 반올림한 해를 전역 최적해라고 보장해서도 안 된다.
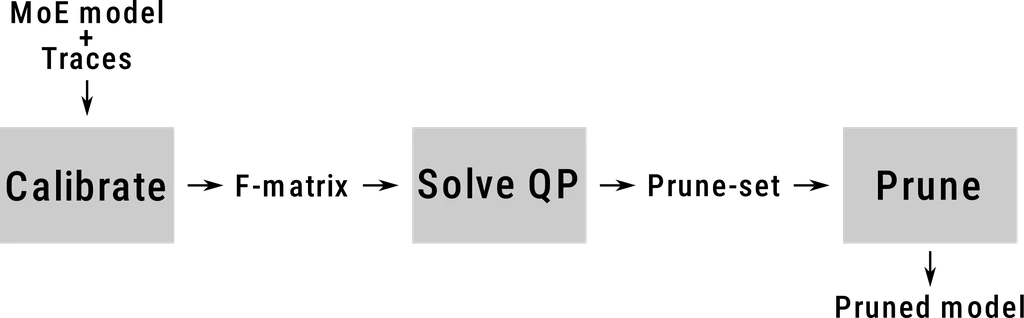
공식 파이프라인 그림 (새 창)은 Calibrate에서 F-matrix를 만들고, Solve QP에서 삭제 집합을 정한 뒤, Prune에서 작은 모델을 만드는 순서로 진행된다. 가운데 단계가 끝나더라도 실제 체크포인트는 아직 바뀌지 않는다. 같은 관측 자료로 삭제 비율을 비교하는 작업과 실제 모델 파일을 만드는 작업을 분리할 수 있는 구조다.
작아진 체크포인트와 빨라진 서빙은 따로 확인한다
관측 입력이 바뀌면 함께 선택되는 전문가와 점수도 달라질 수 있다. 코드 질문으로 만든 행렬이 우리 서비스의 긴 문서 질문에도 적합한지는 별도로 평가해야 한다. 또한 논문의 층별 접근 (새 창)을 전체 모델의 모든 층 간 상호작용까지 해결한 것으로 읽을 수는 없다.
가상 서비스에서 전문가 가중치가 80GB, 나머지 가중치가 20GB라고 하자. 전문가 가중치의 절반을 없애면 가중치 합은 40+20=60GB가 된다. 전체가 50GB로 줄어드는 것은 아니다. 여기에 KV 캐시와 실행 버퍼는 별도로 더해진다. 이 숫자는 메모리 항목을 구분해 보기 위한 가정이다.
전문가를 삭제한 뒤에도 토큰당 선택하는 전문가 수가 같다면, 연산량이 저장량과 같은 비율로 줄어든다고 단정할 수 없다. 남은 전문가로의 토큰 쏠림과 커널 형상, 장치 간 통신이 지연을 바꿀 수 있기 때문이다. 관련 기록의 MoE 실행 글은 바로 이 다음 질문, 즉 가중치 분할과 실제 부하가 왜 다른지를 다룬다.
작은 삭제 비율에서는 개별 순위만으로 충분한지, 큰 삭제 비율에서는 쌍의 항을 포함할 가치가 있는지를 동일한 입력·평가 조건에서 비교할 수 있다. HOPE의 조합 점수는 삭제 후보를 고르는 근거이며, 최종 채택은 답변 품질·메모리·지연을 별도로 검증해 결정해야 한다.