통과율이 올라도 보안이 깨지는 이유: IaC 수정 전후의 검사 집합
최고점과 현재 상태의 차이를 검사 집합 예제로 추적한다. 리소스별 판정이 섞일 때 strict 집계가 놓치는 부분 회귀까지 구분한다.
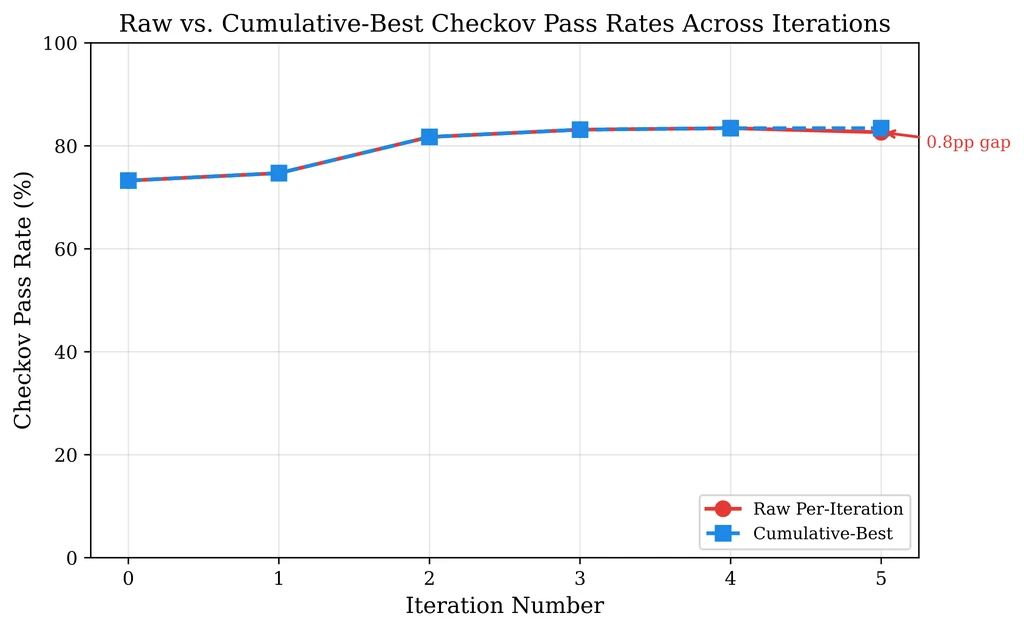
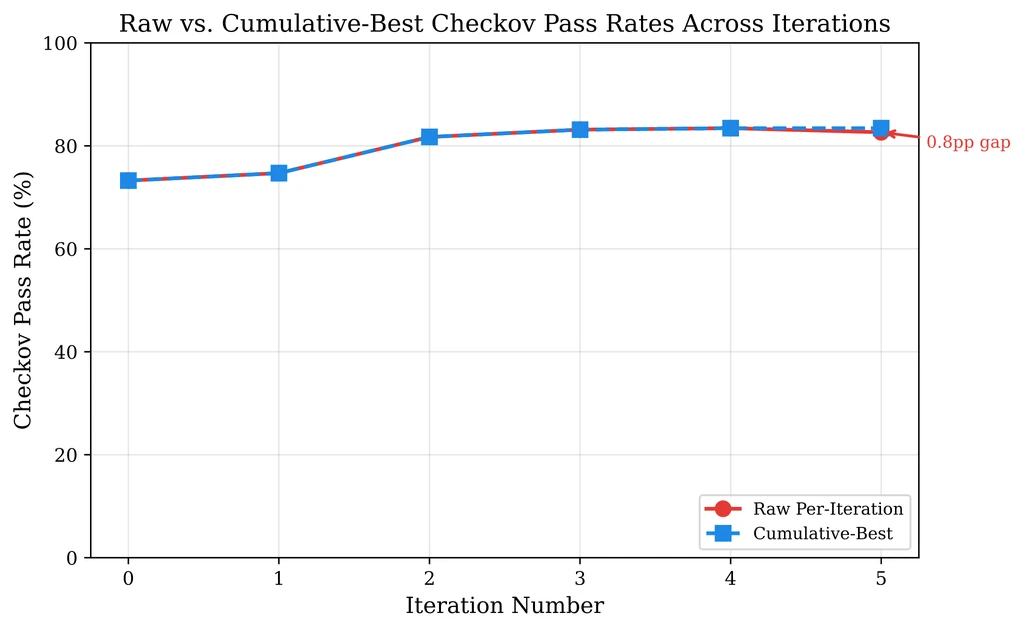
2026.08.13 공개된 연구에 따르면, 엄격한 기준을 적용했을 때 5,968개 시나리오 타임라인 중 194개(3.3%)에서 보안 회귀가 발생했다. 넓은 기준을 적용한 수치인 13.8%에는 여러 리소스에 같은 Checkov 검사를 적용하면서 생긴 집계 모호성이 섞여 있어, 이를 실제 취약점 비율로 볼 수는 없다.
이미 통과한 조건도 다음 수정의 기준이다
직전 반복에서 통과한 검사 집합을 저장해 두고 다음 결과와 비교해야 한다. 전체 점수가 올라도 이전에 통과했던 집합에서 새로운 실패가 생길 수 있으므로, 반복 간 변화를 별도로 검사한다.
운영 지표 역시 누적 최고점 하나만으로는 부족하다. 특정 시점에 한 번 통과했다는 기록만 남기면, 이후 수정 과정에서 다시 깨진 검사를 가리게 된다. 현재 상태의 통과율, 새로 실패한 검사, 복구된 검사와 코드 변경량을 함께 기록해야 수정 경로를 제대로 판단할 수 있다.
Terraform·AWS·Checkov로 제한된 분석
Benjamin Agyekum과 Fabio Santos는 IaC-Eval v1.0의 AWS Terraform 과제 458개를 분석했다(ESEM 2026 채택). 15개 구성에서 최대 5회까지 반복 수정한 5,968개 타임라인과, 전후 반복 모두 Checkov 결과가 존재하는 4,440개 전이를 대상으로 CIS Benchmark 검사 ID 30개를 추적했다.
분석 범위는 Terraform·AWS·Checkov로 한정된다. Ansible이나 CloudFormation, tfsec·Terrascan, 그리고 실제 배포 이후의 동적 보안 평가는 다루지 않았다. 비RAG 실행에는 생성 모델 식별 정보가 없어 RAG 효과와 모델 효과를 분리하지 못했다.
수정 루프에서 보안 회귀가 생기는 지점
일부 항목의 수정 성공이나 누적 최고점만으로 현재 코드의 보안 상태를 판단해서는 안 된다.
일반적인 수정 루프는 코드의 구문·기능 검사 오류를 다시 prompt에 넣는다. 이때 이미 통과한 보안 조건이 피드백에서 빠지면, 모델이 당장의 오류를 없애려고 리소스를 통째로 고치는 과정에서 기존에 안전했던 속성까지 지워버릴 수 있다.
연구진은 연속된 두 반복을 비교해, 앞선 반복에서 통과한 검사 ID가 다음 반복에서 실패하면 회귀로 집계했다. standard 모드는 리소스가 여러 개인 검사도 포함하는 반면, strict 모드는 앞선 반복에서 해당 검사 ID가 모두 통과하고 다음 반복에서 모두 실패한 경우만 남긴다. 따라서 strict 모드는 일부 리소스만 나빠지고 다른 리소스는 계속 통과하는 회귀를 놓칠 수 있다. 두 모드의 결과 차이가 크므로 집계 점수만으로 보안 변화를 재단하기 어렵다.
| 이전 검사 | 현재 검사 | 확인할 변화 |
|---|---|---|
| 통과 | 실패 | 수정으로 새 보안 회귀가 생겼는지 확인 |
| 실패 | 통과 | 문제가 해결됐는지 기능·변경량과 함께 검토 |
3.3%와 13.8%는 집계 기준이 다르다
standard 기준에서는 시나리오의 13.8%, 전이의 24.8%에서 한 번 이상 회귀가 발생했고, strict 기준에서는 각각 3.3%와 5.2%였다. 연구진은 약 3.3%를 보수적인 핵심 수치로 제시한다.
자동 diff 규칙으로 분류한 결과, standard 모드 회귀 전이의 79.0%는 리소스 구조 변경(resource restructuring)이었다. 회귀가 발생한 전이는 그렇지 않은 전이보다 코드 변경량이 2.6배 많았고, strict 검사 변동성은 4.9배 높았다. 모델이나 temperature보다 재작성 규모가 더 직접적인 위험 신호다.
standard 회귀의 36.6%는 평균 1.2회 뒤에 자체 복구됐지만, 추가 반복이 안전을 보장하지는 않는다. 시나리오의 28.5%는 통과와 실패를 오갔으며, 반복 3회를 권한 결론 역시 최대 통과율과의 차이를 0.5%p 미만으로 두는 연구진의 기준에 의존한다.
실제 파이프라인에 적용할 기준
검사 피드백에는 실패 목록뿐만 아니라 이전에 통과한 검사 ID, 그리고 최소 권한·암호화·네트워크 제한처럼 보존해야 할 속성을 함께 넣는다. 전체 재작성보다는 최소 diff를 우선하고, 변경량이 커지면 별도 검토로 넘긴다.
중단 조건은 기능 통과 하나로만 두지 않는다. 구문 검사, 현재 보안 통과율, 새 회귀 0건, 변경량 예산을 모두 만족할 때 종료하도록 설계한다. 연구에서 제시한 3회 반복은 해당 데이터셋의 기준일 뿐이므로, 실제 환경의 validator와 모델로 pass rate·회귀 누적·추가 호출 비용을 다시 측정해야 한다.
가상의 검사 네 개 A·B·C·D가 있을 때 이전 통과 집합이 {A, B}이고 현재 통과 집합이 {B, C, D}라면, 통과율은 50%에서 75%로 오른다. 하지만 이전 집합에서 현재 집합을 뺀 {A}는 새로 발생한 회귀고, 현재 집합에서 이전 집합을 뺀 {C, D}는 새로 해결된 항목이다. 총점 하나만 저장하면 두 개를 고치면서 하나를 깨뜨린 경로가 보이지 않는다. 이는 논문 결과가 아니라 집합 비교를 돕기 위한 설명이다.
동일한 검사 ID가 여러 리소스에 적용된다면 키를 더 세밀하게 잡아야 한다. 암호화 검사 E가 버킷 X와 Y에서 모두 통과했다가 X에서만 실패하면, E의 일부 인스턴스가 회귀한 것이다. 하지만 E가 Y에서는 여전히 통과하므로 ‘다음 반복에서 모두 실패’라는 strict 조건에는 잡히지 않는다. 따라서 운영 기록에는 검사 ID와 안정적인 리소스 식별자를 함께 넣고, 이름 변경·삭제·새 리소스 추가를 단순한 통과·실패 전환과 구분한다.
다음 수정 단계에는 실패한 A만 전달하지 않고 유지해야 할 B·C·D도 함께 알려준다. 그 뒤 전체 검사를 다시 실행해 A를 복구하는 동안 다른 조건이 깨지지 않았는지 확인한다. 최종 배포 판단은 과거에 가장 높았던 점수가 아니라, 실제 배포할 코드의 검사 결과와 남은 위험을 기준으로 내려야 한다.
정적 회귀 검사와 실제 배포 보안의 차이
root-cause 분류는 자동 diff 규칙으로만 수행했으며 사람이 라벨링해 검증하지는 않았다. 일부 타임라인에는 서로 다른 실행의 반복이 섞였을 가능성이 있고, 902개 시나리오-구성 쌍은 API 오류·timeout·파싱 실패로 제외됐다. Checkov 정적 검사 역시 실제 cloud 배포 환경의 보안을 완전히 대변하지 못한다.
수정 루프에는 직전 통과 목록을 다음 반복 결과와 대조하는 단계가 필요하다. 기능 통과 여부와 새로운 보안 회귀 발생 여부를 함께 종료 조건에 넣고, 통과와 실패를 오가는 항목을 기록해야 일시적인 최고점이 현재의 결함을 가리지 않는다.