EmbeddingGemma 2의 벡터를 줄이면 무엇을 잃을까: 정규화와 저장량 계산
768차원을 128차원으로 줄이면 벡터는 6분의 1이 되지만 전체 저장소는 다르다. 잘라 낸 벡터의 재정규화와 실제 저장량을 계산하고 미디어 검색 손실을 구분한다.
Google DeepMind의 Sahil Dua와 Henrique Schechter Vera는 2026년 10월 6일 EmbeddingGemma 2 (https://blog.google/innovation-and-ai/technology/developers-tools/embeddinggemma-2/ (새 창))를 발표했다. 텍스트 중심이었던 1세대에서 미디어까지 검색 대상을 넓힌 Gemma 4 기반 모델이다.
개발팀이 먼저 던질 질문은 ‘여러 자료를 같은 검색창에서 찾으려면 모두 텍스트로 바꿔야 하는가’다. EmbeddingGemma 2는 원본 미디어를 검색 표현으로 직접 바꾸는 선택지를 제공한다. 다만 공통 벡터 공간만으로 자료의 분할, 권한, 최신성까지 해결되지는 않는다.
필요한 인코더만 올려도 검색 공간은 공유한다
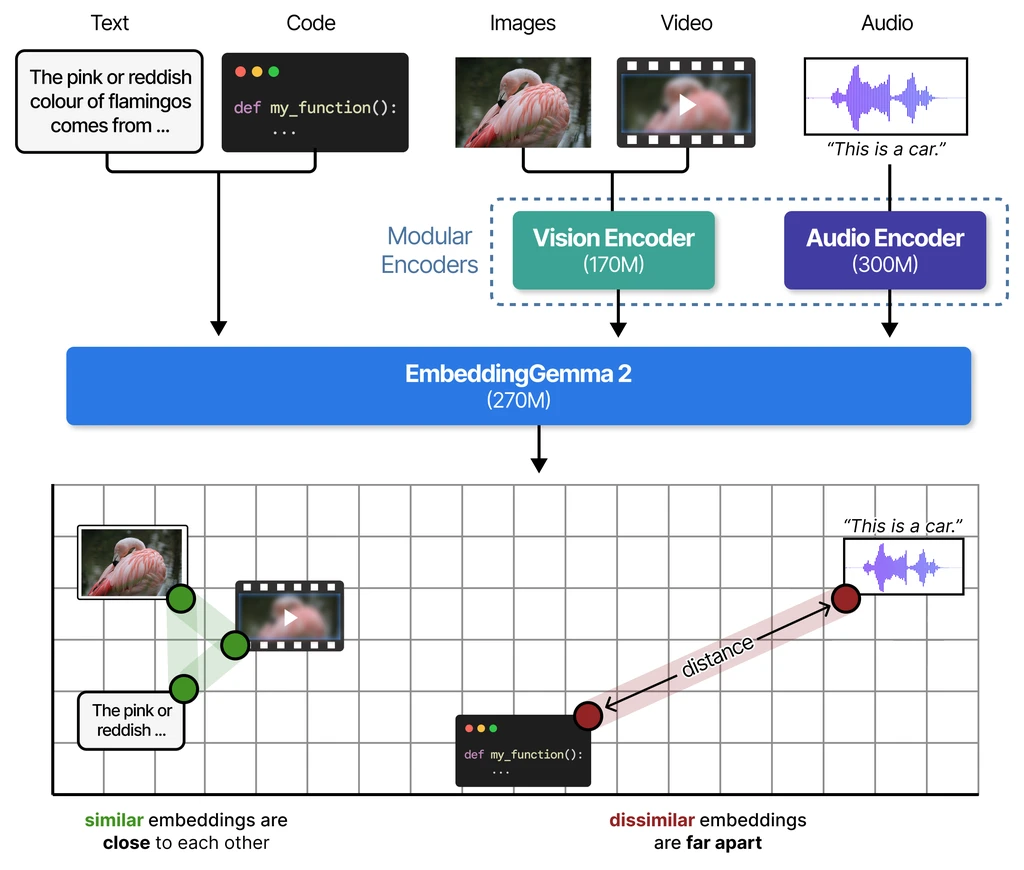
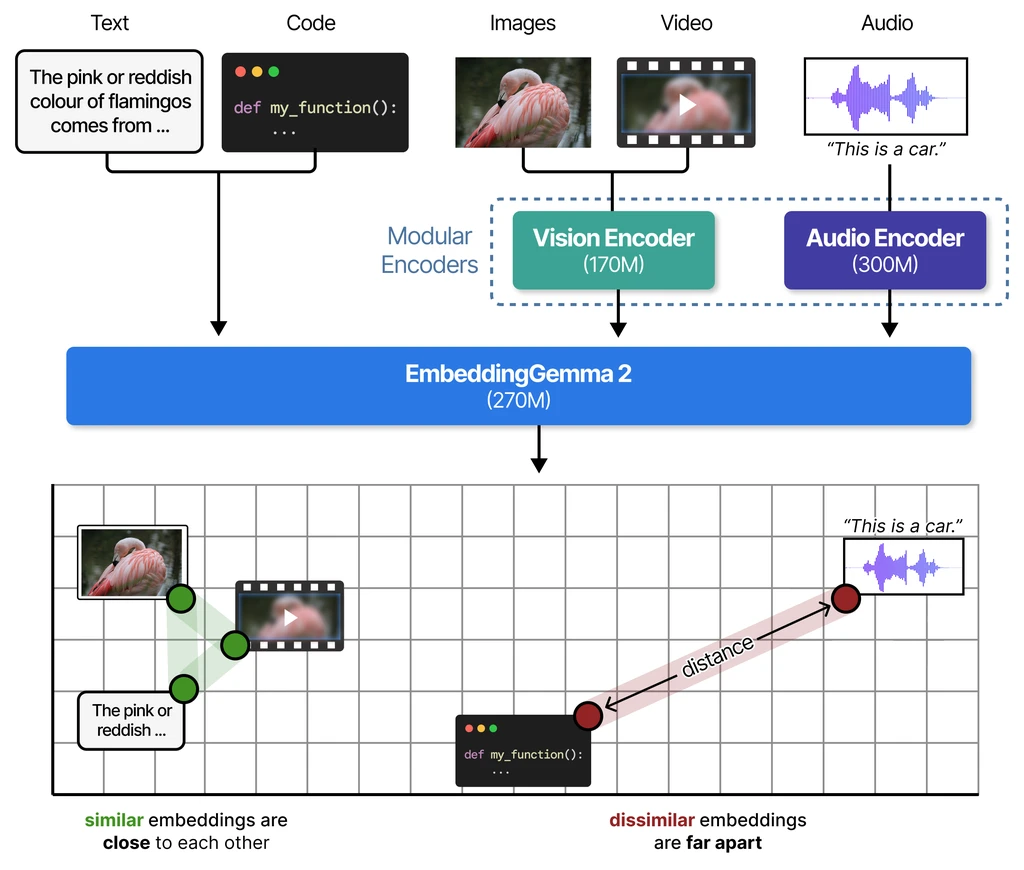
공식 개발자 가이드 (https://developers.googleblog.com/en/embeddinggemma-2-the-developer-guide/ (새 창))의 구성은 텍스트·코드 기본 모델 270M, 비전 인코더 170M, 오디오 인코더 300M이다. 전체를 사용하면 740M이며 사진과 영상만 추가하면 440M, 오디오만 추가하면 570M이다. M은 파라미터 백만 개를 뜻하며 실제 실행 메모리의 단위는 아니다.
공식 구조도를 보면 텍스트와 코드는 기본 모델로, 이미지와 영상은 비전 인코더로, 오디오는 오디오 인코더로 입력된다. 각 경로를 거친 입력은 같은 모델에 합류해 아래의 공통 공간에 배치된다. 초록색으로 모인 플라밍고 관련 자료와 멀리 떨어진 붉은 항목은 의미상 거리를 보여주는 개념 예시일 뿐, 실제 검색 정확도나 수치 축을 나타내는 그래프는 아니다.
같은 체크포인트의 인코더 구성은 벡터 공간을 공유한다. 미디어를 색인하는 작업에는 해당 인코더를 켜고, 텍스트 질문만 처리하는 검색 서버에는 기본 모델만 올릴 수 있다. 가이드는 동일 모델에서 나중에 인코더를 추가할 때 기존 임베딩을 다시 계산할 필요가 없다고 설명한다.
이 호환성을 EmbeddingGemma 1의 벡터까지 확대해서는 안 된다. 모델 교체와 동일 모델 내 인코더 추가는 다른 작업이다. 기존 1세대 색인을 그대로 섞기보다 2세대 색인을 별도로 만들어 같은 질문으로 비교하는 편이 안전하다. 색인 메타데이터에는 모델 버전·차원·입력 규칙을 함께 남겨 두어야 한다.
텍스트 변환을 줄이는 대신 미디어 분할을 설계한다
발표 (https://blog.google/innovation-and-ai/technology/developers-tools/embeddinggemma-2/ (새 창))가 제시하는 용도에는 텍스트 질문으로 오디오를 찾거나 음성 메모로 영상 구간을 찾는 검색이 포함된다. 모델은 답변을 생성하지 않고 입력의 의미를 벡터로 표현하므로, 검색 증강 생성(RAG)에서는 찾아낸 자료를 읽고 답하는 생성 모델을 별도로 연결한다.
사내 교육 자료를 검색할 때 녹음은 음성 인식으로, 슬라이드는 OCR로 텍스트를 만든 뒤 검색하는 기존 방식과 원본 오디오·슬라이드를 직접 임베딩하는 방식을 비교할 수 있다. 직접 임베딩이 유리한지는 표나 화면, 비언어적 소리처럼 텍스트 변환에서 빠지는 정보가 정답 탐색에 필요한지로 판단한다.
모든 입력은 8,192토큰 한도를 공유하며, 모델 카드 (https://ai.google.dev/gemma/docs/embeddinggemma/model_card_2 (새 창))의 미디어 한도는 입력 구성과 샘플링 조건에 묶여 있다. 긴 녹음 전체를 벡터 하나로 압축하기보다 답이 있는 구간으로 나누고 원문 시간대를 저장하는 방식을 비교할 수 있다. 반환 결과가 어느 시점의 발언인지 가리켜야 검색된 자료를 검증할 수 있다.
문자열 자체가 중요한 제품 코드나 오류 번호는 키워드 검색을 비교 대상으로 남겨 둔다. 텍스트 변환 방식은 발언 인용이나 정확한 문자열 확인에 유리할 수 있다. 두 접근의 결과를 합칠 때도 서로 다른 점수의 크기만으로 순서를 정하지 말고 실제 정답 자료가 상위에 놓이는지 평가해야 한다.
벡터를 줄일 때 미디어 검색의 손실을 따로 본다
공식 모델 카드 (https://ai.google.dev/gemma/docs/embeddinggemma/model_card_2 (새 창))의 출력은 기본 768차원이며 512·256·128차원을 지원한다. 앞부분의 작은 벡터도 활용하도록 학습하는 Matryoshka Representation Learning을 적용했다. 축소 뒤에는 L2 정규화가 필요하고 질문과 자료의 차원이 같아야 한다.
동일한 수치 형식에서 768차원을 128차원으로 줄이면 순수 벡터 저장량은 6분의 1로 줄어든다. 다만 전체 데이터베이스에는 검색 인덱스와 메타데이터, 원본 파일도 함께 저장되므로 전체 저장 공간이 같은 비율로 줄어들지는 않는다. 인코더 선택은 모델 실행 부담을, 차원 선택은 벡터 저장과 검색 부담을 조절한다.
모델 카드의 full-precision 체크포인트 평가에서 MMEB v2 Overall은 768차원 59.01, 256차원 56.24, 128차원 45.65다. 같은 표의 MTEB code v1 Mean(Task)은 각각 78.68, 76.18, 71.41이다. 두 벤치마크의 점수를 서로 우열 비교하지 말고 각 평가 안에서 차원 축소의 영향을 읽어야 한다. 128차원은 미디어 검색에서도 손실이 작다고 일괄 판단하기 어렵다.
이 수치는 Google의 벤치마크 평가 결과이므로 한국어 업무 자료의 검색 성공률과 다를 수 있다. 이미지·녹음·코드를 함께 다룬다면 자료 종류별로 정답 포함률을 집계하고 줄어든 저장량과 놓친 자료를 함께 비교해야 한다.
정규화가 필요한 이유는 작은 벡터로 계산해 보면 알 수 있다. 설명을 위한 3차원 벡터 (3, 4, 12)는 길이가 13이므로 정규화하면 (3/13, 4/13, 12/13)이다. 앞의 두 성분만 자르면 길이는 5/13으로 줄어든다. 이를 다시 정규화해야 (0.6, 0.8)이라는 단위 벡터가 된다. 잘라 낸 벡터를 그대로 내적하면 방향 유사도에 남은 벡터 길이까지 섞이므로, 코사인과 같은 의미로 읽을 수 없다. 이는 실제 모델의 임베딩 값이 아니라 연산을 설명하는 예시다.
문서 100만 개를 FP32로 저장한다고 가정하면 768차원은 1,000,000 × 768 × 4 = 3,072,000,000바이트이고, 128차원은 512,000,000바이트다. 이 계산에는 그래프 인덱스·ID·메타데이터가 빠져 있다. 별도 고정 공간이 2 GB라면 십진 단위의 전체 크기는 5.072 GB에서 2.512 GB로 줄어 약 50.5%를 절약한다. 벡터 자체의 83.3% 절약을 전체 저장소 절약률로 보고하면 실제와 차이가 크다.
정규화는 길이를 맞출 뿐, 잘라 낸 성분에 있던 구분 정보를 복구하지 않는다. 그래서 동일한 정규화 절차를 적용해도 차원별 검색 결과가 달라질 수 있다. 차원 축소는 저장 비용을 줄이는 선택이고, 필요한 정답이 남는지는 별도 평가로 확인해야 한다.
기존 검색이 놓치는 자료부터 시험한다
도입 시험에서는 같은 질문과 정답 자료를 고정한 뒤 기존 텍스트 변환 검색과 2세대 768차원 검색을 먼저 비교하고, 이어서 차원을 줄여 손실을 확인한다. 모델·차원·문서 분할을 한꺼번에 바꾸면 실패 원인을 분리하기 어렵다.
정답 상위 노출 여부와 함께 색인 시간, 질문 처리 지연, 최대 메모리, 자료 변경 시 갱신 비용을 기록한다. 로컬 실행은 외부 임베딩 호출을 줄이는 선택지지만 로그·원본 저장·후속 생성 단계가 어디에서 처리되는지는 별도로 확인해야 한다.
미디어에서 빠지는 정보가 현재 검색의 병목이고 목표 기기의 자원 조건을 충족한다면 도입할 이유가 있다. 텍스트 변환만으로 정답을 잘 찾거나 원문 구간을 안정적으로 연결하지 못한다면 기존 방식을 유지한다. 평가에는 서로 다른 자료 형식에 같은 답이 들어 있는 질문과, 비슷한 내용이지만 정답은 다른 질문을 함께 넣어 인코더와 차원을 고르는 근거로 삼는다.
참고 자료
EmbeddingGemma 2: an open, lightweight multimodal embedding model (새 창) — Sahil Dua · Henrique Schechter Vera, Google DeepMind, 2026년 10월 6일
EmbeddingGemma 2: The Developer Guide (새 창) — Maarten Grootendorst · Ian Ballantyne, 2026년 10월 6일
EmbeddingGemma 2 model card (새 창) — Google DeepMind