정답 풀이가 왜 불안정할까: LLM 학습 데이터의 분기 확률과 선택 비용
정답 풀이의 분기 확률과 학생 손실을 구분하고, 적은 표본에서 불확실성 점수가 흔들리는 이유를 계산한다. 학생 학습량 절약과 전체 생성·평가 비용도 나눠 본다.
정답인 풀이만 모으면 추론을 잘 가르칠 수 있을까. 한 번 성공한 풀이도 중간 단계에서 다른 선택을 하면 실패할 수 있다. LLM 추론 학습에서는 정답 여부와 함께 어디서 결과가 갈리는지 확인해야 한다.
아래 수치 예제는 원리를 설명하기 위한 가정이다. 해당 모델의 학습이나 하드웨어 성능을 직접 실험한 결과는 아니다.
한 번 맞힌 풀이와 안정적으로 맞히는 상태
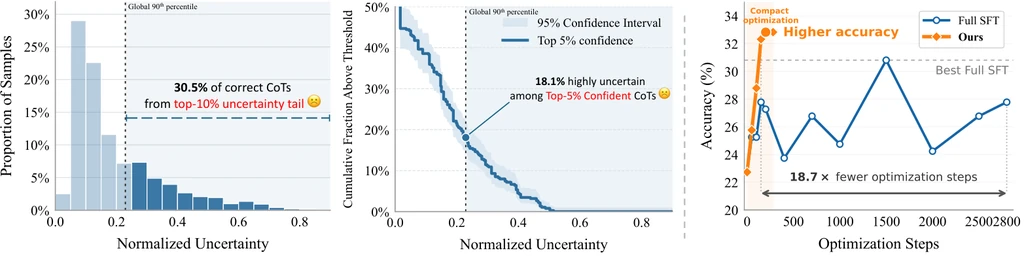
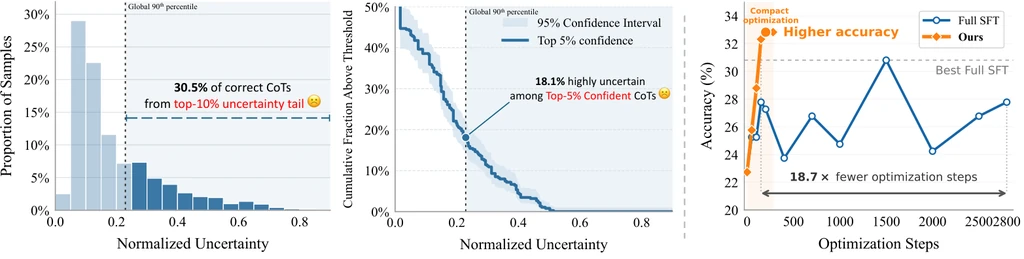
10월 9일 공개된 Learning More by Training Less 논문 (새 창)은 두 단계에 걸쳐 학습 대상을 추린다. 먼저 교사 모델이 만든 정답 풀이의 중간 상태에서 여러 갈래의 후속 풀이를 생성해, 성공과 실패가 엇갈리는 상태가 담긴 풀이를 남긴다. 이어서 학생 모델이 아직 제대로 익히지 못한 풀이에 학습을 집중한다.
이는 풀기 어려운 문제를 무조건 고르는 방식과는 다르다. 중간 상태에서 풀이를 이어갔을 때 정답에 도달할 확률을 p라고 하면, 논문은 불확실성을 U=4p(1-p)로 정의한다. 여기서 p는 모델이 내놓은 자신감이 아니라, 여러 번 생성한 답의 정오로 추정한다.
가상으로 같은 상태에서 후속 풀이를 8번 생성해 4번 성공하면 p=0.5, U=1이다. 1번만 성공하면 p=0.125, U=0.4375이고, 한 번도 성공하지 못하면 U=0이다. 마지막 상태가 가장 쉽다는 뜻은 아니다. 성공과 실패가 섞이는 정도와 실패율은 서로 다른 지표다.
| 정답 도달 확률 p | 불확실성 U와 해석 |
|---|---|
| 0 | 0 · 계속 실패하는 상태 |
| 0.5 | 1 · 성공과 실패가 섞이는 상태 |
| 1 | 0 · 계속 성공하는 상태 |
교사에게 유익한 풀이가 학생에게도 유익할까
학생 모델의 선택 기준은 정답 풀이의 응답 토큰에 대한 평균 음의 로그 확률, 곧 길이를 정규화한 손실이다. 교사가 남긴 후보 가운데 학생의 손실이 큰 풀이를 골라 후속 지도 미세조정(SFT)에 사용한다. 교사의 불확실성과 학생의 손실이 각기 다른 역할을 맡는 셈이다.
학습 계획을 세울 때도 후보를 추리는 과정과 그중에서 학습 대상을 고르는 과정을 나눌 수 있다. 예를 들어 수학 튜터에서 교사의 후속 풀이가 자주 갈리는 문제라도 학생은 이미 비슷한 풀이를 잘 익혔을 수 있다. 반대로 학생의 손실이 크다는 이유만으로 모든 문장을 남기면, 잘못된 정답이나 낯선 문체까지 학습 대상으로 고를 위험이 있다.
길이 정규화의 효과도 따로 떼어 볼 수 있다. 가상 풀이 A의 토큰이 100개이고 총 음의 로그 확률이 200이면 평균 손실은 2다. 풀이 B가 200개와 300이면 평균은 1.5다. 합계로는 B가 크지만 토큰당 기준으로는 A가 더 크다. 어느 풀이가 학생에게 낯선지 판단할 때 답변 길이에 덜 흔들리게 만든 장치이며, 높은 손실이 곧 올바른 교육 내용이라는 보증은 아니다.
불확실성 점수는 오류 검사를 대신하지 않는다
계속 실패하는 상태에서도 U가 낮게 나온다는 점에 주의해야 한다. 이 점수 하나만으로 학습 데이터를 고르면 반복해서 틀리는 문제를 뒤로 밀어낼 수 있다. 별도의 실패 문제 묶음을 남겨, 높은 불확실성을 고른 효과와 항상 틀리는 문제를 고친 효과를 나눠 봐야 한다.
정답 검증기도 선택 결과를 바꾼다. 같은 값을 다른 형식으로 적은 답을 오답으로 판정하면 p가 달라지고 학습할 풀이도 바뀐다. 숫자·단위·동치 표현을 처리하는 검증 규칙을 먼저 고정해야 한다.
후속 풀이 생성 횟수가 적으면 p의 추정치도 흔들릴 수 있다. 실무에 적용할 때는 같은 상태를 다시 표집해 선택된 풀이가 얼마나 달라지는지 확인하고, 표집 비용과 선택의 안정성을 함께 기록해야 한다. 표집 결과가 모였다고 해서 원래 추론 과정의 모든 분기를 찾았다고 볼 수는 없다.
실제 성공 확률이 0.1인 상태를 독립적으로 8번 표집할 때 성공을 한 번도 못 볼 확률은 0.9^8=약 43.0%다. 이 표본에서 추정한 U는 0이지만 실제 p로 계산하면 0.36이다. 작은 표본에서 나온 점수를 상태의 고정된 성질처럼 해석하면 우연에 따라 학습 후보가 바뀔 수 있다.
검증기가 정답 4개 중 1개를 형식 차이 때문에 오답으로 처리하는 가상 사례도 생각해 보자. 8개 중 성공 4개라던 결과가 3개로 줄면 p는 0.5에서 0.375로, U는 1에서 0.9375로 바뀐다. 점수 차이가 작더라도 후보를 순위대로 잘라 고르는 경계선에서는 선택이 뒤집힐 수 있다.
학생의 학습량과 전체 비용을 따로 계산하기
논문 표 1은 학습 예산을 전체 데이터 SFT 대비 학생이 누적 학습한 표본 수로 집계하며, Qwen3.5-4B·9B의 일부 설정에서 이를 0.22%로 보고한다. 교사의 생성과 중간 상태의 후속 풀이 표집까지 포함한 전체 비용이 0.22%라는 뜻은 아니다. 평가 조건은 3절과 표 1 (새 창)을 함께 확인해야 한다.
도입 효과를 비교하려면 전체 데이터, 같은 크기의 무작위 부분집합, 교사 기준만 적용한 부분집합, 학생 기준까지 적용한 부분집합을 나란히 평가해야 한다. 같은 초기 모델과 학습 설정에서 정답률뿐 아니라 검증 가능한 풀이와 반복 평가의 편차도 기록한다.
비용을 계산할 때는 교사 호출, 후속 풀이 표집, 학생 손실을 구하는 순전파, 실제 가중치 업데이트를 각각 포함해야 한다. 정답을 자동 검증하기 어렵거나 표집 비용이 아낄 수 있는 학습 비용보다 큰 작업이라면 도입을 보류해야 한다.
가상으로 전체 SFT가 100시간이고 선별 후 학생 업데이트가 0.22시간이더라도, 교사 생성·분기 표집·손실 평가가 30시간이면 총시간은 30.22시간이다. 전처리가 120시간이면 총 120.22시간으로 오히려 더 길어진다. 이는 같은 장비·비용 기준을 가정한 산술이며 논문 실측치를 환산한 결과는 아니다.
학습량을 줄이기 전에 무엇을 놓치는지 봐야 한다
추론 미세조정에서는 정답 데이터의 양만 세기보다 풀이가 갈리는 상태와 학생이 아직 익히지 못한 부분을 나눠 기록해야 한다. 선택에서 빠진 실패 문제를 별도로 평가하고 전체 생성·학습 비용까지 비교해야, 적은 데이터로 얻은 점수가 실제 학습 개선인지 판단할 수 있다.