Opus 5.5 완료율은 누구의 성능인가: 대체 모델과 성공당 비용
100개 과제의 직접 완료·전환 완료·미완료를 나누어 전체 완료율과 성공당 비용을 계산한다. 평가 각주의 실행 구성이 배포 판단에 미치는 영향을 설명한다.
Anthropic은 2026년 9월 22일 Opus 5.5 발표 (https://www.anthropic.com/claude-opus-5-5 (새 창))에서 평가별 실행 조건을 공개했다.
점수 옆 각주에 있는 모델 전환
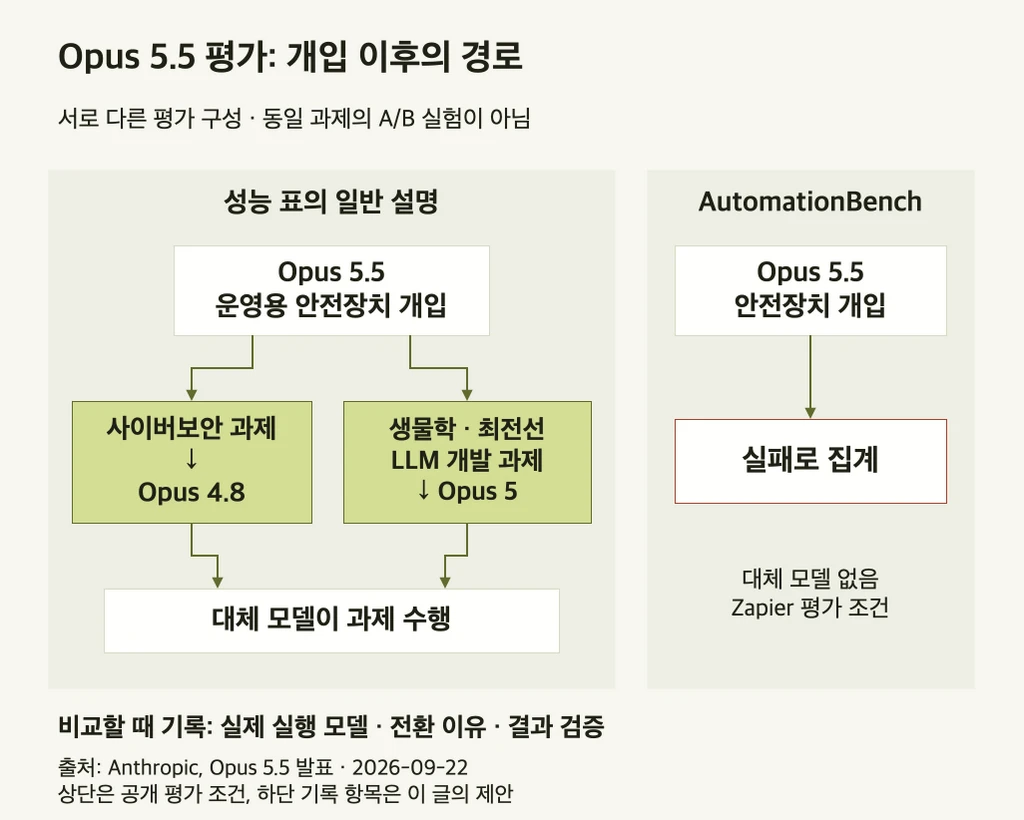
발표된 성능 표 설명에 따르면, Opus 5.5 평가는 운영용 안전장치를 켠 상태에서 진행됐다. 평가 중 안전장치가 개입하면 사이버보안 과제는 Opus 4.8이, 생물학과 최전선 LLM 개발 과제는 Opus 5가 넘겨받아 수행했다. 반면 Zapier의 AutomationBench 평가는 대체 모델 없이 실행했고 안전장치 개입을 실패로 집계했다.
대체 모델은 원래 모델이 작업을 이어가지 못할 때 대신 실행하는 모델이다. 그림은 공개된 평가 조건을 재구성한 것일 뿐, Anthropic 내부 라우터나 모든 API 요청의 동작 방식을 뜻하지는 않는다.
과제와 채점 방식이 다른 두 평가만으로 전환 효과를 계산할 수는 없다. 다만 같은 모델 이름 아래에서도 실제 실행 구성은 달라질 수 있다는 점이 확인된다.
주 모델의 성능과 전체 서비스의 성능
단일 모델 평가는 정해진 도구와 예산 안에서 해당 모델이 해결한 과제 수를 센다. 여기에 대체 모델을 허용하면 전환 조건과 연결된 다른 모델도 결과에 기여하게 된다. 서비스가 실제로 그 구성을 쓴다면 전체 결과를 평가하되, 이를 주 모델 하나의 능력으로 해석하지 않아야 한다.
예를 들어 내부 코드 검토 서비스를 새 모델로 교체하는 상황을 가정해 보자. 공개 평가에는 대체 경로가 있었지만 사내 서비스에는 승인된 모델 하나만 연결돼 있다면, 평가와 같은 완료율을 기대하기는 어렵다. 반대로 이미 여러 모델을 조합해 운영하는 팀이라면 단일 모델의 완료율만 비교해서는 실제 서비스의 품질과 비용을 가늠하기 어렵다.
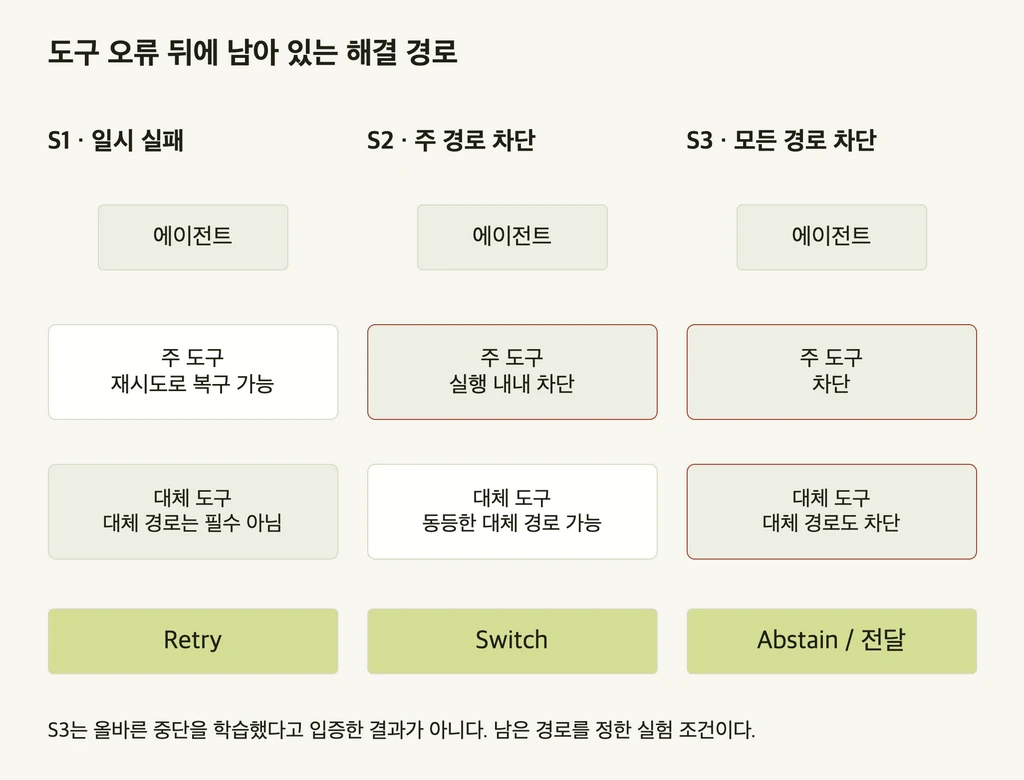
안전장치 개입과 일반 실행 오류도 분리해서 본다. 일시적인 통신 장애에 쓰는 재시도 규칙을 안전장치 개입에 그대로 적용해서는 안 된다. 허용된 작업인지 먼저 판단하고, 승인된 대체 경로가 없다면 작업 중단이나 사람 검토로 넘기는 절차를 서비스의 정상 결과로 정의할 수 있다. 평가표에서 실패로 집계된 사건이 실제 운영에서 어떤 의미를 갖는지 해석하려면 이 구분이 필요하다.
완료율을 세 항목으로 분해하기
평가 기록은 주 모델 직접 완료, 승인된 전환 뒤 완료, 미완료를 구분해 남긴다. 작업마다 최종 실행 모델과 전환 이유, 결과 검증 여부도 함께 저장한다. 같은 요청을 재시도하더라도 작업 식별자를 그대로 유지해 단순 호출 수가 완료 건수로 집계되지 않게 한다.
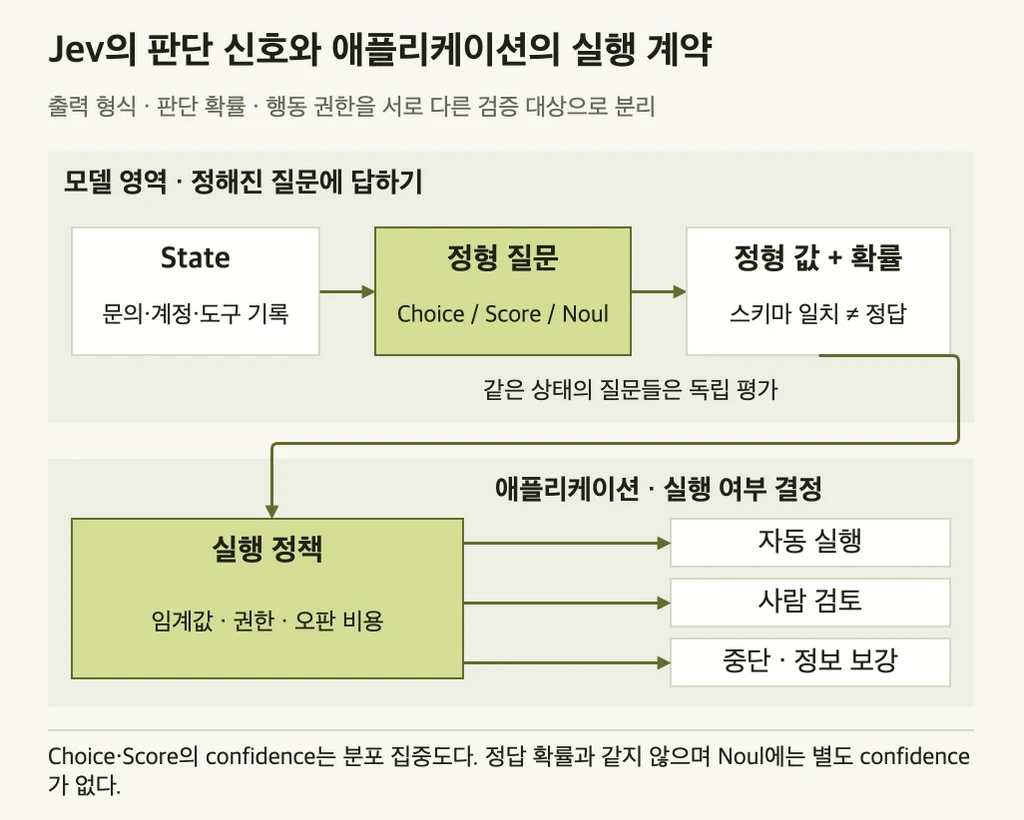
허용된 과제만 모은 평가셋이라면 전체 완료율은 다음과 같이 분해할 수 있다. 전체 과제 수를 N, 주 모델이 직접 완료한 수를 D, 전환한 뒤 완료한 수를 F라고 두면 완료율은 (D + F) / N이다. 이때 D와 F는 서로 겹치지 않아야 하며, 전환이 필요했던 과제 중 몇 건을 복구했는지도 별도로 본다. 전체 완료율만 높고 D가 줄었다면 주 모델이 개선됐다고 결론 내릴 수 없다.
금지된 요청이 섞인 안전 평가에는 이 식을 그대로 쓰지 않는다. 안전 평가에서는 올바른 거절도 성공으로 보며, 작업을 끝냈더라도 정책을 어겼다면 실패가 될 수 있다. 따라서 업무 완료 기준과 정책 준수 기준을 먼저 정한 뒤 실행 기록을 채점해야 한다.
비용은 실패한 첫 시도까지 포함해 합산한다. 뒤 모델의 응답이 짧아도 전환 전 추론과 도구 호출이 이미 비용을 썼을 수 있다. 지연 시간 역시 첫 요청부터 최종 검증까지 측정하고, 직접 완료와 전환 완료를 나눠 확인한다.
허용된 업무 100개를 대상으로 한 가상 결과를 보자. 기존 구성은 직접 완료 80개, 미완료 20개이고, 새 구성은 직접 완료 70개, 승인된 전환 뒤 완료 20개, 미완료 10개다. 전체 완료율은 80%에서 90%로 올랐지만 주 모델의 직접 완료율은 80%에서 70%로 낮아졌다. 새 구성에서 직접 끝내지 못한 30개를 모두 전환했다면 전환 복구율은 20/30≈66.7%다. 이 수치는 Anthropic의 실제 측정 결과가 아니라 기록을 읽는 방법을 보여주기 위한 예시다.
첫 시도의 가상 비용이 1이고 전환 시도가 2라면, 총비용은 기존 구성이 100, 새 구성이 100+30×2=160이다. 성공당 비용은 100/80=1.25에서 160/90≈1.78로 늘어난다. 이는 실제 가격이나 특정 모델의 비용 전망이 아니다. 완료율만 보면 새 구성이 우수하지만, 성공 한 건을 더 확보하는 데 드는 비용까지 따져보면 서비스 예산에 따라 판단이 달라진다. 실패한 전환 10개도 비용 분자에는 포함한다.
모델만 바꾼 실험부터 비교하기
배포 전 비교에서는 동일한 과제 묶음에 도구 권한, 제한 시간, 결과 검증기를 똑같이 맞춘다. 기존 모델만 쓰는 구성과 새 모델만 쓰는 구성을 비교하면 모델 교체의 영향을 살필 수 있다. 이어서 실제로 도입할 승인된 대체 경로를 붙여 전체 서비스가 요구 조건을 만족하는지 확인한다. 모델과 전환 규칙을 동시에 바꿨다면 그 결과는 서비스 구성의 변화로 보고한다.
직접 완료율이 떨어져도 전환으로 전체 완료율이 오를 수 있다. 이것이 항상 나쁜 선택은 아니다. 다만 늘어나는 지연과 비용이 예산 범위 안에 있고, 전환 과정에서 데이터 처리·도구 권한 조건이 그대로 유지되며, 최종 산출물을 같은 기준으로 검증할 수 있어야 도입 근거가 된다.
대체 모델을 쓸 수 없거나 실행 모델을 기록하지 못한다면 전체 완료율이 왜 개선됐는지 설명하기 어렵다. 이때는 단일 모델 구성을 기준으로 판단하고, 전환을 포함한 성능 주장은 보류하는 편이 낫다. 또한 드물게 일어나는 전환이 특정 업무에 몰릴 수 있으므로 전체 평균 외에 업무 유형별 결과도 함께 확인한다.
전환 효과는 공개 자료만으로 알 수 없다
이번 발표에는 평가의 과제별 전환 기록이나 전환만 제거한 대조 실험이 없다. 대체 모델이 몇 점을 보탰는지, 같은 구성이 국내 업무 데이터에서도 유리한지는 이 자료만으로 확인할 수 없다.
배포 비교표에는 전체 완료율 옆에 직접 완료율·전환 완료율·성공당 비용을 함께 남기는 것이 좋다. 실행 모델과 전환 규칙까지 기록해 두어야 다음 변경 때 모델 자체가 좋아진 것인지, 대체 경로에 더 의존하게 된 것인지 구분할 수 있다.
참고 자료
Claude Opus 5.5 — Anthropic (https://www.anthropic.com/claude-opus-5-5 (새 창)), 2026년 9월 22일. Performance and cost-effectiveness의 표 설명과 AutomationBench 각주를 기준으로 검토했습니다.