SlideOn은 무엇을 지워 검색을 줄일까: 희소 내적과 역색인의 비용
작은 희소 벡터의 내적을 계산해 질문과 문서 가지치기가 순위를 바꾸는 과정을 살핀다. 역색인 저장량과 목록 길이, 실제 지연을 구분하고 현재 평가 인수도 확인한다.
검색 벡터에서 작은 값을 지우면 검색이 얼마나 빨라지고 어떤 문서를 놓치게 될까. 질문과 문서 양쪽을 모두 희소하게 만들 수 있지만, 같은 개수를 남겨도 검색 순위에 미치는 영향은 다르다. 질문은 읽을 특징 목록을 고르고, 문서는 그 목록 안에 남을 항목을 정하기 때문이다.
작은 내적 계산으로 SlideOn의 역색인을 따라가 보자. 아래 벡터와 시간은 설명을 위한 가정이며 모델을 실행해 얻은 값이 아니다. 원자료의 검색 품질과 비용 지표는 별도로 살펴본다.
겹치는 특징의 곱을 더해 문서 점수를 만든다
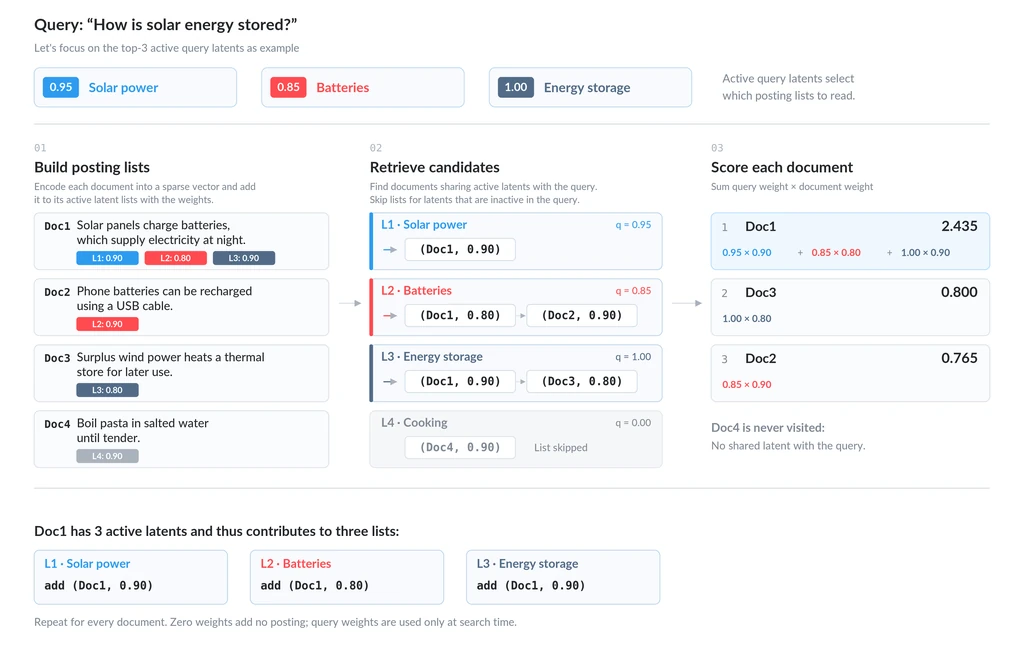
공식 발표 (새 창)에 따르면, 문맥 임베딩을 희소한 특징으로 바꾼 뒤 토큰 간 풀링을 거쳐 질문·문서 벡터를 만든다. 이때 특징 번호는 원문 단어와 일대일로 대응하는 사전 항목이 아니다. 역색인은 각 특징을 가진 문서와 가중치를 특징별로 저장한다.
가상 질문을 q=(2,1,0), 문서 A=(1,3,0), 문서 B=(2,0,1)로 놓자. 내적 점수는 A가 2×1+1×3=5, B가 2×2=4다. 질문의 첫 번째 특징 목록에는 A와 B가 있고, 두 번째 목록에는 A가 있다. 두 목록에서 얻은 곱을 문서별로 합산하면 A가 앞선다.
질문에서 가장 큰 값 하나만 남기면 q=(2,0,0)이 된다. A의 점수는 2, B는 4가 되어 순위가 뒤집힌다. 삭제한 질문 가중치 1은 작아 보여도, A의 해당 가중치 3과 곱해져 정답 순위를 지탱하던 신호였던 셈이다. 큰 값만 남기는 기준과 관련 문서를 보존하는 기준은 완전히 같지 않다.
문서를 줄이면 저장하는 목록 자체가 달라진다
이번에는 원래 질문을 유지하고 문서마다 큰 값 하나만 남긴다고 해 보자. A는 (0,3,0), B는 (2,0,0)이 되어 점수는 각각 3과 4가 된다. 이번에도 B가 앞서지만, 질문 가지치기와 달리 색인에서 A의 첫 번째 특징 항목 자체가 사라진다. 질문만 바꾸는 시험과 문서 벡터를 바꾸는 시험은 원상 복구 작업도 다르다.
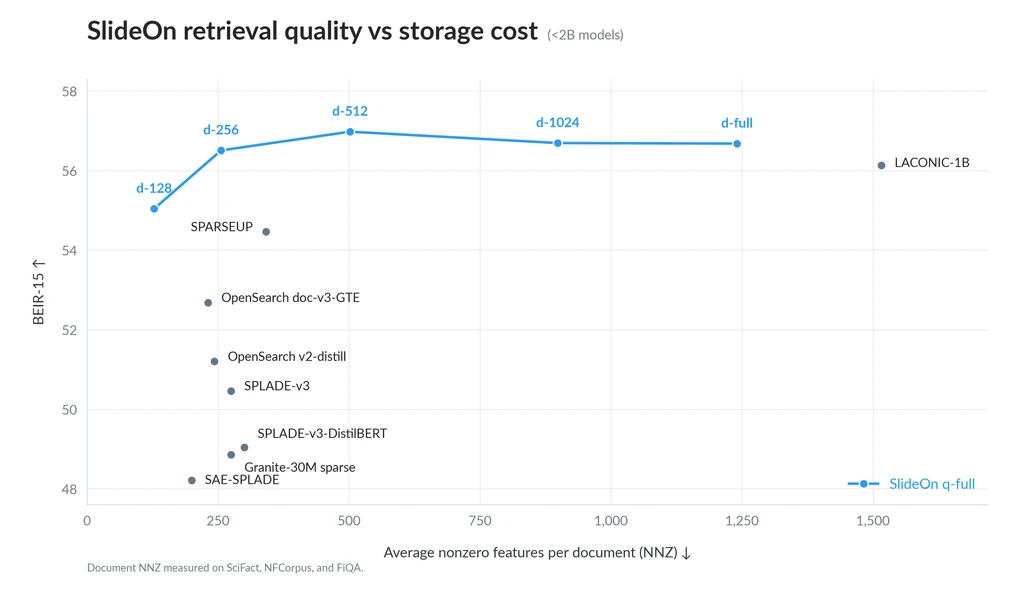
단순한 가상 색인에서 문서 100만 개에 평균 512개의 특징을 저장하고, 항목 하나를 문서 ID 4바이트와 가중치 4바이트로 잡으면 항목 공간은 4.096GB다. 평균 256개라면 2.048GB다. 이는 압축·사전·목록 헤더·정렬·복제 등을 제외한 십진 바이트 계산이므로 실제 색인 크기 예측값은 아니다.
문서 쪽 가지치기는 기존 색인을 바꾸는 비용과 새 문서가 들어올 때의 처리 과정에도 영향을 미친다. 반면 문서 표현을 고정한 채 질문 쪽만 비교하면 같은 색인을 재사용하며 바로 시작할 수 있다. 두 설정을 동시에 바꿔 점수가 떨어지면 어떤 신호를 지워서 생긴 손실인지 분리하기 어렵다.
특징 개수만큼 중요한 것은 목록의 길이다
질문 특징 두 개의 목록 길이가 각각 100과 100만이라고 가정하자. 모든 항목을 단순 순회하는 검색기에서는 두 번째 특징을 없애면 읽을 항목이 크게 줄지만, 첫 번째를 없애면 거의 변하지 않는다. 실제 검색기는 건너뛰기·가지치기·압축을 쓰기도 하므로 활성 특징 개수만으로 벽시계 시간을 예측할 수는 없다.
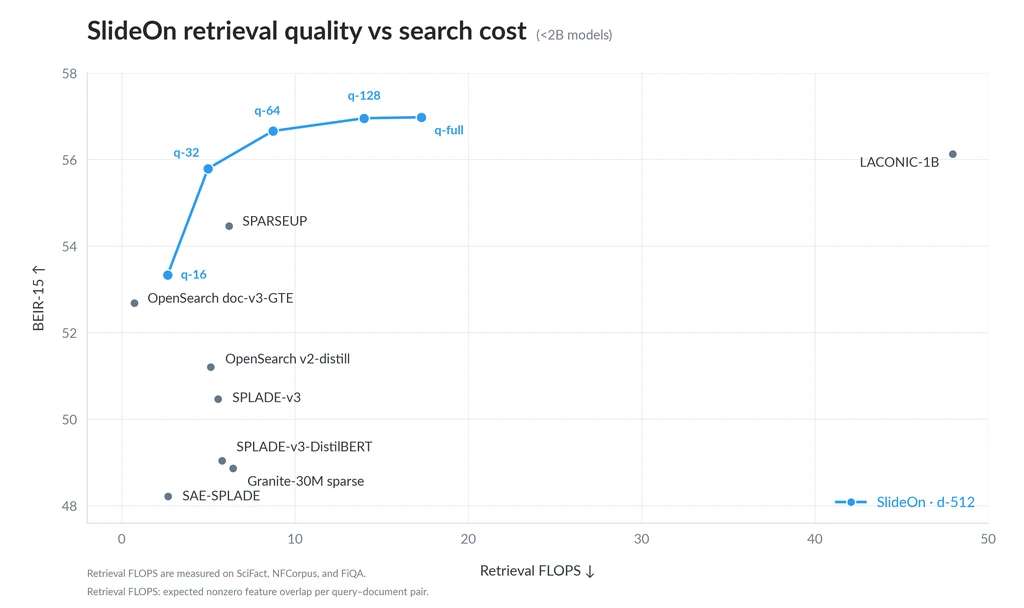
아래 공식 그림은 문서를 d-512로 고정하고 질문을 q-16부터 q-full까지 바꾼 결과다. 세로축은 BEIR-15 평균 nDCG@10이고, 가로축은 SciFact·NFCorpus·FiQA에서 계산한 retrieval FLOPS다. 이는 질문·문서의 활성 특징이 겹치는 정도를 바탕으로 한 비용 지표이며, 인코더의 전체 연산량이나 밀리초 단위 지연 시간이 아니다.
가상 요청에서 질문 인코딩이 40ms, 색인 검색이 10ms라면 검색을 5ms로 줄여도 전체 시간은 50ms에서 45ms가 된다. 검색 부분의 두 배 개선이 전체 요청에서는 약 1.11배에 그치는 셈이다. 이는 그림의 실측 시간을 환산한 결과가 아니라, 비용 지표와 사용자 대기 시간을 구분해 읽기 위한 예시다.
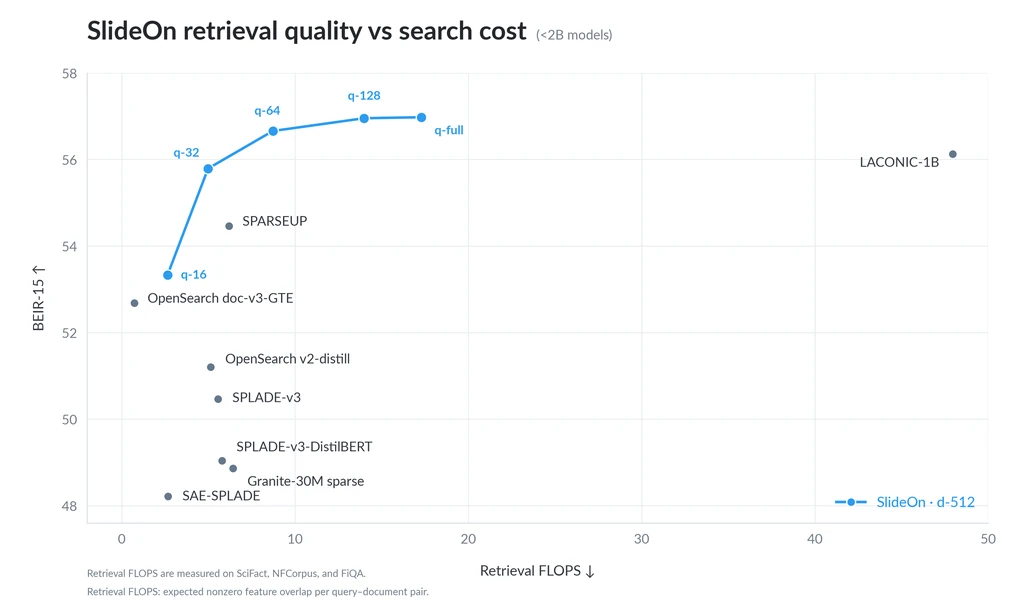
평가 명령의 가지치기와 운영 색인의 속도를 구별한다
현재 공식 평가 안내 (새 창)는 정확한 내적 검색을 사용하며 기본 벡터는 가지치기하지 않는다고 설명한다. 최종 가지치기 인수는 --query-max-active-dims와 --document-max-active-dims다. 토큰별 활성 개수를 다루는 token_k와 풀링 이후 벡터를 제한하는 것은 서로 다른 단계다. 이전 안내에 있던 --query-top-k와 --document-top-k를 그대로 복사하지 말고, 설치한 리비전의 도움말과 대조해 맞춰야 한다.
summary.json의 점수는 0–1 척도이므로 공식 발표의 0–100 척도와 구별한다. 예를 들어 0.55와 55는 척도를 맞추면 같은 값이다. 또한 저장소는 일부 과거 데이터 리비전을 구할 수 없어 공개 수치의 완전한 재현이 확립되지 않았다고 밝힌다. 이 코드의 순위 평가가 운영 역색인의 지연 측정을 대신하지는 않는다.
따라서 같은 문서·질문·모델 환경에서 문서 설정을 고정한 질문 비교와 질문 설정을 고정한 문서 비교를 먼저 나누어 진행하고, 마지막에 두 설정을 조합한다. 정확한 오류 코드 질문과 표현이 다른 증상 질문에서 누락된 정답을 따로 살펴보면, 절약한 특징이 어떤 역할을 했는지도 확인할 수 있다.
줄어든 저장량과 사라진 정답을 함께 기록한다
ColGrep-Agent 글과 마찬가지로 비용 대용 지표와 실제 대기 시간은 구분해서 읽어야 한다. 희소 검색에서는 같은 장비와 부하 조건에서 질문 인코딩, 목록 탐색, 후속 재순위화를 나누어 기록하면 어디서 시간이 줄었는지 알 수 있다. 문서 설정을 변경할 때는 색인 재구축과 갱신 비용도 함께 포함한다.
질문 가중치가 작다고 해서 중요하지 않은 것은 아니며, 특징 개수가 적다고 목록이 짧은 것도 아니다. 어떤 내적 항을 지웠는지와 어떤 목록을 덜 읽게 됐는지를 함께 추적해야 품질과 비용의 맞교환을 설명할 수 있다. 영어 평가의 한 지점을 한국어 사내 검색의 최적값으로 그대로 삼을 근거는 이 글에 없다.