같은 500 오류에도 다른 복구가 필요한 이유: 재시도·전환·중단
Bench2Robust의 S1·S2·S3를 실제 호출 흐름으로 구분한다. 재시도 확률 계산이 성립하는 조건과 이미 처리된 쓰기 요청의 중복 실행 위험을 설명한다.
2026년 8월 12일 공개된 Bench2Robust 연구는 7개 모델, 4개 계열, 10개 과제·도메인 묶음을 조합한 70개 조건을 비교했다. 그중 69개에서 오류를 주입한 뒤 성능이 떨어졌다. 장애가 없는 벤치마크의 높은 통과율만으로는 도구 장애 복구력을 판단하기 어렵다.
복구 정책과 우연한 성공 구분하기
Bench2Robust는 평가 환경에서 원래 경로를 회복할 수 있는지, 대체 경로가 남았는지, 모든 경로가 막혔는지를 미리 고정한다. 같은 요청을 반복하다 우연히 성공한 실행과 상황에 맞춰 복구한 행동을 구분하기 위해서다.
실무에서는 대체 경로 맵과 검증 제약을 실행 문맥에 먼저 넣어 주고, 오류 주입 평가로 재시도·전환 성능을 측정한 뒤 RL을 검토한다. 초기 개선 폭이 가장 컸던 요인은 재학습이 아니라 구조화된 복구 정보였다.
주입한 오류와 실험 범위
Amazon 연구진은 failure-free tool-use benchmark를 제어된 stochastic environment로 변환하는 Bench2Robust를 제안했다. 실험에는 τ²-bench, Retail-3I, Airline-3I, BFCL multi-turn을 사용했고, 핵심 intervention 비교는 Combined Retail 1,339개 task 중 held-out 402개 task와 5개 injection seed로 수행했다.
오류 주입기는 도구 응답 시 60% 확률로 clean response를 반환하고, 나머지 40%를 9개 failure mode에 배분한다. timeout·rate limit·server error·malformed response·auth error·schema drift는 에이전트가 오류 신호를 직접 확인할 수 있다. 반면 partial data·stale value·factual error는 형식상 정상으로 보이는 silent error이므로 검증이나 교차 확인이 필요하다.
도구 실패를 복구 가능성으로 나눈다
상태를 구분하는 기준은 오류 코드가 아니라 남아 있는 해결 경로다. 공식 자료 1 (https://arxiv.org/abs/2608.11977 (새 창)) · 공식 자료 2 (https://arxiv.org/html/2608.11977v1 (새 창))
무작위 오류만 주입하면 다음 호출에서 장애가 우연히 사라질 수 있어, 무조건 재시도하는 정책도 좋아 보이기 쉽다. 반대로 적절한 복구 행동을 골라도 오류가 계속 발생하면 낮은 보상을 받을 수 있다.
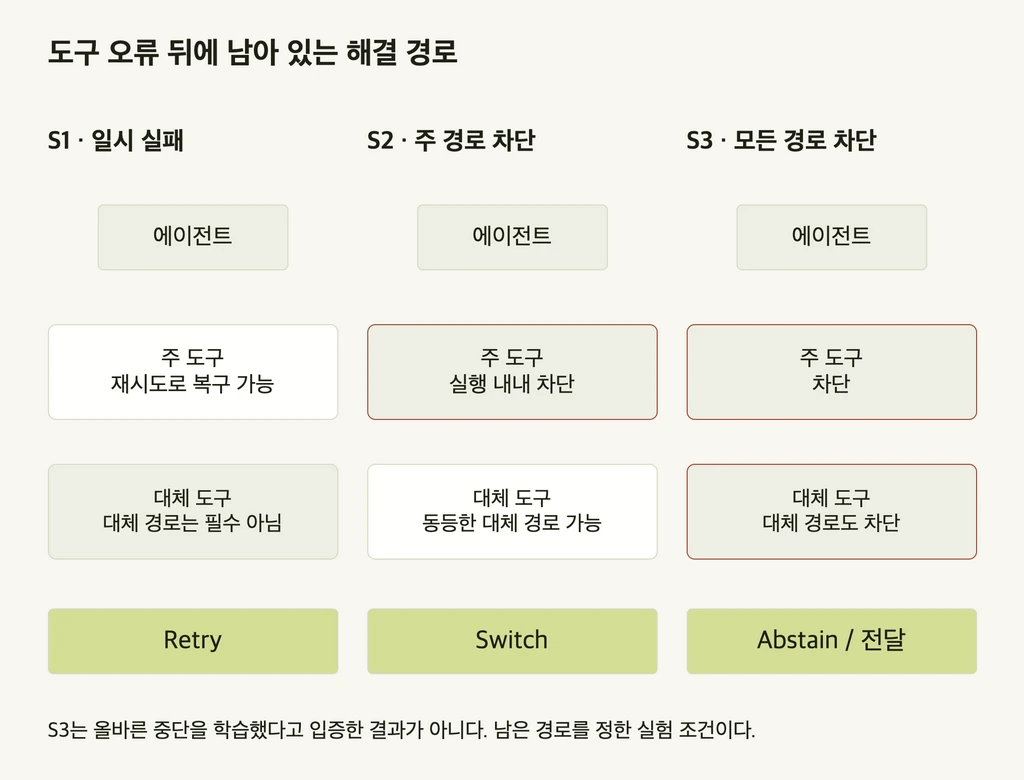
그래서 Bench2Robust는 실행마다 해결 가능 상태를 고정한다. S1은 경로를 영구 차단하지 않으므로 원래 도구를 재시도할 수 있다. S2는 주 경로를 실행 내내 차단하므로 같은 기능의 대체 도구로 전환해야 한다. S3는 모든 경로를 차단하므로 실행을 중단하거나 사람에게 넘겨야 한다.
같은 HTTP 500이라도 일시 장애라면 재시도 대상이지만, 실행 내내 막힌 경로라면 전환 대상이다. 정상 JSON 응답이라도 핵심 값이 오래됐다면 검증이 필요하다.
| 상황 | 대응 |
|---|---|
| S1 · 원래 경로 회복 가능 | 원래 경로 재시도 |
| S2 · 원래 경로 차단 | 동등한 대체 도구로 전환 |
| S3 · 모든 경로 차단 | 중단하거나 사람에게 전달 |
BTM은 확률보다 구조가 핵심이었다
Bayesian Tool Memory(BTM)는 도구·오류별 복구 가능성 통계와 도메인별 대체 경로 맵, 실행 제약을 제공한다. 제약에는 재시도 전 성급히 포기하지 않기, 비가역 행동 전 정보 확인하기, 모든 경로를 검토한 뒤 사람에게 넘기기가 포함된다.
held-out Retail에서 base model의 pass rate는 오류 주입·대체 경로 없음 조건에서 20.1%, 대체 경로 있음 조건에서 31.9%였다. inference 시점에 BTM만 추가해도 각각 36.9%, 43.6%를 기록해 +16.8%p와 +11.7%p 올랐다. 모델을 재학습하지 않고 도구별 복구 구조(tool-specific recovery structure)를 명시하는 것만으로 얻은 효과다.
다만 확률 추정 자체보다 구조 정보가 핵심이었다. 전체 Retail 1,339개 과제를 분해한 실험에서 제약과 대체 경로 맵만 남긴 Static only가 전체 BTM 개선폭 14.6%p 중 10.5%p를 차지했다. posterior value를 무작위로 섞어도 true value와 shuffled value의 차이는 seed variation 이내였다. 정교한 확률 값보다 실행 가능한 대체 경로와 제약 조건의 효과가 더 컸다.
RL은 switch와 silent error를 보완했다
Qwen3-4B-Thinking-2507에 scenario curriculum과 DAPO를 적용한 RL policy는 inference-time BTM 없이도 26.4%와 38.8%를 기록해 base보다 각각 +6.3%p, +6.9%p 높았다. RL과 BTM을 함께 쓰면 40.8%와 45.5%로 가장 높았고, clean pass rate는 63.9%로 base(64.3%)와 비슷했다.
두 방법이 기여한 영역은 서로 달랐다. BTM은 timeout·rate limit·server error처럼 명시적인 transient error에서 큰 폭으로 성능을 높였다. 반면 RL의 추가 이득은 auth error·schema drift처럼 지속되는 observable error와 stale·factual error 같은 silent error에서 더 두드러졌다. 특히 factual error에서는 BTM만 넣었을 때 -4.6%p였으나 RL을 더하자 +10.5%p가 추가됐다.
다만 중간 행동을 직접 측정하지는 않았기 때문에 RL이 검증이나 교차 확인을 실제로 학습했는지는 확정할 수 없다. 정책마다 방문한 S1·S2 실행 구성도 달라서 전략별 수치를 직접적인 인과 효과로 단정할 수는 없다.
배포 전 판단 기준
장애 없는 평가와 오류 주입 평가를 분리한다. 실제 연동에서 발생하는 timeout, 429, 5xx, 권한 오류, 스키마 변경은 물론, 형식은 정상이지만 일부만 담긴 부분 응답·오래된 값·잘못된 값도 시험 입력에 포함한다.
도구 등록 정보에는 동등한 대체 경로와 검증 규칙을 명시한다. 다른 질의 방식으로 같은 데이터를 읽는 도구, 쓰기 후 재조회, 비가역 작업 전 확인 경로를 먼저 구성한 뒤 RL 적용을 검토한다.
재시도 예산과 사람에게 넘길 조건은 과제별로 설정한다. S1에서 성급하게 경로를 전환하면 비용이 늘고, S2에서 호출을 반복하면 지연이 길어진다. S3에서 시도를 멈추지 않으면 요청 제한에 걸리거나 중복 실행 위험이 커진다. 따라서 통과율과 함께 도구 호출 수·토큰·지연·성급한 중단을 함께 기록한다.
단순한 확률 예제를 보자. 매 호출이 서로 독립적으로 0.6의 확률로 성공하는 읽기 도구라면, 세 번 이내에 한 번 이상 성공할 확률은 1−0.4³=0.936이다. 그러나 영구 차단된 경로에서는 세 번을 호출해도 성공 확률이 0이다. 앞선 계산을 영구 차단 경로에 그대로 적용하면 재시도 예산을 늘리는 것만으로 복구된다고 오판하게 된다. 이는 독립 시행을 가정한 설명용 계산이며 논문의 전체 오류 주입 정책과 같은 모형은 아니다.
쓰기 도구는 한층 더 조심스럽다. 주문을 생성한 뒤 응답만 유실됐다면 ‘응답 없음’이 곧 ‘주문 없음’을 뜻하지는 않는다. 동일한 요청 식별자로 처리 결과를 먼저 조회하고, 서버가 멱등성을 보장하는 범위 안에서만 재시도해야 한다. 대체 도구로 전환할 때도 원래 주문이 이미 생성됐는지 먼저 확인해야 한다. 이런 조건 없이 통과율만 평가하면 중복 주문을 만든 실행까지 성공으로 집계할 수 있다.
검증용 기록에는 최초 오류, 재시도 횟수, 대체 경로의 동등성, 최종 상태와 중복 효과를 남긴다. S3에서 정확히 중단한 실행은 과제 완료율과 별도로 평가한다. 업무를 끝마치지 못했더라도 금지된 쓰기를 실행하지 않고 사람에게 필요한 상태를 전달했다면, 복구 정책의 일부는 올바르게 작동한 것이다.
중단 행동의 학습까지 입증한 것은 아니다
이 실험의 실패 환경은 실제 운영 사고가 아니라 sandbox 벤치마크에 주입한 모의 상황이다. 개입 비교 또한 구성 전체를 단위로 삼았기 때문에 curriculum, 보상 설계, BTM 요소 각각의 인과 효과를 분리하지 못했다. 특히 S3에는 올바른 중단에 대한 양의 보상이 없어 에이전트가 중단 행동을 학습했다고 입증하지 못했다.
복구 평가를 설계할 때는 S1·S2·S3를 분리해 측정해야 한다. 원래 경로 회복, 대체 경로 전환, 올바른 중단을 구분해야만 무조건 반복 시도하는 에이전트와 상황에 맞게 복구하는 에이전트를 가려낼 수 있다.